AIコーディングツールをめぐる議論は、多くの企業で「役に立つのか」から「コードがどこへ行くのか」へと移っています。データ主権やデータレジデンシー、規制上の制約を抱えるチームにとって、自社のソースコードがどのネットワークで処理されるのかは、導入を検討する前に確認しておくべき前提条件です。この問いに答えるのがGitLab Duo Self-Hosted。管理者は、自ら選んだインフラ上で動くモデルにGitLab Duoの機能を接続し、ホスティング先、リージョン、通信経路、認証情報のすべてを自社で管理できます。
このチュートリアルでは、Microsoft Foundry上でホストされているモデルにGitLab Duo Self-Hostedを接続します。まず押さえておきたいのが、FoundryをOpenAIのエンドポイントではなく、汎用のモデル提供プラットフォームとして捉える視点。カタログにはOpenAIのGPT、AnthropicのClaude、MetaのLlama、Mistralが並び、GitLabがサポートするファミリーとの重なりも大きくなっています。
この重なりが効いてくるのは、GitLabが機能単位でモデルを割り当てられるからです。エージェント型の処理には特定のファミリー、コード提案にはコードに最適化されたモデル、リクエスト量が支配的な用途には小型のモデル。こうした使い分けを、1つのAzureサブスクリプションでのデプロイと課金にまとめられます。
設定の手順は、ファミリーが変わっても同じです。違うのは、デプロイするモデル、参照するデプロイ名、そしてGitLab側で選ぶモデルファミリーの3点だけです。
ただし、Microsoftのカタログは更新が速く、GitLabのサポート対象モデル一覧より新しいリリースが並ぶこともあります。カタログに載っていることは、GitLab Duoのサポートを意味しません。モデルを選ぶ前に、必ず両社のドキュメントを確認してください。
GitLab Duo Self-Hostedを選ぶ理由
GitLab Duo Self-Hostedを使うと、オンプレミス、あるいはサポート対象のクラウドプロバイダーにデプロイしたモデルにGitLab Duoを接続できます。すでにAzureで運用していて、モデルのデプロイやアクセス、ネットワーキング、使用量をAzure側で一元的に管理したい組織には、Microsoft Foundryが有力な選択肢になります。
主なメリットは次のとおりです。
- デプロイの選択肢: 可用性とデータレジデンシーの要件に合わせて、Azureのリージョンとデプロイタイプを選べます。
- 複数のモデルファミリーを1つのプラットフォームで: GPT、Claude、Llama、Mistralのモデルを並行してデプロイでき、プロバイダーごとに個別契約を結ぶ必要がありません。
- 機能単位の設定: 1つのモデルを全体に適用するのではなく、GitLab Duoの機能ごとにモデルを割り当てられます。ワークロードに合わせてファミリーを混在させることも可能です。
- Azureとの統合: Microsoft EntraによるID管理、ロールベースのアクセス制御、ネットワーク分離、Azure PolicyをFoundryのリソースにそのまま適用できます。
- 運用の一元化: モデルの使用状況とコストを、他のAzureサービスと同じ画面で監視できます。
アーキテクチャの概要
GitLab Duo Self-Hostedの構成要素は、次の3つです。
- Self-ManagedのGitLabインスタンス: ユーザーがGitLab Duoの機能を利用する、既存のGitLabインスタンスです。
- AIゲートウェイ: GitLabと選択したLLMバックエンドの間でリクエストをルーティングするサービスです。
- モデルエンドポイント: Microsoft Foundry経由で公開する、1つ以上のモデルデプロイです。
設定したすべてのモデルは1つのAIゲートウェイが担い、どのデプロイを呼び出すかは、リクエスト元の機能に応じてGitLabが決めます。
flowchart LR
    subgraph self["自社インフラ"]
        GL["Self-Managed<br/>GitLab"]
        GW["AIゲートウェイ<br/>(ポート5052)"]
    end

    subgraph azure["自社のAzureテナント"]
        subgraph foundry["Microsoft Foundry"]
            M1["duo-chat<br/>Agentic Chat、Agent Platform"]
            M2["duo-code-gen<br/>コード生成"]
            M3["duo-code-completion<br/>コード補完"]
        end
    end

    GL -- HTTPS --> GW
    GW --> M1
    GW --> M2
    GW --> M3
注: オンプレミスで運用している場合や、別のクラウドプロバイダーを使う場合は、他のモデル提供プラットフォームも利用できます。
自社ネットワークの外に出るデータ
この構成こそが、データ主権の要件を負うチームでもGitLab Duoを使えるようにしている部分です。だからこそ、どのデータがどこを通るのかは正確に押さえておく価値があります。
完全なセルフホスト構成では、推論データ(コードの入力、モデルへのプロンプト、モデルの応答)が自社ネットワークの外に出ることはないとGitLabのドキュメントに明記されています。リクエストはGitLabインスタンスからAIゲートウェイ、そしてFoundryのデプロイへと流れますが、その経路はすべて自社が管理するインフラの内側です。どのモデルやモデルプロバイダーを使っているかも、GitLabは取得しません。
外に出るのは、オンラインライセンスの場合の課金メタデータだけです。具体的には、インスタンスID、非特定化されたユーザーID、呼び出し回数、タイムスタンプの4つです。オフラインライセンスなら、インスタンスがGitLabの課金コンポーネントに接続することはありません。
ここには2つの条件がつきます。
- 適用範囲: 自社のモデルで動く機能に限られます。GitLabがホストするモデルに機能をルーティングした場合、その機能のリクエストはGitLabがホストするAIゲートウェイへ送られ、構成は完全なセルフホストではなくハイブリッドになります。
- Azure内のレジデンシー: 保管中のデータは選んだAzureのジオグラフィに留まりますが、推論がどこで実行されるかは、グローバル、データゾーン、リージョナルのどのデプロイを選ぶかで変わります。管轄区域の要件がある場合、ここは間違えてはいけない設定です。
GitLabのサポート対象とFoundryのカタログが重なるところ
モデル選定は、独立した2つの条件を同時に満たす作業です。GitLabがサポートしていること、そしてFoundryが提供していること。どちらか一方が、他方を保証することはありません。
GitLabは、サポート対象の各モデルを4つの能力領域で評価しています。コード補完、コード生成、GitLab Duo Agentic Chat、GitLab Duo Agent Platformの4領域。このうち、GitLabのサポート対象モデル表とFoundryのカタログの両方に登場するファミリーは次のとおりです。
| ファミリー | Foundryでの提供形態 | 押さえておきたい点 |
|---|---|---|
| GPT | Azure直販 | GitLabの表との重なりが最も大きく、最も素直な選択肢。汎用、コード最適化、低レイテンシーの小型など複数のバリエーションを含む |
| Claude | パートナー提供、Azure Marketplace経由 | エージェント型の評価が高い一方、Marketplace側の前提条件が追加で必要で、対応リージョンも限定的 |
| Llama | Azure直販とパートナー提供 | モデルサイズと機能によって評価が大きく変わる |
| Mistral | パートナー提供 | コードに最適化されたCodestralを含む |
具体的なバージョン番号は双方で入れ替わりが速いため、この記事では「最適なモデル」をあえて名指ししていません。代わりに、次の基準で選んでください。
- 最も素直な選択肢: 4つの領域すべてで「フル機能」と評価されている、現行の汎用GPTモデルを選びます。
- 評価はファミリー単位ではなく機能単位: GitLab Duo Agentic Chatでは優秀なモデルが、コード補完では「限定的な機能」と評価されることもあります。ファミリー全体が一様に強いと考えず、有効化する機能ごとに確認してください。
- 新しいモデルが自動的にサポートされるわけではない: FoundryはGitLabの一覧より先にリリースを提供し、Grok、DeepSeek、PhiのようにGitLabのサポート対象に入っていないファミリーも扱っています。これらはGitLabが追加してから使うか、OpenAI互換エンドポイントで公開されているモデルを受け入れるGitLabの互換モデルベータで評価してください。
- GitLabの表にはGPT-4世代の旧モデルも残っていますが、新規デプロイの出発点として最適とは言えません。
導入を決める前に、GitLabのサポート対象モデルページで最新の評価を必ず確認してください。この記事に出てくるモデル名は、推奨ではなく例として扱ってください。
前提条件
始める前に、次のものを準備してください。
- PremiumまたはUltimateのSelf-Managed GitLabインスタンス。GitLab Duo Self-HostedはGitLab 17.9で一般提供を開始していますが、機能ごとに最低バージョンが異なり、GitLab Duo Agent Platformのセルフホストにはかなり後のリリースが必要です。有効化する機能について機能バージョンの一覧を確認し、最新のモデルサポートを得るためにも新しいリリースを選んでください。
- デプロイに対応するGitLab Duoアドオン。
- GitLabの管理者アクセス権。
- Microsoft Foundryを利用できるAzureサブスクリプション。
- デプロイ予定の各モデルについて、サポート対象のAzureリージョンとデプロイタイプでのクォータ。まずAzure直販モデルまたはパートナー提供モデルのリージョン提供状況を確認してください。
- ClaudeやMistralなどのパートナー提供モデルを使う場合は、Marketplaceでの購入資格があるAzureサブスクリプションと、必要なMarketplace権限。学生向け、無料トライアル、クレジットのみのサブスクリプションはサポート対象外です。
- GitLabのインストールドキュメントに従って導入したローカルAIゲートウェイ。
注: まだGitLabをご利用でない場合は、GitLab Ultimateの無料トライアルから始められます。
実装手順
1. Microsoft Foundryでモデルをデプロイする
Foundryポータルを開き、プロジェクトを選択して、カタログから目的のモデルをデプロイします。モデルの提供状況はリージョン、クラウド、デプロイタイプによって異なり、サブスクリプションによってはクォータ引き上げの承認が必要です。
デプロイ前に、使用予定のリージョンとデプロイタイプでそのモデルが提供されているかを確認します。MicrosoftはAzure直販のFoundryモデルのリージョン提供状況で公開しており、standard、provisioned、batchがタブごとに分かれています。注意したいのは、カバー範囲の偏り。Global Standardでは広く使えるモデルが、Regional Provisioned Managedではごく少数のリージョンにしか提供されていない、ということも起こります。
パートナー提供モデルは、Azure OpenAIのモデルより制約が大きくなります。たとえばClaudeは少数のリージョンに集中しており、デプロイにはMarketplaceの利用条件への同意が必要です。ファミリーを決める前に、リージョンとサブスクリプションの資格の両方を確認してください。
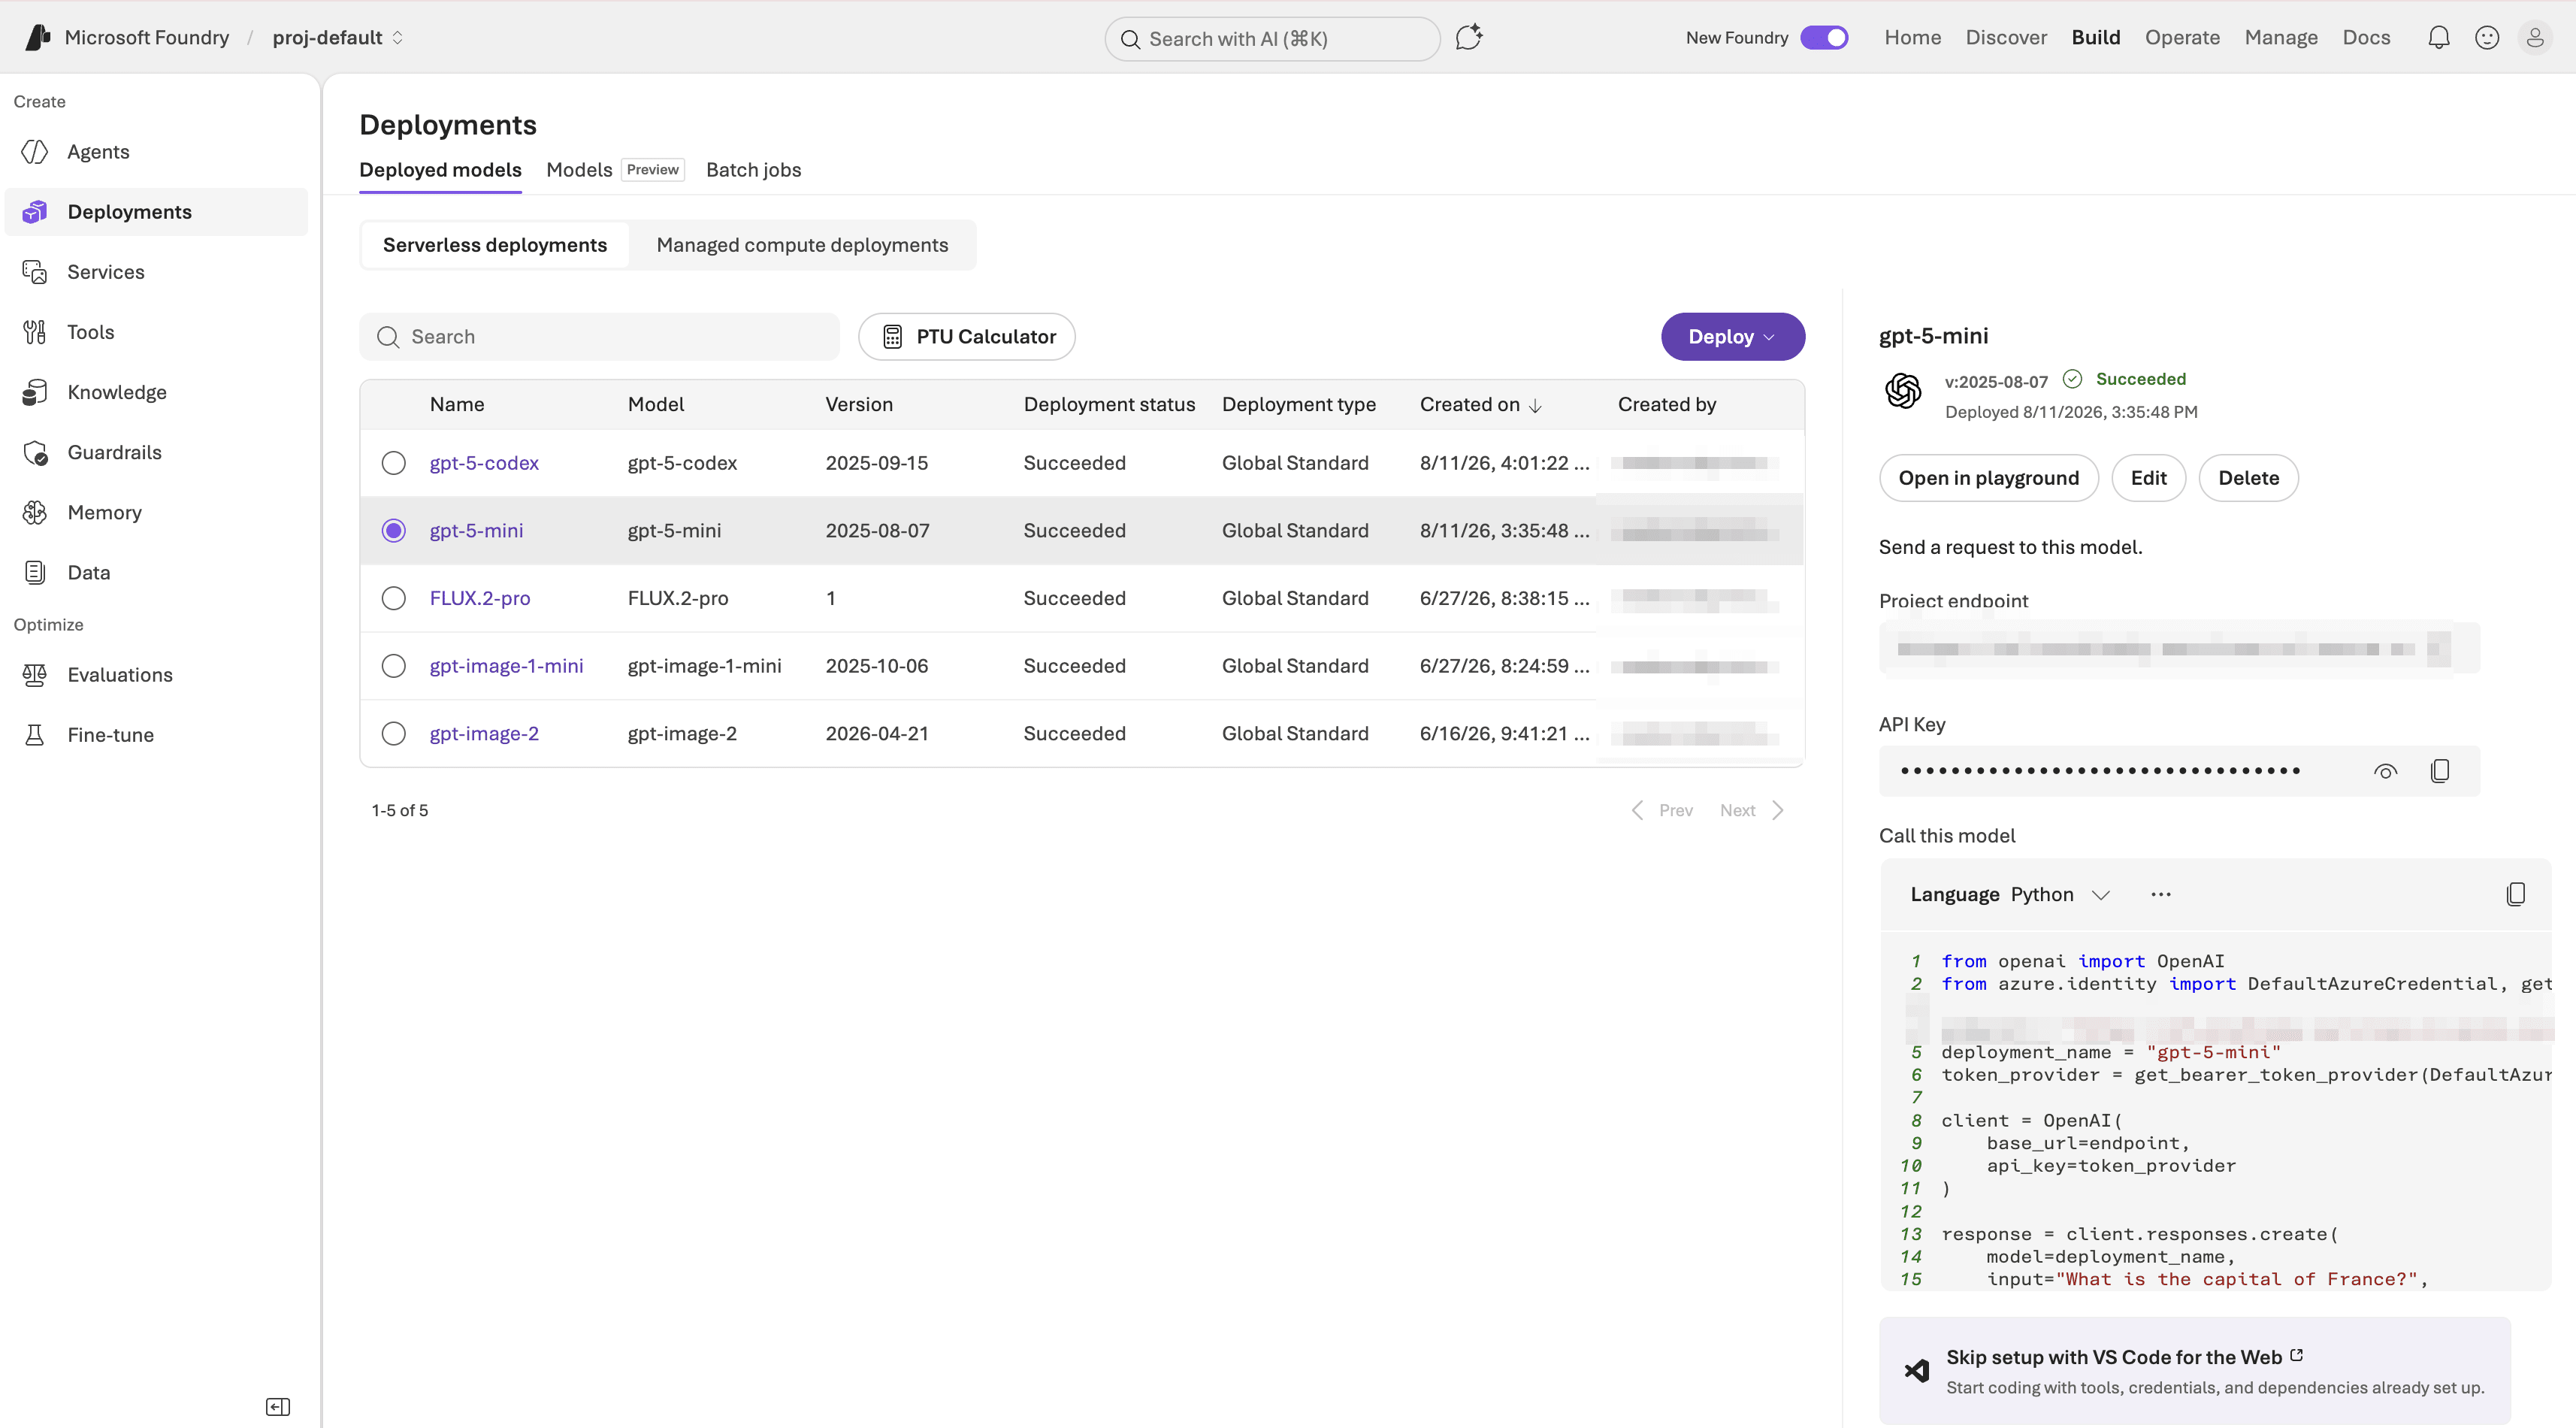 Microsoft Foundryのモデル
各デプロイには、後から追跡できる名前を付けてください。GitLabが参照するのはカタログ上のモデル名ではなくデプロイ名なので、曖昧な名前は監査の妨げになります。
duo-chatやduo-code-completionのように、モデルのバージョンではなく役割で名前を付けると、実用的な利点があります。理由は、新しいモデルにアップグレードするときに、GitLab側のモデル識別子を編集せず、デプロイの向き先だけを変えられること。duo-gpt-5-2のようにバージョンで名前を付ける方法はより明示的ですが、モデルを変えるたびにGitLabの再設定が必要になります。
最初はモデルを1つだけデプロイし、端から端まで動くことを確認してから広げるのが安全です。
デプロイ後は、デプロイごとに次の値を記録しておきます。
- エンドポイントURL
- デプロイ名
- そのデプロイにアクセスできるAPIキー
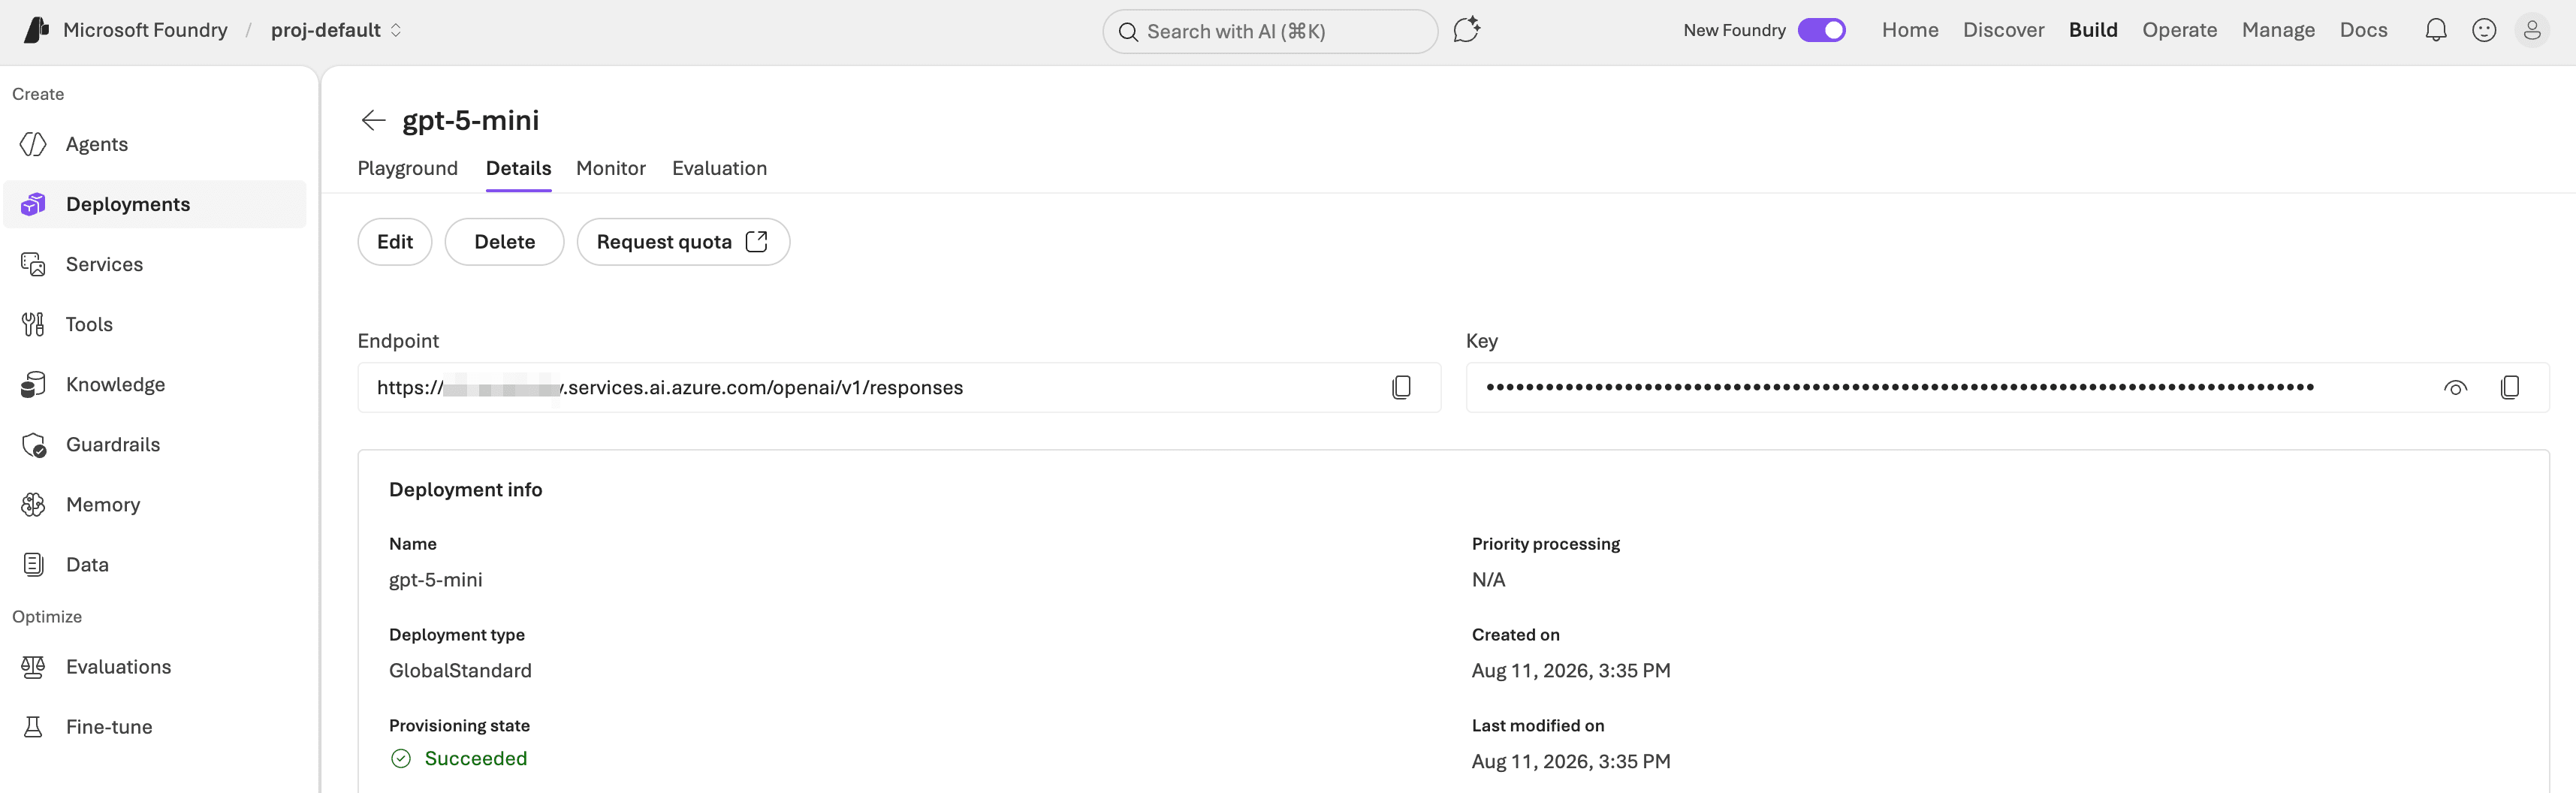 Microsoft Foundry - gpt-5-mini model
シークレットの管理は、社内で承認されたプロセスに従ってください。APIキーをリポジトリにコミットしてはいけません。
2. AIゲートウェイをインストールする
AIゲートウェイは、GitLabと選択したモデルエンドポイントの間でリクエストをルーティングします。最新のAIゲートウェイインストールガイドに従って、DockerまたはHelmチャートでインストールしてください。
他のチュートリアルにある古いイメージタグやAPIバージョンの例を、そのまま流用するのは避けてください。AIゲートウェイとGitLabのバージョンは互換性を保つ必要があり、最新のイメージと必須設定はGitLabのインストールガイドに記載されています。FoundryのエンドポイントとAPIキーは、手順4で各モデルをGitLabに追加するときに入力するもので、Dockerコマンドの例に埋め込む必要はありません。
設定したすべてのモデルは1つのゲートウェイでさばけるため、デプロイごとやモデルファミリーごとにゲートウェイを分ける必要はありません。
3. GitLabからAIゲートウェイへのアクセスを設定する
AIゲートウェイが動いたら、それを使うようにGitLabインスタンスを設定します。
- 左側のサイドバーの下部で、管理者を選択します。
- GitLab Duoを選択します。
- GitLab Duoのセクションで、設定の変更を選択します。
- ローカルAIゲートウェイURLに、AIゲートウェイのURLとポートを入力します(例:
https://ai-gateway.example.com:5052)。 - 変更を保存を選択します。
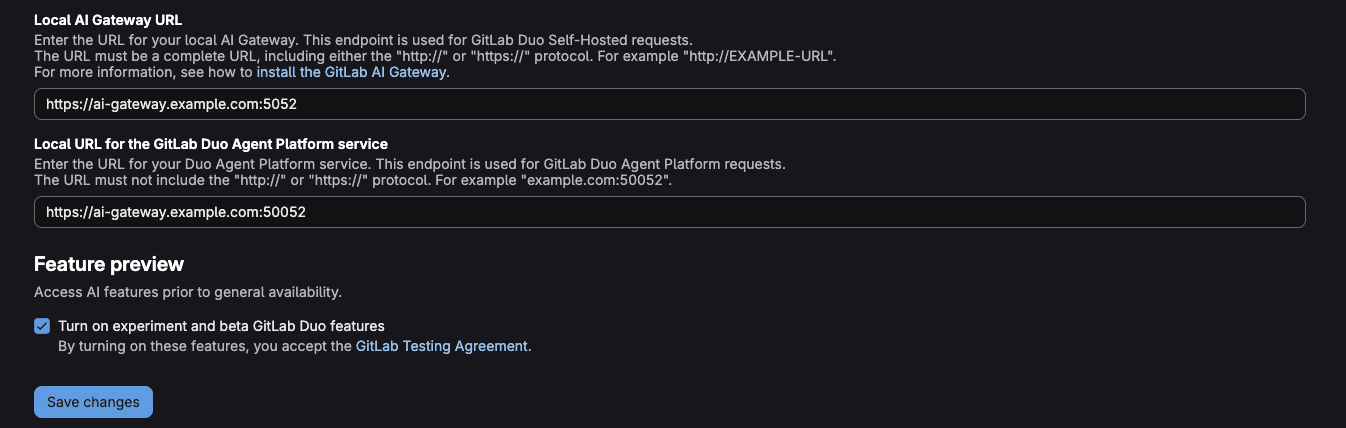 GitLab Duo AI Gateway configuration
本番環境では、TLSを使い、ゲートウェイへのネットワークアクセスを制限してください。ゲートウェイがプライベートIPアドレスや内部ホスト名を使う場合は、GitLabの送信リクエストの許可リストに追加します。
4. 各デプロイをGitLabに追加する
GitLabから使いたいFoundryのデプロイごとに、この手順を繰り返します。
- 右上隅で、管理者を選択します。
- 左側のサイドバーで、GitLab Duoを選択します。
- GitLab Duoのモデルを設定するを選択します。
- セルフホストモデルの追加を選択します。
- 次のフィールドに入力します。
- デプロイ名:
Agentic Chat on Microsoft Foundryのように、識別しやすい名前を入力します。 - モデルファミリー: GPTやClaudeなど、モデルに合ったファミリーを選択します。
- エンドポイント: FoundryのデプロイのエンドポイントURLを入力します。
- APIキー: そのデプロイのAPIキーを入力します。
- モデル識別子: Foundryのデプロイ名を正確に使い、
azure/YOUR-DEPLOYMENT-NAMEを入力します。たとえばazure/duo-chatです。
- デプロイ名:
- セルフホストモデルの追加を選択します。
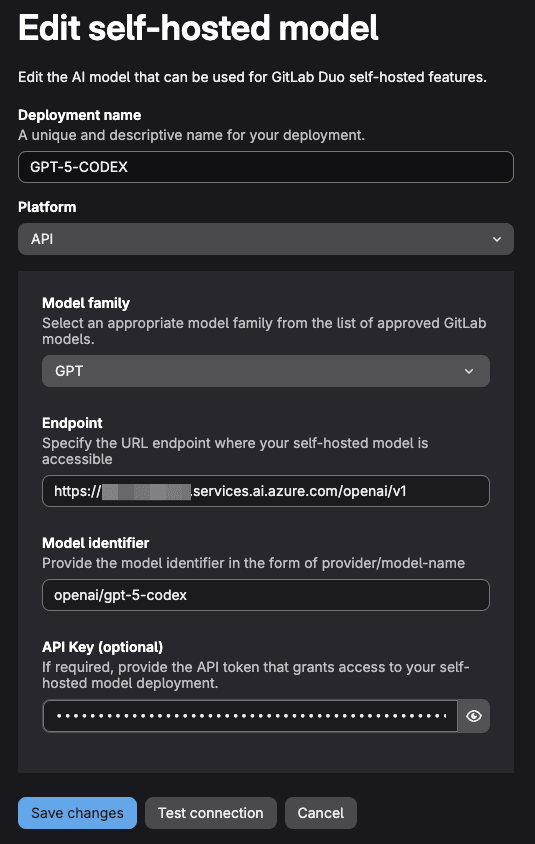 GitLab Duo Self-Hosted model configuration
このプレフィックスが表すのは、モデルの提供方法であって開発元ではありません。FoundryはOpenAI以外のモデルもAzure OpenAIのエンドポイント経由で公開できるため、その場合もazure/が当てはまります。別のFoundryエンドポイント経由でアクセスするパートナー提供モデルをデプロイする場合は、思い込みで進めず、GitLabの設定ドキュメントで正しいプレフィックスを確認してください。プレフィックスが合っていないと、「Model not found」エラーの原因になります。
5. GitLab Duoの機能にモデルを割り当てる
- 管理者 > GitLab Duoで、GitLab Duoのモデルを設定するを選択します。
- AIネイティブ機能タブを選択します。
- Foundryにルーティングしたい機能ごとに、ドロップダウンリストからデプロイを選択します。
カタログの幅が生きてくるのはここです。機能同士で1つのモデルを共有する必要はなく、ファミリーをそろえる必要さえありません。妥当な分け方の一例が、次のとおりです。
- コード補完: 選んだファミリーの中で小型かつ高速なモデル。リクエスト量が多く、レイテンシーが最も目につく機能です。
- コード生成: CodexやCodestralのような、コードに最適化されたモデル。
- GitLab Duo Agentic Chat: 幅広い用途に対応できる汎用モデル。チャットのサブ機能ごとにモデルを指定しない場合は、管理者エリアでGeneral Chatに設定したモデルが継承されます。
- GitLab Duo Agent Platform: GitLabの評価表でAgent Platform向けに「フル機能」と評価されているモデル。小型モデルは、補完やチャットよりもここでの評価が低くなりがちです。
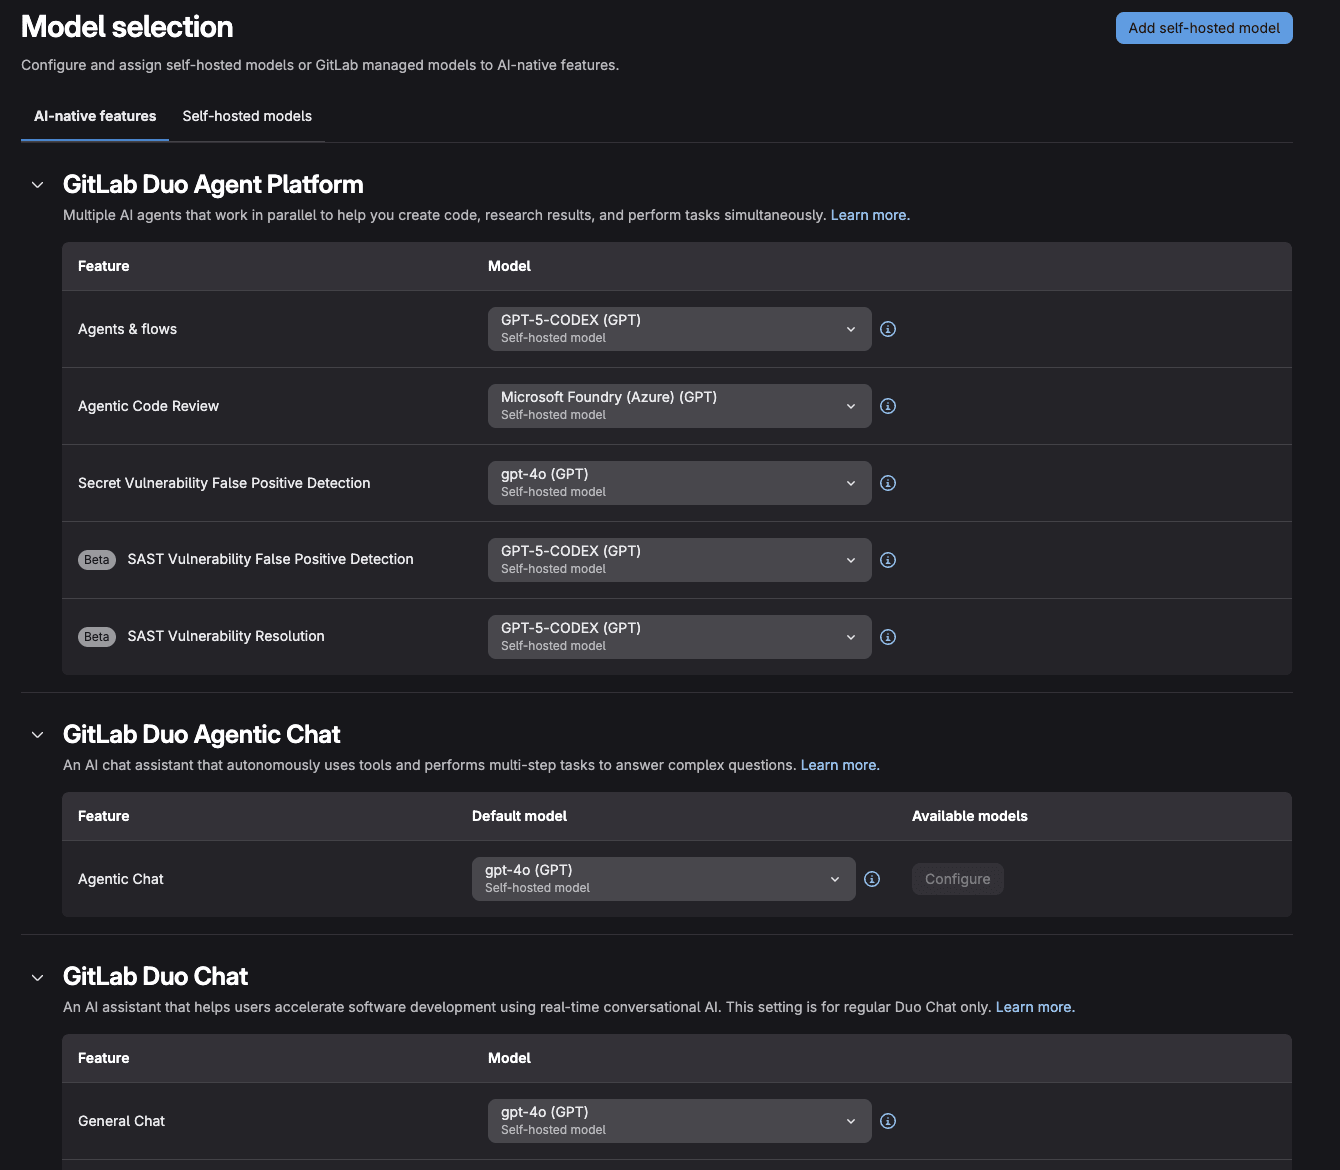 GitLab Duo model selection
この分け方は、チューニング済みの構成ではなく出発点の仮説として捉えてください。まずは有効化する機能すべてを1つのモデルでそろえ、品質、レイテンシー、コストの基準値をきれいに取ります。2つ目のモデルを入れるのは、自社の計測がそれを裏づけた箇所だけにします。
設定を検証する
Microsoft Foundryを使ったGitLab Duo Self-Hostedの実装が正しく動いているかは、次の手順で確認します。
1. ヘルスチェックを実行する
モデル側が起動していることを確認したら、管理者ページのGitLab Duoセクションに戻り、ヘルスチェックを実行を選択します。ここで検証されるのは、次の項目です。
- AIゲートウェイのURLが正しく設定されていること
- インスタンスからAIゲートウェイに接続できること
- 必要なGitLab Duoアドオンが有効であること
- コード提案にモデルが割り当てられていること(接続テストに使われるのが、このモデルだからです)
ヘルスチェックで問題が報告された場合は、トラブルシューティングガイドで一般的なエラーを確認してください。
2. コード生成でFastAPIサービスの雛形を作る
最初のテストにコード生成が向いているのは、経路全体を端から端まで通し、結果が一目で分かるからです。コード補完よりも多くのコンテキストを送るため、エンドポイントの設定ミスやクォータ不足もすぐに表面化します。
コード提案には2つの異なる挙動があり、どちらを発動させているかを分かっていないと、結果を読み違えます。
- コード補完: 入力中に発動し、書いている行を補完します。レイテンシーは低く、通常は1秒未満です。
- コード生成: やりたいことを書いたコメントの後でEnterを押すと発動します。関数やクラスをまるごと返すこともあり、5秒以上かかる場合もあります。
FastAPIサービスの雛形を作る手順は、次のとおりです。
- IDEでプロジェクトを開き、
main.pyのような空のファイルを作成します。コード生成はファイルが5行未満のときに精度が高くなるため、空のファイルが理想的な出発点です。 - フレームワーク名と、得たい結果を明記したコメントを書きます。
# Create a FastAPI service with a health check endpoint and CRUD endpoints for # a "tasks" resource backed by an in-memory list. Use Pydantic models for # request and response bodies, and return appropriate HTTP status codes. - コメントの後でEnterを押します。末尾の改行が、指示が完了した合図になります。
- 提案が出るまで待ち、採用するならTab、却下するならEscを押します。
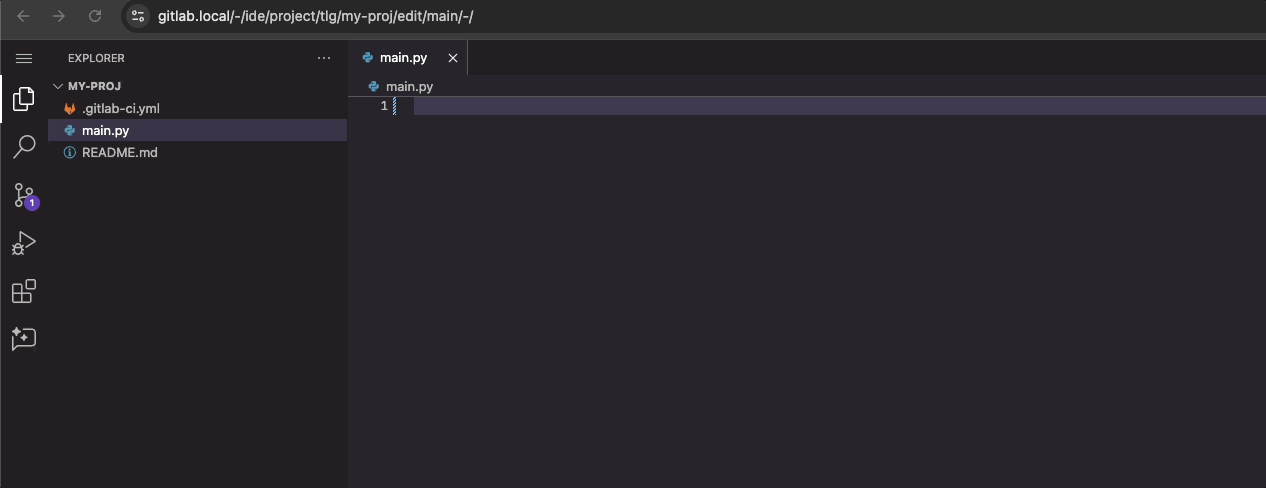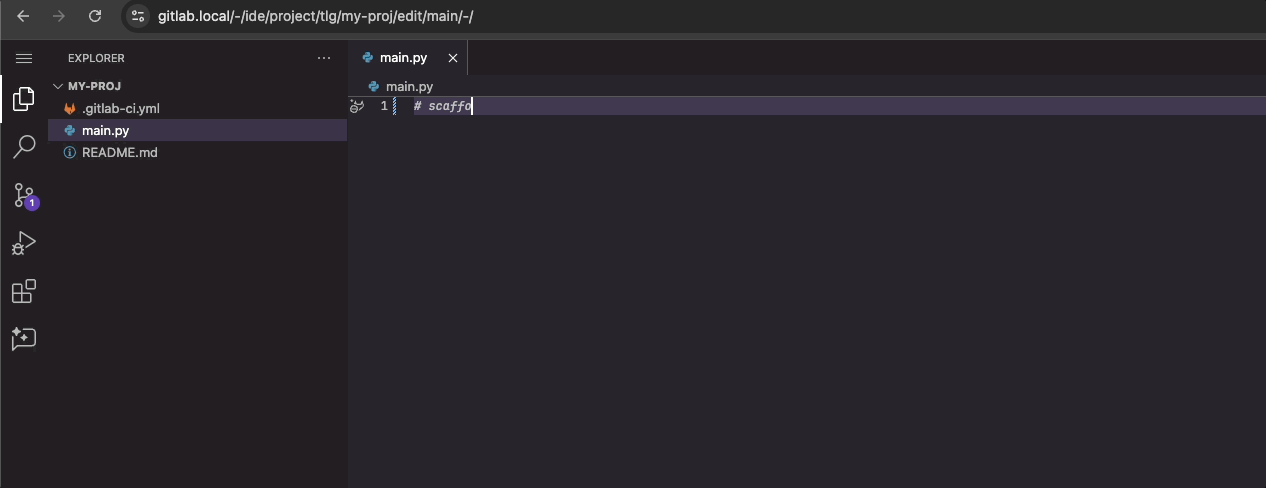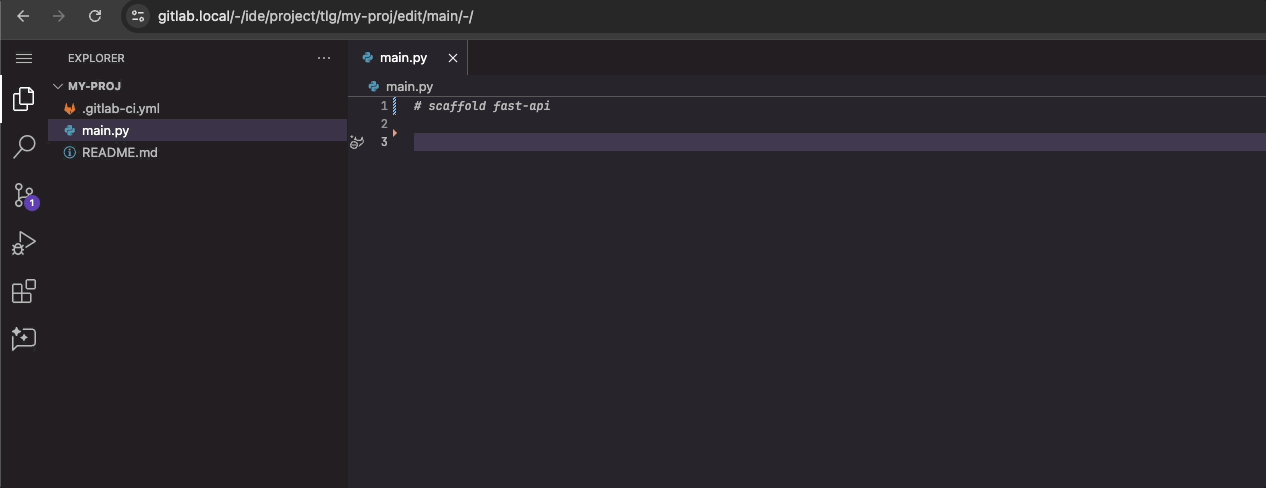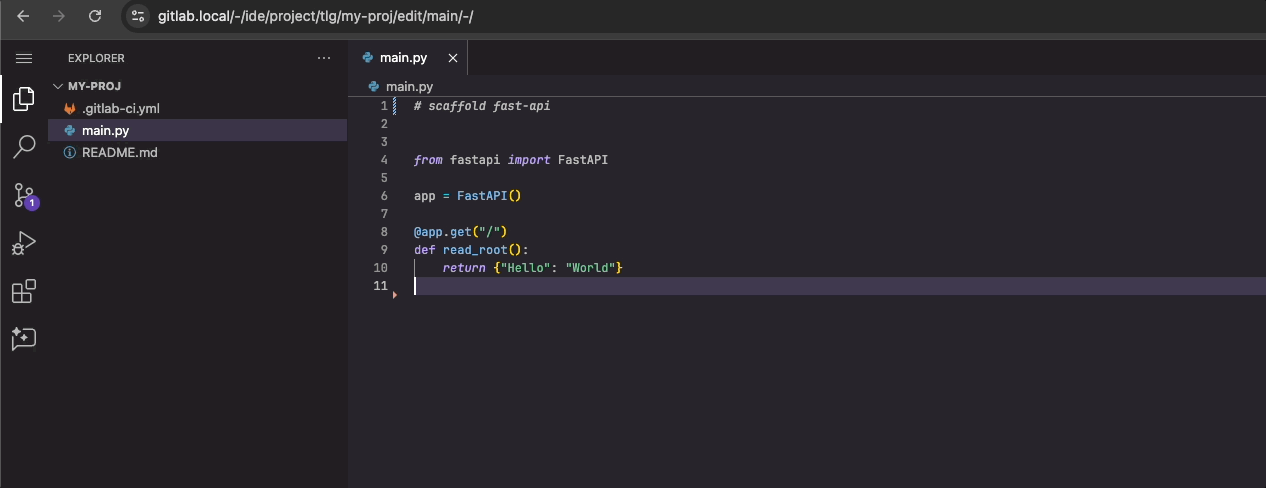 Scaffold a FastAPI service with code generation
うまくいく鍵は、フレームワークを明示することです。GitLabがコード生成について推奨しているのは、得たい結果を述べること、具体的かつ簡潔に保つこと、そして使いたいライブラリやフレームワークを名指しすること。# web serviceのような曖昧なコメントでは、モデルに与えられる手がかりが大幅に減ります。
あらかじめ知っておきたい点が2つあります。1つは、コード生成の出力が約2048トークンを上限とするため、完成したアプリケーションではなく、しっかりした雛形が得られること。もう1つは、これらのモデルが決定的ではないため、同じコメントから同じコードが2度出てくることはない点です。これは設定ミスの兆候ではなく、正常な挙動です。
機能ごとに違うモデルを割り当てた場合は、それぞれ個別にテストしてください。そうすれば、失敗したときに原因のデプロイを1つに絞れます。コード生成が確認できれば、手順5でコード生成に割り当てたモデルが実際にリクエストを処理していることも、同時に確認できます。
3. AIゲートウェイのログを確認する
AIゲートウェイのログを見て、Microsoft Foundryのデプロイにリクエストがルーティングされていることを確認します。
ターミナルで、次のコマンドを実行します。
docker logs gitlab-ai-gateway --tail 100 -f
設定したモデルエンドポイントへのリクエストが成功したことを示すログエントリが表示されるはずです。プロンプトのログ記録は、社内のデータ取り扱いポリシーで認められている場合を除き、有効化しないでください。
次のステップ
ここからの進め方を紹介します。
モデル選定を最新に保つ
GitLabのチームは、各モデルの性能を機能ごとに継続的にテストし、性能と適合性のランク付けを公開しています。
- フル機能: 品質を損なうことなく、その機能を問題なく扱える可能性が高いモデルです。
- 部分的な機能: 機能は動作しますが、妥協や制限が生じる可能性があります。
- 限定的な機能: その機能には適しておらず、品質の大幅な低下や性能上の問題が生じる可能性があります。
モデル名やFoundryのカタログへの掲載から、互換性を推測してはいけません。GitLabの最新の評価については、モデルとハードウェア要件のページを信頼できる唯一の情報源として参照してください。
コスト最適化の進め方
- 有効化予定の機能について、4つの領域すべてで「フル機能」と評価されたモデル1つから始めます。
- 代表的なワークロードで、品質、レイテンシー、トークン使用量、レート制限の挙動、コストを計測します。
- コード補完のようなリクエスト量の多い機能は、品質とのトレードオフが許容範囲だと確認できてから、小型モデルに移します。そのモデルをGitLab Duo Agent Platformでも使う場合は、事前に評価を確認してください。
- コストより生成品質を重視するチームなら、コード提案にコード特化型のモデルを検討します。
- GitLabのサポート対象一覧と、Microsoftのモデル廃止スケジュールを定期的に見直します。
- Azure Cost Managementで使用量を監視し、自社に合った予算やアラートを設定します。
Microsoft Foundry以外の選択肢
このガイドはMicrosoft Foundryとの連携を中心に扱っていますが、GitLab Duo Self-Hostedは複数のデプロイ方式に対応しています。
- vLLMによるオンプレミス運用: サポート対象のモデル、またはOpenAI API互換のモデルを、自社管理のインフラで提供します。
- Amazon Bedrock: Microsoft Foundryと同様に、クラウドホスト型モデルの提供基盤としてAmazon Bedrockを利用できます。
- Anthropic、OpenAI、Gemini Enterprise Agent Platformなど、検証済みのその他のプロバイダー。
Azureとのエンタープライズ統合
すでにAzureのエコシステムに投資している組織には、Microsoft Foundry固有の利点があります。
- 課金の一元化: モデルの使用量を、他のAzureサービスとまとめて把握できます。
- Microsoft Entraとの統合: 既存のID管理とロール管理の運用を、Foundryのリソースにそのまま適用できます。
- プライベートネットワーキング: プライベートエンドポイントと、GitLabからAzureへの通信経路を、自社のセキュリティアーキテクチャに沿って評価します。
- リージョン単位のデプロイ: 選んだモデルが利用できるリージョンとデプロイタイプの中から選択します。前述のレジデンシーの違いも、念頭に置いてください。
これらの機能はコンプライアンスプログラムを支えますが、それだけでGitLab Duoの構成がコンプライアンスに準拠するわけではありません。アーキテクチャ全体、データフロー、ログ記録、保持期間、契約、運用統制を、自社の要件に照らして検証してください。
まとめ
Microsoft Foundryと組み合わせたGitLab Duo Self-Hostedを使えば、AzureでホストするモデルからGitLab Duoの機能を提供できます。FoundryのカタログはGPT、Claude、Llama、Mistralに及び、GitLabもそれぞれのモデルをサポートしているため、必要なファミリーを1つのAzureサブスクリプションでカバーできます。まずは幅広い用途に対応できるモデル1つから始め、計測結果が裏づけたところで機能ごとにモデルを割り当てていきましょう。
この記事に出てくるモデル名は、推奨ではなく例です。両社のカタログは頻繁に変わるため、デプロイ時点で信頼できる唯一の情報源は、両社の対応一覧だと考えてください。
長く通用する教訓は、モデル選定をカタログの買い物ではなく、互換性の判断として扱うことです。GitLabのサポート対象一覧を確認し、Microsoft Foundryで提供状況とライフサイクルの状態を確かめ、モデルをデプロイしたうえで、全社展開の前に自社のワークロードで検証してください。
まずはここから
- 設定の全体像は、GitLab Duo Self-Hostedのドキュメントをご覧ください。
- GitLab Duo Agent Platformで何が作れるかを確かめてみてください。
- GitLabをはじめて使う方は、GitLab Ultimateの無料トライアルからお試しください。
- チーム全体への展開を検討中の方は、GitLabの担当者にお問い合わせいただければ、ライセンスとアーキテクチャについてご相談いただけます。