Pour de nombreuses organisations, la question autour des outils de codage alimentés par l'IA ne porte pas sur leur utilité, mais sur la destination du code. Les équipes soumises à des contraintes de souveraineté des données, de résidence ou de réglementation doivent savoir quel réseau traite leur code source avant de pouvoir adopter la moindre solution. GitLab Duo Self-Hosted répond à cette exigence en permettant aux administrateurs de connecter les fonctionnalités de GitLab Duo à des modèles s'exécutant sur l'infrastructure de leur choix, avec un contrôle sur l'hébergement, la région, le chemin réseau et les identifiants.
Dans ce tutoriel, nous connecterons GitLab Duo Self-Hosted à des modèles hébergés sur Microsoft Foundry. Il convient de considérer Foundry comme une plateforme de service polyvalente plutôt que comme un simple point de terminaison OpenAI : son catalogue couvre OpenAI GPT, Anthropic Claude, Meta Llama et Mistral, et les familles de modèles prises en charge par GitLab recoupent largement l'offre de Foundry.
Cette distinction est importante, car GitLab permet d'attribuer un modèle par fonctionnalité. Vous pouvez ainsi exécuter une famille de modèles pour les tâches agentiques, un modèle spécialisé dans le code pour GitLab Duo Code Suggestions, et un modèle plus léger lorsque le volume de requêtes est important, le tout déployé et facturé via un seul abonnement Azure.
Les étapes de configuration restent identiques, quelle que soit la famille de modèles choisie. Seuls changent le modèle que vous déployez, le nom du déploiement que vous référencez, et la famille de modèles que vous sélectionnez dans GitLab.
Le catalogue de Microsoft évolue rapidement et contiendra toujours des versions plus récentes que la matrice des modèles pris en charge par GitLab. La disponibilité d'un modèle dans le catalogue ne garantit pas à elle seule sa prise en charge par GitLab Duo : vérifiez toujours la documentation des deux fournisseurs avant de choisir un modèle.
Pourquoi opter pour GitLab Duo Self-Hosted ?
GitLab Duo Self-Hosted vous permet de connecter GitLab Duo à des modèles déployés sur site ou via un fournisseur cloud pris en charge. Microsoft Foundry est particulièrement utile lorsque votre organisation utilise déjà Azure et souhaite y gérer le déploiement de modèles, les accès, la mise en réseau et la consommation.
Voici ses principaux avantages :
- Choix du déploiement : sélectionnez la région Azure et le type de déploiement qui répondent à vos exigences en matière de disponibilité et de résidence des données.
- Plusieurs familles de modèles, une seule plateforme : déployez des modèles GPT, Claude, Llama ou Mistral côte à côte, sans devoir signer un contrat distinct avec chaque fournisseur.
- Configuration par fonctionnalité : attribuez des modèles à des fonctionnalités individuelles de GitLab Duo au lieu d'appliquer un seul modèle de manière globale, en combinant les familles en fonction de vos charges de travail.
- Intégration Azure : appliquez l'identité Microsoft Entra, le contrôle d'accès basé sur les rôles, l'isolation réseau et Azure Policy à vos ressources Foundry.
- Opérations centralisées : suivez l'utilisation des modèles et les coûts aux côtés de vos autres services Azure.
Vue d'ensemble de l'architecture
La solution GitLab Duo Self-Hosted repose sur trois composants principaux :
- Instance GitLab auto-gérée : votre instance GitLab existante, sur laquelle les utilisateurs interagissent avec les fonctionnalités de GitLab Duo.
- Passerelle d'IA : un service qui achemine les requêtes entre GitLab et le backend LLM de votre choix.
- Points de terminaison des modèles : un ou plusieurs déploiements de modèles exposés via Microsoft Foundry.
Une seule passerelle d'IA dessert tous les modèles que vous configurez, et GitLab détermine quel déploiement appeler en fonction de la fonctionnalité à l'origine de la requête :
flowchart LR
    subgraph self["Votre infrastructure"]
        GL["GitLab<br/>Self-Managed"]
        GW["Passerelle d'IA<br/>(port 5052)"]
    end

    subgraph azure["Votre locataire Azure"]
        subgraph foundry["Microsoft Foundry"]
            M1["duo-chat<br/>Agentic Chat, GitLab Duo Agent Platform"]
            M2["duo-code-gen<br/>Génération de code"]
            M3["duo-code-completion<br/>Complétion de code"]
        end
    end

    GL -- HTTPS --> GW
    GW --> M1
    GW --> M2
    GW --> M3
Remarque : vous pouvez utiliser une autre plateforme de service si vous exploitez une solution sur site ou un autre fournisseur cloud.
Les données qui quittent votre réseau
C'est cette configuration qui permet l'utilisation de GitLab Duo pour les équipes soumises à des obligations de souveraineté des données ; il convient donc de préciser exactement où circulent les données.
Dans une configuration entièrement auto-hébergée, la documentation de GitLab indique que les données d'inférence (entrées de code, prompts envoyés au modèle et réponses du modèle) ne quittent pas votre réseau. Les requêtes transitent de votre instance GitLab vers votre passerelle d'IA, puis vers votre déploiement Foundry, le tout au sein d'une infrastructure que vous contrôlez. GitLab ne recense pas non plus le modèle ou le fournisseur de modèle que vous utilisez.
Ce qui quitte réellement votre réseau, dans le cas d'une licence en ligne, ce sont les métadonnées de facturation : un identifiant d'instance, un identifiant utilisateur anonymisé, un nombre d'appels et un horodatage. Avec une licence hors ligne, votre instance ne se connecte pas aux composants de facturation de GitLab.
Deux conditions s'appliquent dans ce cas :
- Ce scénario ne s'applique qu'aux fonctionnalités reposant sur vos propres modèles. Si vous redirigez une fonctionnalité vers un modèle géré par GitLab, les requêtes de cette fonctionnalité passent alors par la passerelle d'IA hébergée par GitLab, et le déploiement devient hybride plutôt qu'entièrement auto-hébergé.
- Au sein d'Azure, la résidence des données dépend du type de déploiement. Les données au repos restent dans la zone géographique Azure de votre choix, mais le lieu d'exécution des inférences dépend du type de déploiement choisi (global, par zone de données ou régional). C'est ce paramètre qu'il convient de définir correctement si vous avez des exigences juridictionnelles.
Où se recoupent la prise en charge GitLab et le catalogue Foundry
Choisir un modèle revient à satisfaire deux contraintes indépendantes : GitLab doit le prendre en charge, et Foundry doit le proposer. L'une n'implique pas l'autre.
GitLab évalue chaque modèle pris en charge en fonction de quatre catégories de capacités : la complétion de code, la génération de code, GitLab Duo Agentic Chat et GitLab Duo Agent Platform. Les familles suivantes figurent à la fois dans le tableau des modèles pris en charge par GitLab et dans le catalogue Foundry :
| Famille | Mode de mise à disposition par Foundry | À savoir |
|---|---|---|
| GPT | Vendu par Azure | Recoupement le plus large avec la matrice GitLab ; la voie la plus simple. Comprend des variantes généralistes, optimisées pour le code et plus légères à faible latence |
| Claude | Proposé par des partenaires, via Azure Marketplace | Excellentes évaluations pour une utilisation agentique ; prérequis Marketplace supplémentaires et couverture régionale plus restreinte |
| Llama | Vendu par Azure et par des partenaires | Fortes fluctuations des évaluations selon la taille du modèle et la fonctionnalité |
| Mistral | Proposé par des partenaires | Comprend Codestral, spécialisé dans le code |
Les numéros de version évoluent rapidement des deux côtés ; cet article évite donc volontairement de désigner un « meilleur » modèle. Choisissez plutôt un modèle en suivant ces règles :
- La voie la plus simple : choisissez un modèle GPT généraliste actuel, classé en fonctionnalité complète dans les quatre catégories.
- Les évaluations portent sur chaque fonctionnalité, et non sur chaque famille de modèles : un modèle excellent pour GitLab Duo Agentic Chat peut être jugé limité pour la complétion de code. Vérifiez chaque fonctionnalité que vous prévoyez d'activer plutôt que de partir du principe qu'une famille obtient de bons résultats dans toutes les catégories.
- Les versions les plus récentes ne sont pas automatiquement prises en charge : Foundry publie des versions en avance sur la matrice de GitLab, et propose aussi des familles comme Grok, DeepSeek ou Phi qui ne figurent pas dans la liste des modèles pris en charge par GitLab. N'utilisez ces modèles qu'une fois ajoutés par GitLab, ou évaluez-les via la version bêta des modèles compatibles de GitLab, qui accepte tout modèle exposé via un point de terminaison compatible avec OpenAI.
- Les anciens modèles de l'ère GPT-4 figurent encore dans le tableau de GitLab, mais ne constituent pas le meilleur point de départ pour un nouveau déploiement.
Vérifiez toujours les évaluations actuelles sur la page des modèles pris en charge par GitLab avant de vous engager, et considérez tout modèle cité dans cet article comme un exemple plutôt que comme une recommandation.
Prérequis
Avant de commencer, vous aurez besoin des éléments suivants :
- Une instance GitLab Premium ou GitLab Ultimate Self-Managed. GitLab Duo Self-Hosted est en disponibilité générale depuis la version GitLab 17.9, mais chaque fonctionnalité a ses propres exigences minimales, et GitLab Duo Agent Platform Self-Hosted requiert une version nettement plus récente. Consultez le tableau des versions des fonctionnalités pour celles que vous prévoyez d'activer, et privilégiez une version récente pour bénéficier de la prise en charge actuelle des modèles.
- Le module complémentaire GitLab Duo adapté à votre déploiement.
- Un accès administrateur à GitLab.
- Un abonnement Azure donnant accès à Microsoft Foundry.
- Un quota pour chaque modèle que vous prévoyez de déployer, dans une région et un type de déploiement Azure pris en charge. Vérifiez d'abord la disponibilité régionale pour les modèles vendus par Azure ou les modèles proposés par des partenaires.
- Pour les modèles de partenaires tels que Claude ou Mistral, un abonnement Azure éligible aux achats Marketplace, ainsi que les autorisations Marketplace requises. Les abonnements étudiants, d'essai gratuit ou basés uniquement sur des crédits ne sont pas pris en charge.
- Une passerelle d'IA locale installée conformément à la documentation d'installation de GitLab.
Remarque : si vous n'êtes pas encore client GitLab, vous pouvez démarrer un essai gratuit de GitLab Ultimate.
Étapes de mise en œuvre
1. Déployer un ou plusieurs modèles dans Microsoft Foundry
Ouvrez le portail Foundry, sélectionnez votre projet, puis déployez les modèles choisis depuis le catalogue. La disponibilité des modèles varie selon la région, le cloud et le type de déploiement, et certains abonnements nécessitent une augmentation de quota approuvée.
Avant de procéder au déploiement, vérifiez que votre modèle est proposé dans la région et pour le type de déploiement que vous comptez utiliser. Microsoft publie ces informations sur la page Disponibilité des régions pour les modèles Foundry vendus par Azure, avec des onglets distincts pour les déploiements standard, provisionnés et par lot. La couverture est inégale : un modèle peut être disponible à grande échelle en standard global tout en n'étant proposé que dans une poignée de régions en gestion provisionnée régionale.
Les modèles des partenaires sont soumis à davantage de restrictions que les modèles Azure OpenAI. Claude, par exemple, est concentré dans un petit nombre de régions, et son déploiement nécessite l'acceptation des conditions générales de Marketplace. Vérifiez à la fois l'éligibilité de la région et de l'abonnement avant d'opter pour une famille de modèles.
 Modèles Microsoft Foundry
Attribuez à chaque déploiement un nom qui vous permettra de le retrouver ultérieurement. GitLab référence le nom du déploiement plutôt que le nom du modèle du catalogue : un nom vague sera difficile à auditer.
Nommer les déploiements par rôle plutôt que par version de modèle, par exemple duo-chat ou duo-code-completion, présente un avantage pratique : lors d'une mise à niveau vers un modèle plus récent, vous pouvez pointer le déploiement vers celui-ci sans avoir à modifier l'identifiant du modèle dans GitLab. Nommer les déploiements par version, par exemple duo-gpt-5-2, est plus explicite, mais implique de reconfigurer GitLab à chaque changement de modèle.
Si vous débutez, déployez un seul modèle et étendez-le une fois qu'il fonctionne de bout en bout.
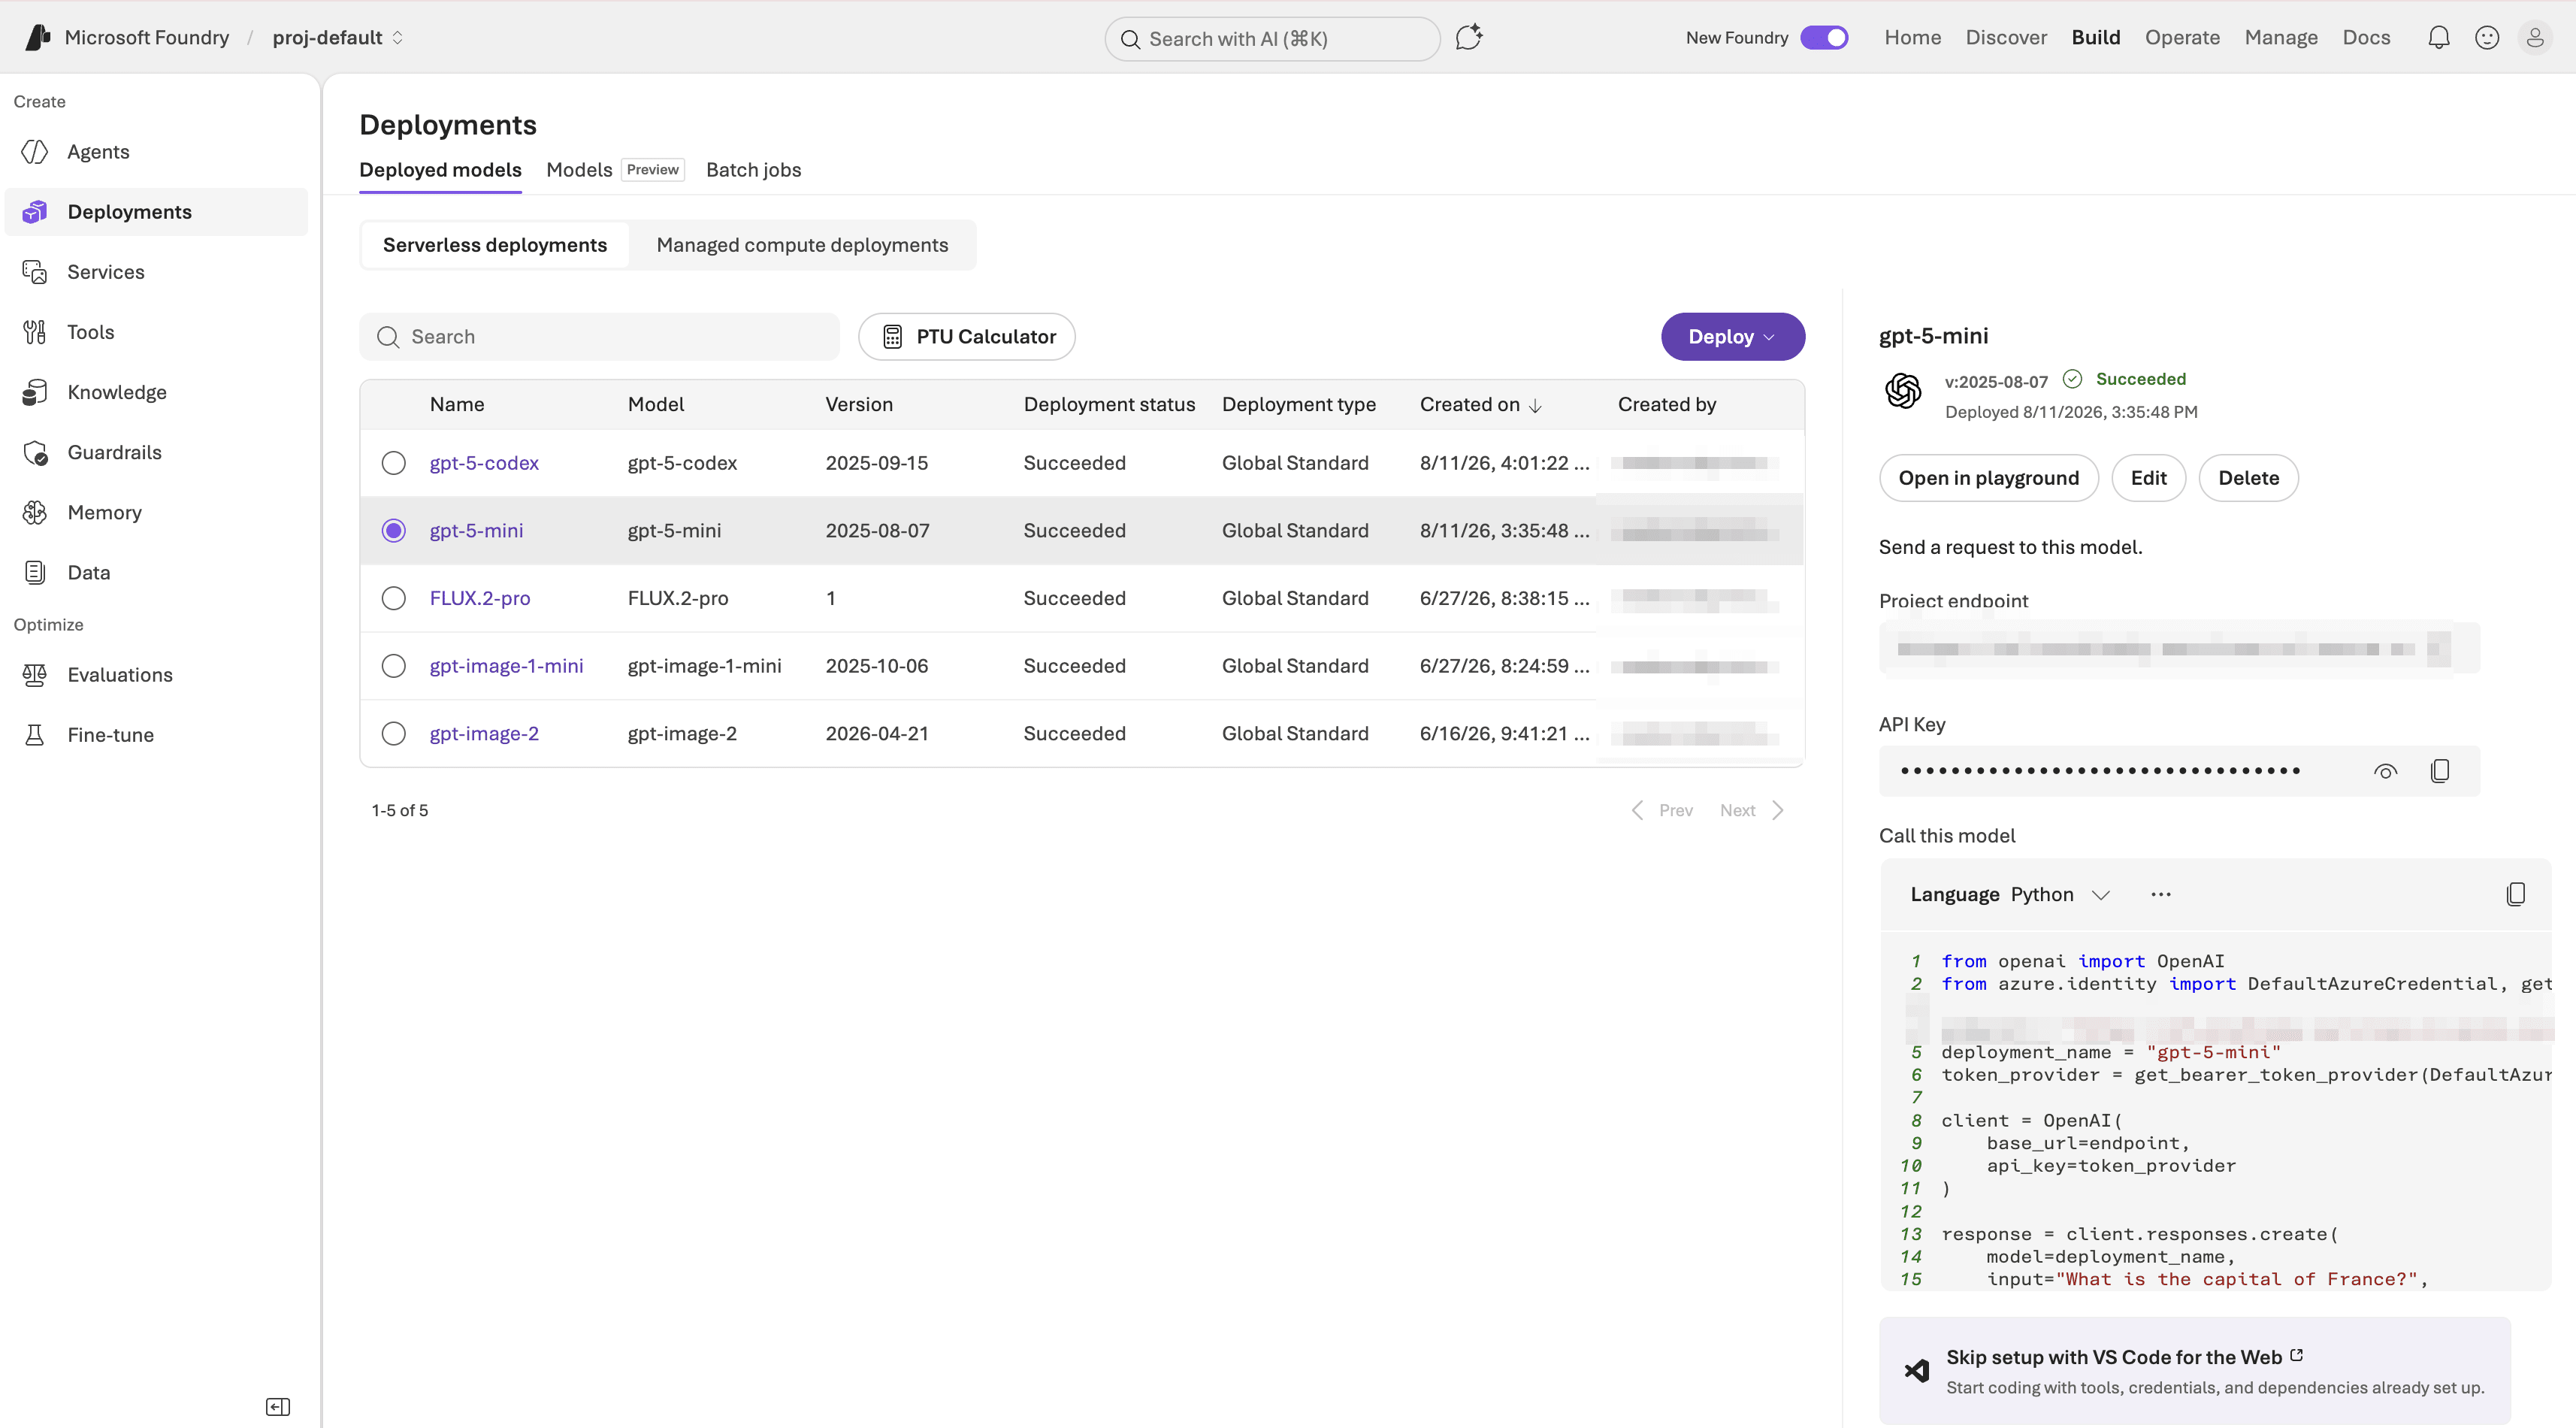
Une fois le déploiement effectué, notez les informations suivantes pour chaque déploiement :
- L'URL du point de terminaison
- Le nom du déploiement
- Une clé API donnant accès au déploiement
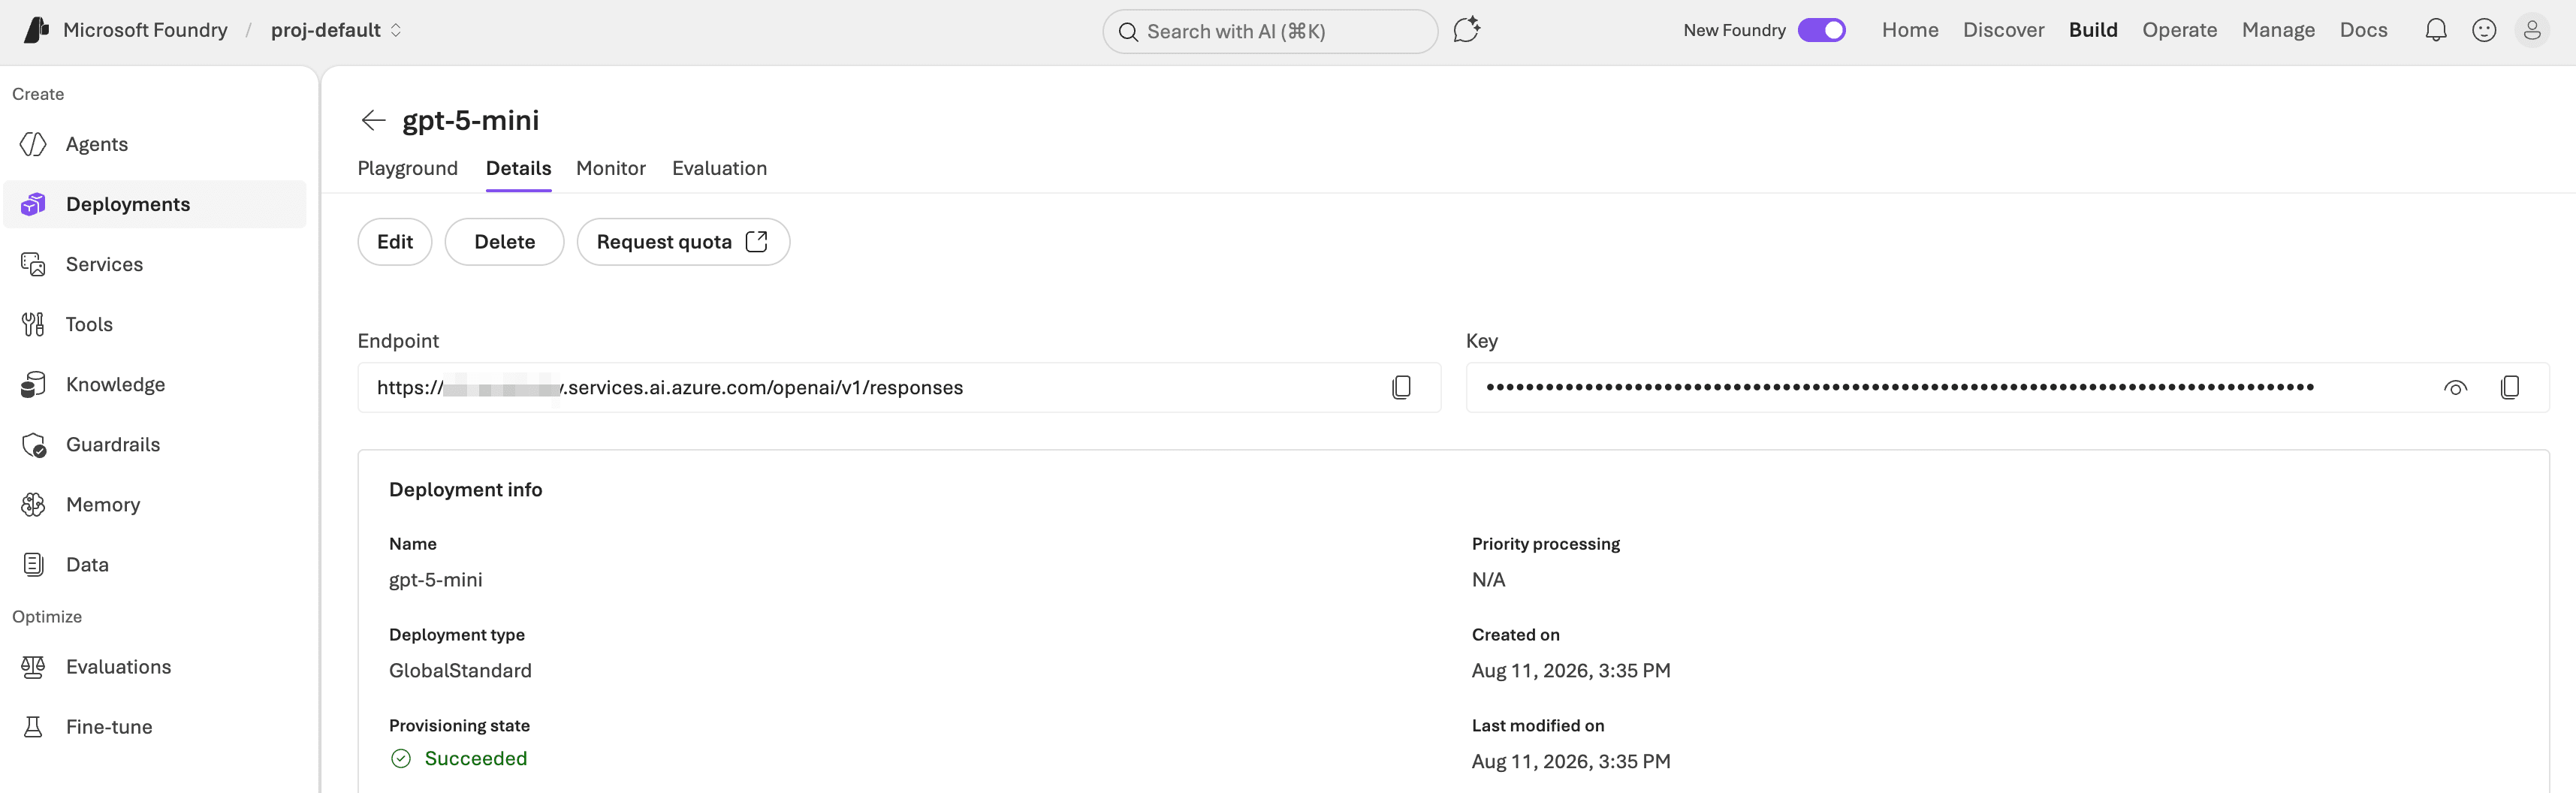 Microsoft Foundry – modèle gpt-5-mini
Utilisez un processus de gestion des secrets approuvé par votre organisation. N'effectuez jamais un commit de la clé API dans un dépôt.
2. Installer la passerelle d'IA
La passerelle d'IA achemine les requêtes entre GitLab et le point de terminaison du modèle sélectionné. Installez-la avec Docker ou le chart Helm en suivant le guide d'installation actuel de la passerelle d'IA.
Évitez de recopier un ancien tag d'image ou un exemple de version d'API issu d'un autre tutoriel. Les versions de la passerelle d'IA et de GitLab doivent rester compatibles, et le guide d'installation de GitLab fournit l'image actuelle ainsi que les paramètres requis. Le point de terminaison Foundry et la clé API sont saisis lors de l'ajout de chaque modèle à GitLab, à l'étape 4 ; il n'est pas nécessaire de les intégrer dans l'exemple de commande Docker.
Une seule passerelle dessert tous les modèles que vous configurez : inutile d'en prévoir une par déploiement ou par famille de modèles.
3. Configurer GitLab pour accéder à la passerelle d'IA
Une fois que la passerelle d'IA est opérationnelle, configurez votre instance GitLab pour l'utiliser :
- Dans la barre latérale gauche, en bas, sélectionnez Admin.
- Sélectionnez GitLab Duo.
- Dans la section GitLab Duo, sélectionnez Modifier la configuration.
- Sous URL de la passerelle d'IA locale, saisissez l'URL de votre passerelle d'IA et le port (par exemple,
https://ai-gateway.example.com:5052). - Sélectionnez Enregistrer les modifications.
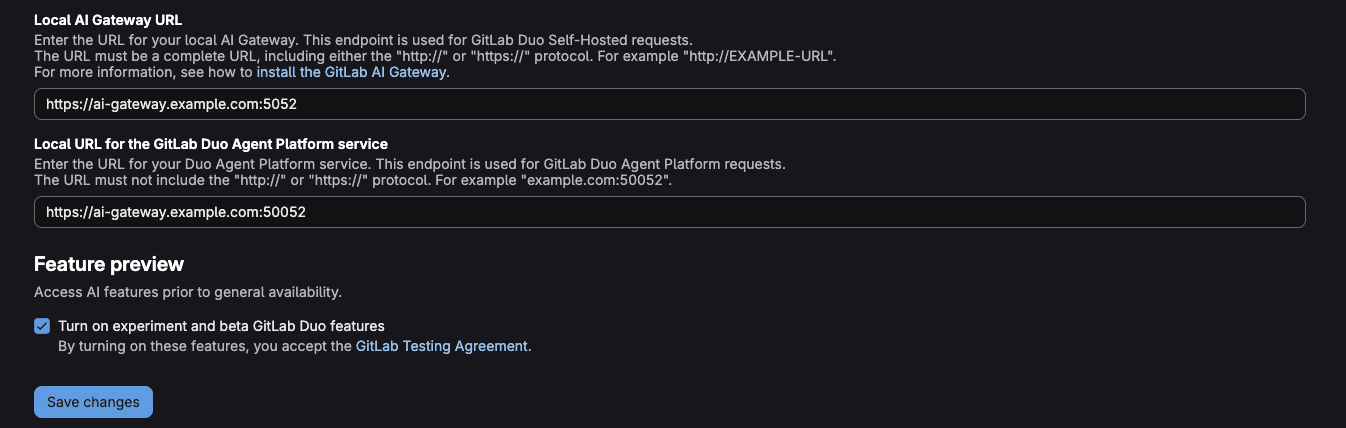 GitLab Duo – configuration de la passerelle d'IA
Pour les déploiements en production, utilisez le protocole TLS et restreignez l'accès réseau à la passerelle. Si celle-ci utilise une adresse IP privée ou un nom d'hôte interne, ajoutez-la à la liste d'autorisation des requêtes sortantes de GitLab.
4. Ajouter chaque déploiement à GitLab
Répétez cette procédure pour chaque déploiement Foundry que vous souhaitez utiliser dans GitLab.
- Dans le coin supérieur droit, sélectionnez Admin.
- Dans la barre latérale gauche, sélectionnez GitLab Duo.
- Sélectionnez Configurer les modèles pour GitLab Duo.
- Sélectionnez Ajouter des modèles auto-hébergés.
- Renseignez les champs suivants :
- Nom du déploiement : saisissez un nom facilement identifiable, par exemple
Agentic Chat on Microsoft Foundry. - Famille de modèles : sélectionnez la famille correspondant au modèle, par exemple GPT ou Claude.
- Point de terminaison : saisissez l'URL du point de terminaison de votre déploiement Foundry.
- Clé API : saisissez la clé API du déploiement.
- Identifiant du modèle : saisissez
azure/YOUR-DEPLOYMENT-NAME, en utilisant le nom exact du déploiement depuis Foundry. Par exemple,azure/duo-chat.
- Nom du déploiement : saisissez un nom facilement identifiable, par exemple
- Sélectionnez Ajouter un modèle auto-hébergé.
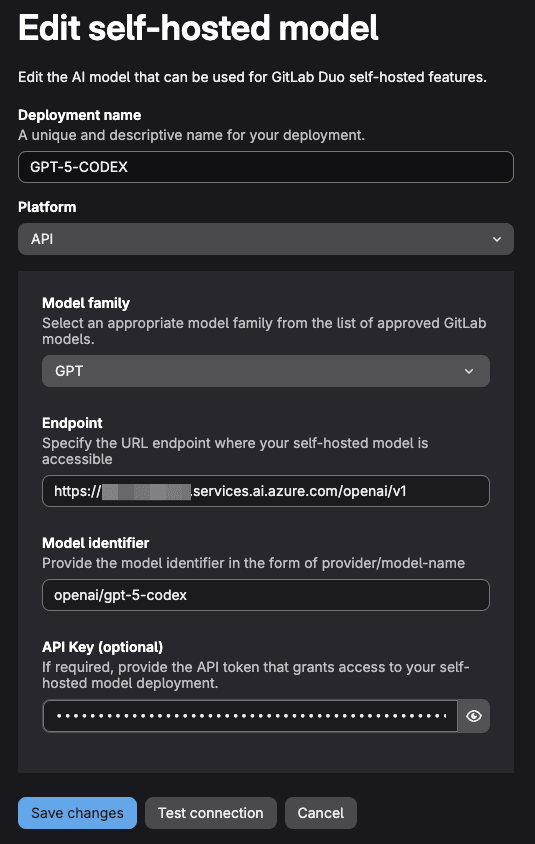 GitLab Duo Self-Hosted – configuration d'un modèle
Le préfixe décrit la façon dont un modèle est servi, et non qui l'a construit. Foundry peut exposer des modèles non-OpenAI via le point de terminaison Azure OpenAI, auquel cas azure/ s'applique toujours. Si vous déployez un modèle de partenaire accessible via un point de terminaison Foundry différent, vérifiez le préfixe correct dans la documentation de configuration de GitLab. Un préfixe incorrect génère l'erreur « Modèle introuvable » décrite plus loin.
5. Assigner des modèles aux fonctionnalités GitLab Duo
- Dans Admin > GitLab Duo, sélectionnez Configurer les modèles pour GitLab Duo.
- Sélectionnez l'onglet Fonctionnalités d'IA native.
- Pour chaque fonctionnalité que vous souhaitez acheminer vers Foundry, sélectionnez un déploiement dans la liste déroulante.
C'est ici que l'étendue du catalogue prend tout son sens, car les fonctionnalités n'ont pas à partager un même modèle, ni même une même famille. Voici une répartition raisonnable :
- Complétion de code : un modèle plus léger et plus rapide de la famille choisie, là où le volume de requêtes est élevé et où la latence est la plus perceptible.
- Génération de code : un modèle spécialisé dans le code, comme une variante Codex ou Codestral.
- GitLab Duo Agentic Chat : un modèle généraliste largement performant. Si vous ne définissez pas de modèle pour une sous-fonctionnalité de chat spécifique, celle-ci hérite du modèle configuré pour General Chat dans la section Admin.
- GitLab Duo Agent Platform : tout modèle classé en fonctionnalité complète pour GitLab Duo Agent Platform dans la matrice GitLab. Les modèles plus légers y sont souvent moins bien classés que pour la complétion ou le chat.
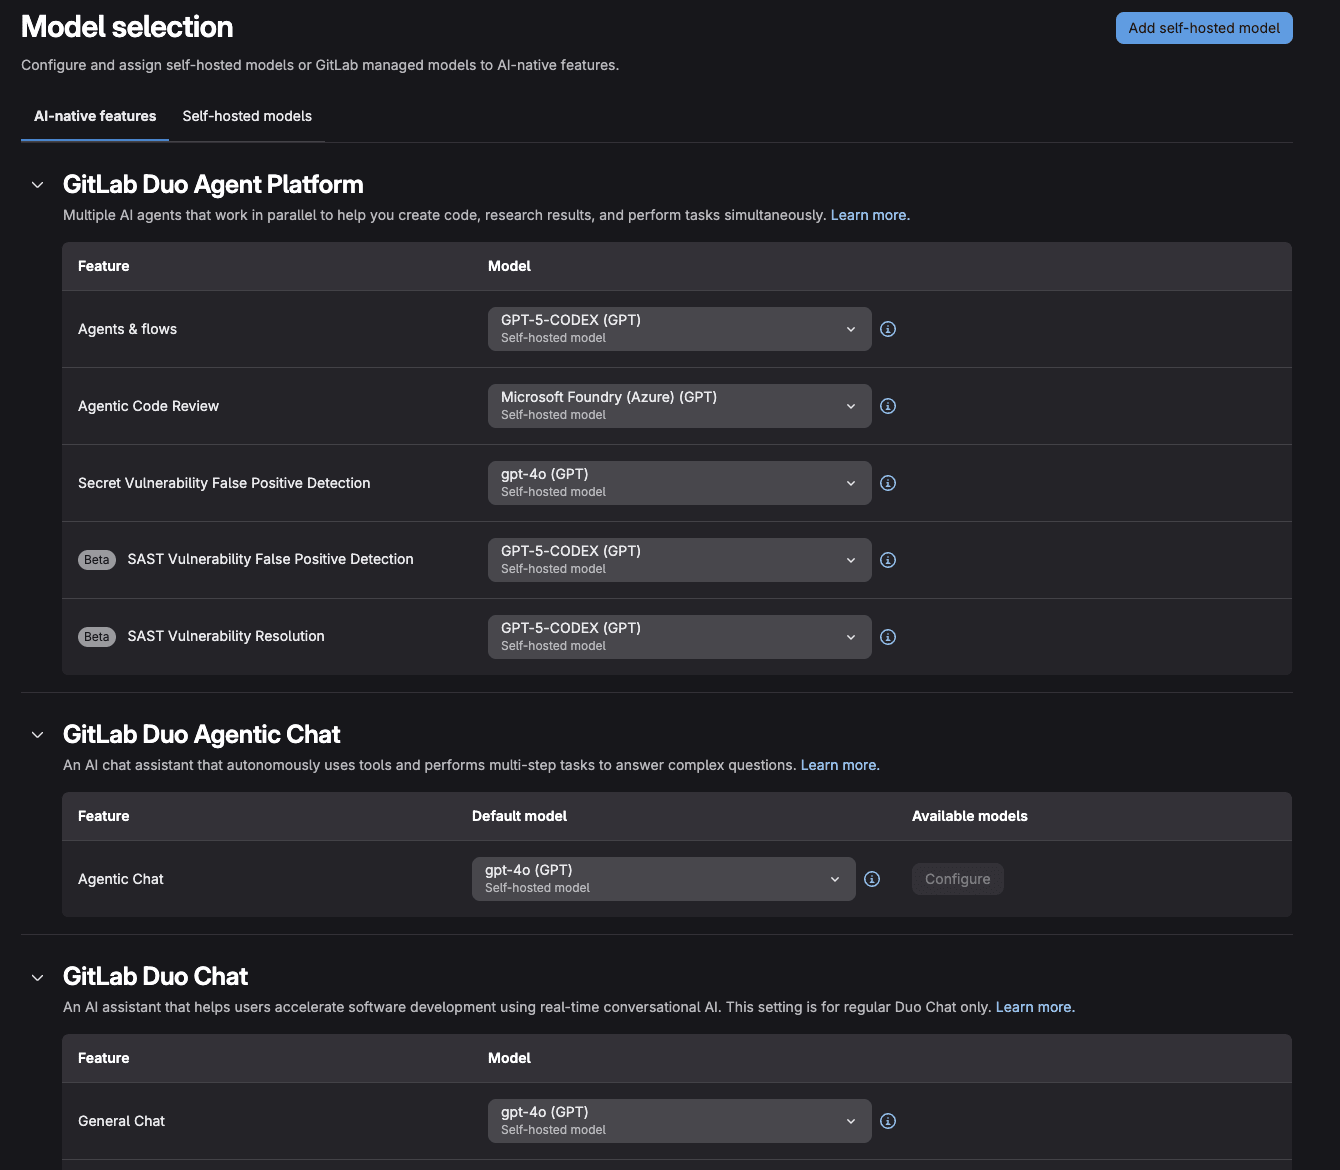 GitLab Duo – sélection du modèle
Considérez cette répartition comme une hypothèse de départ, et non comme une configuration optimisée. Commencez par un seul modèle sur l'ensemble des fonctionnalités que vous prévoyez d'activer afin d'obtenir une référence claire en matière de qualité, de latence et de coût, puis n'introduisez un second modèle que là où vos propres mesures le justifient.
Vérifier votre configuration
Pour vous assurer que votre implémentation de GitLab Duo Self-Hosted avec Microsoft Foundry fonctionne correctement, effectuez les étapes de vérification suivantes :
1. Lancer la vérification de l'état des services
Après avoir vérifié que votre modèle est bien opérationnel, retournez à la section GitLab Duo depuis la page Admin et cliquez sur Lancer l'état des services. Cette opération vérifie les éléments suivants :
- L'URL de la passerelle d'IA est correctement configurée.
- Votre instance parvient à se connecter à la passerelle d'IA.
- Le module complémentaire GitLab Duo requis est actif.
- Un modèle est assigné à GitLab Duo Code Suggestions (c'est ce modèle qui sert à tester la connexion).
Si la vérification signale des problèmes, reportez-vous au guide de dépannage pour les erreurs courantes.
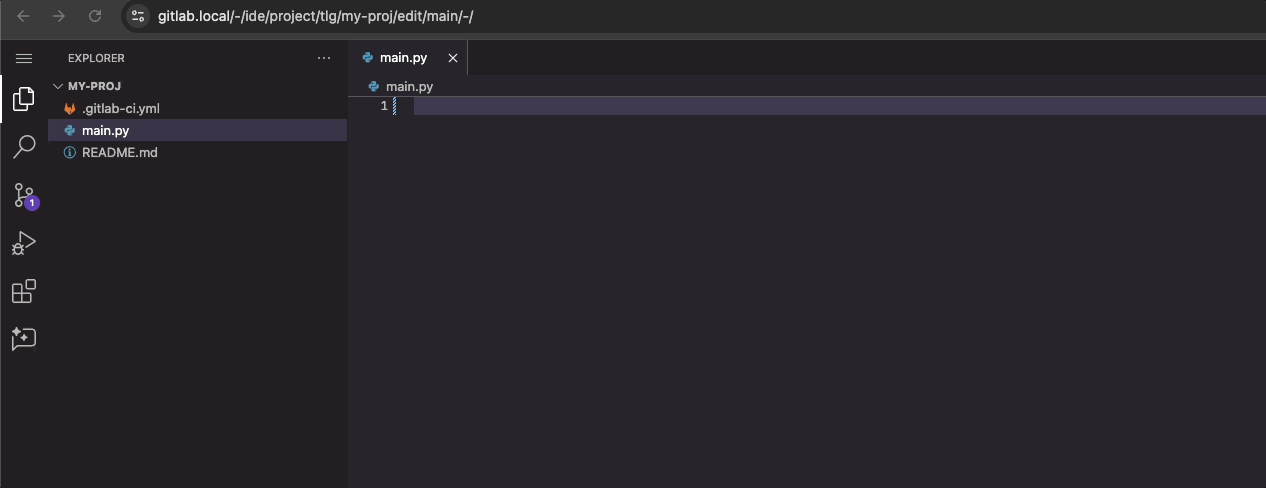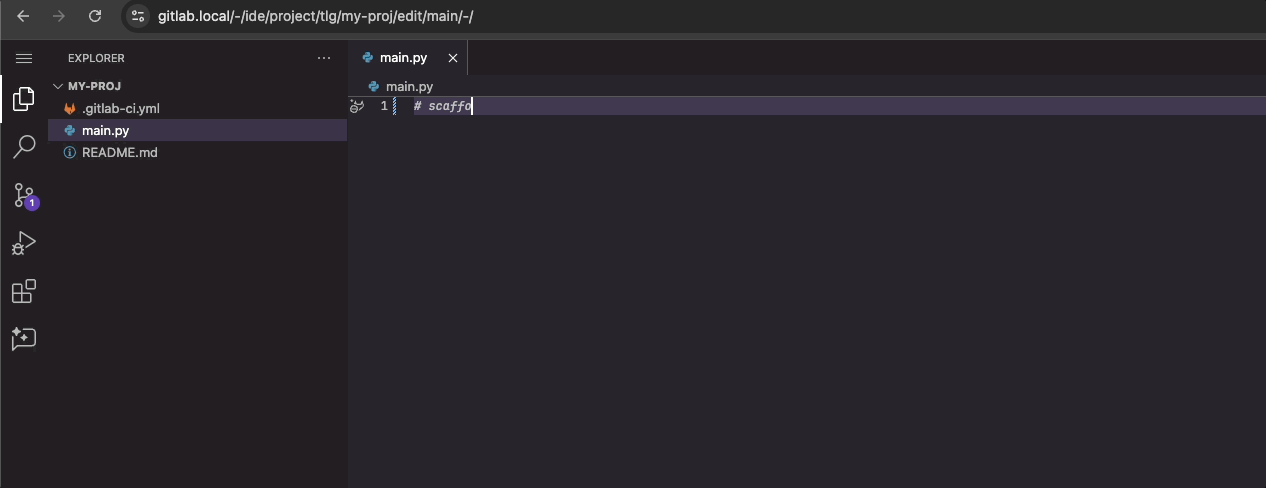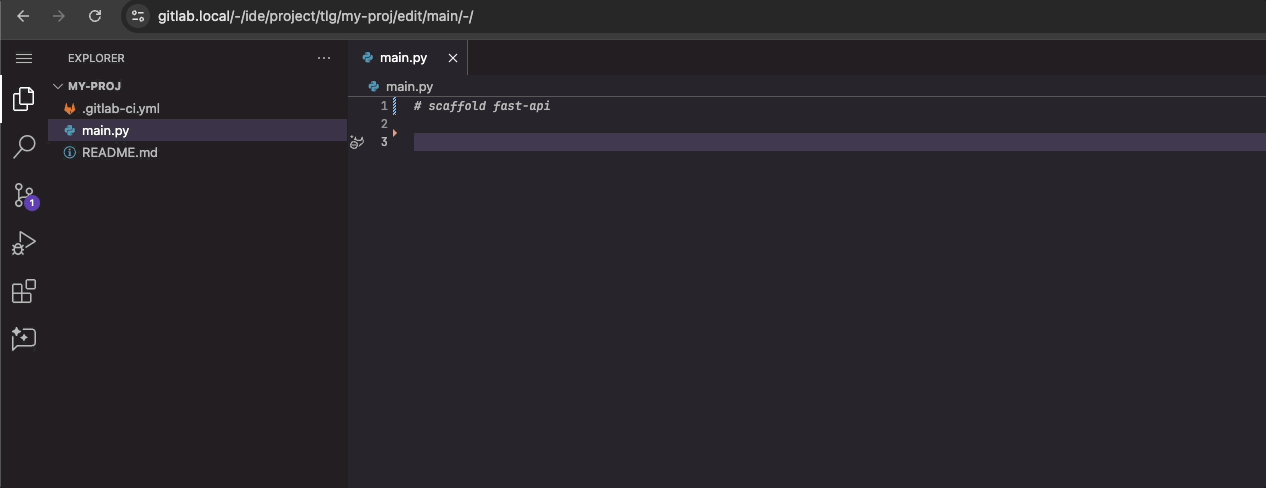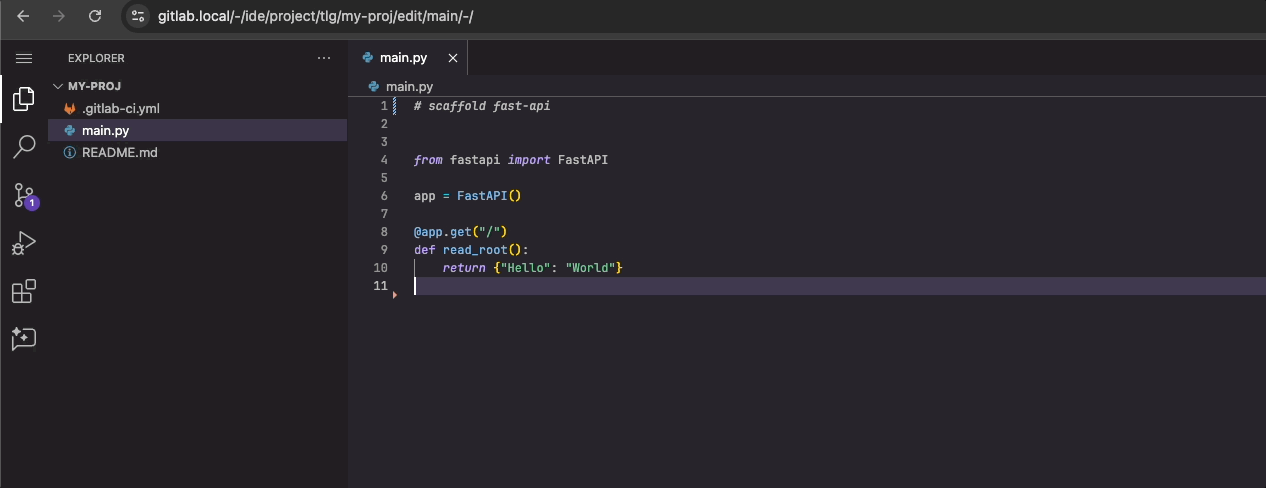
2. Générer la structure de code d'un service FastAPI avec la génération de code
La génération de code constitue un bon premier test, car elle sollicite l'ensemble du chemin de bout en bout et produit un résultat sans ambiguïté. Elle envoie aussi davantage de contexte que la complétion de code, si bien qu'un point de terminaison mal configuré ou un quota insuffisant devient visible immédiatement.
GitLab Duo Code Suggestions est composé de deux éléments distincts, et il est important de savoir lequel vous déclenchez pour bien interpréter le résultat :
- La complétion de code se déclenche pendant la saisie et termine la ligne en cours. Latence faible, généralement inférieure à une seconde.
- La génération de code se déclenche lorsque vous appuyez sur Entrée après un commentaire décrivant ce que vous souhaitez obtenir. Elle peut renvoyer des fonctions ou des classes entières, et prendre plus de cinq secondes.
Pour générer la structure de code d'un service FastAPI :
- Ouvrez un projet dans votre IDE et créez un fichier vide, par exemple
main.py. La génération de code est plus précise lorsque le fichier compte moins de cinq lignes ; un fichier vide constitue donc le point de départ idéal. - Rédigez un commentaire qui nomme le framework et décrit le résultat souhaité :
# Create a FastAPI service with a health check endpoint and CRUD endpoints for # a "tasks" resource backed by an in-memory list. Use Pydantic models for # request and response bodies, and return appropriate HTTP status codes. - Appuyez sur Entrée après le commentaire. Le saut de ligne final indique que vos instructions sont terminées.
- Attendez la suggestion, puis appuyez sur Tab pour l'accepter ou sur Échap pour la rejeter.
 Générer la structure de code d'un service FastAPI avec la génération de code
Nommer explicitement le framework favorise l'efficacité de cette approche. En ce qui concerne la génération de code, GitLab recommande d'énoncer le résultat attendu, de se montrer précis tout en restant concis, et de nommer la bibliothèque ou le framework souhaité. Un commentaire plus vague, comme # web service, donne beaucoup moins d'éléments exploitables au modèle.
Deux points à anticiper : la sortie de la génération de code est plafonnée à environ 2048 tokens. Vous obtiendrez donc une structure de code solide plutôt qu'une application finie. Et comme ces modèles sont non déterministes, un même commentaire ne produira jamais un code strictement identique d'une fois à l'autre, ce qui est normal et ne traduit pas un problème de configuration.
Si vous avez assigné des modèles différents à différentes fonctionnalités, testez-les séparément afin qu'un échec pointe vers un seul déploiement. Vérifier le bon fonctionnement de la génération de code confirme aussi que le modèle associé à la Génération de code à l'étape 5 est bien celui qui traite réellement la requête.
3. Vérifier les logs de la passerelle d'IA
Consultez les logs de la passerelle d'IA pour observer l'acheminement des requêtes vers vos déploiements Microsoft Foundry :
Dans votre terminal, exécutez :
docker logs gitlab-ai-gateway --tail 100 -f
Vous devriez voir des entrées de log indiquant des requêtes réussies vers le point de terminaison du modèle configuré. Évitez d'activer la journalisation des prompts, sauf si la politique de traitement des données de votre organisation l'autorise.
Prochaines étapes
Voici les prochaines étapes à envisager.
Maintenir une sélection de modèles à jour
L'équipe GitLab teste activement la performance de chaque modèle pour chaque fonctionnalité et propose un classement par niveaux de la performance et de l'adéquation des modèles :
- Fonctionnalité complète : le modèle peut vraisemblablement traiter la fonctionnalité sans aucune perte de qualité.
- Fonctionnalité partielle : la fonctionnalité est opérationnelle, mais peut impliquer des compromis ou des limitations.
- Fonctionnalité limitée : le modèle ne convient pas à la fonctionnalité et peut entraîner une perte de qualité importante ou des problèmes de performance.
Ne déduisez jamais la compatibilité du seul nom du modèle ou de sa présence dans le catalogue Foundry. Utilisez la page GitLab des exigences relatives aux modèles et au matériel comme référence pour connaître les évaluations actuelles de GitLab.
Stratégies d'optimisation des coûts :
- Commencez par un seul modèle classé en fonctionnalité complète dans les quatre catégories, sur l'ensemble des fonctionnalités que vous prévoyez d'activer.
- Mesurez la qualité, la latence, la consommation de tokens, le comportement face aux limites de débit et le coût, à l'aide de charges de travail représentatives.
- Basculez les fonctionnalités à fort volume, comme la complétion de code, vers un modèle plus léger une fois le compromis de qualité validé, et vérifiez son évaluation GitLab Duo Agent Platform avant de le réutiliser à cet endroit.
- Envisagez un modèle spécialisé dans le code pour GitLab Duo Code Suggestions si la qualité de génération importe plus que le coût pour vos équipes.
- Consultez régulièrement la matrice de prise en charge GitLab et le calendrier de mise hors service des modèles de Microsoft.
- Surveillez la consommation via Azure Cost Management et configurez des budgets ou des alertes adaptés à votre organisation.
Aller au-delà de Microsoft Foundry
Bien que ce guide se concentre sur l'intégration avec Microsoft Foundry, GitLab Duo Self-Hosted prend en charge plusieurs options de déploiement :
- Sur site avec vLLM : servez un modèle pris en charge ou compatible avec l'API OpenAI sur une infrastructure que vous gérez.
- Amazon Bedrock : à l'instar de Microsoft Foundry, vous pouvez utiliser Amazon Bedrock pour des modèles hébergés dans le cloud.
- D'autres fournisseurs validés, dont Anthropic, OpenAI et Gemini Enterprise Agent Platform.
Intégration entreprise avec Azure
Microsoft Foundry offre des avantages uniques aux organisations utilisant déjà l'écosystème Azure :
- Facturation unifiée : suivez la consommation des modèles aux côtés de vos autres services Azure.
- Intégration Microsoft Entra : appliquez vos pratiques existantes de gestion des identités et des rôles aux ressources Foundry.
- Mise en réseau privée : évaluez les points de terminaison privés et le chemin réseau entre GitLab et Azure en fonction de votre architecture de sécurité.
- Déploiement régional : choisissez parmi les régions et types de déploiement où le modèle sélectionné est disponible, en gardant à l'esprit la distinction de résidence des données évoquée plus haut.
Ces fonctionnalités peuvent contribuer à un programme de conformité, mais elles ne suffisent pas, à elles seules, à rendre un déploiement GitLab Duo conforme. Validez l'architecture complète : flux de données, journalisation, conservation, contrats et contrôles opérationnels en fonction de vos exigences.
Résumé
GitLab Duo Self-Hosted associé à Microsoft Foundry permet aux organisations d'utiliser les fonctionnalités GitLab Duo à partir de modèles hébergés sur Azure. Étant donné que le catalogue Foundry couvre GPT, Claude, Llama et Mistral, et que GitLab prend en charge des modèles de chacune de ces familles, un seul abonnement Azure peut couvrir toutes les familles de modèles dont vous avez besoin. Commencez par un modèle unique aux performances solides, puis assignez des modèles différents à des fonctionnalités différentes à mesure que vos évaluations le justifient.
Les noms de modèles cités dans cet article sont des exemples, non des recommandations. Les deux catalogues évoluant fréquemment, considérez les matrices des deux fournisseurs comme la référence au moment de votre déploiement.
La leçon à retenir sur la durée : la sélection d'un modèle relève d'une décision de compatibilité, non d'un exercice de choix dans un catalogue. Vérifiez la matrice de prise en charge de GitLab, confirmez la disponibilité et le statut de cycle de vie dans Microsoft Foundry, déployez les modèles, puis validez-les avec vos propres charges de travail avant un déploiement à grande échelle.
Premiers pas
- Consultez la documentation de GitLab Duo Self-Hosted pour la référence complète de configuration.
- Découvrez ce que vous pouvez créer avec GitLab Duo Agent Platform.
- Nouveau sur GitLab ? Démarrez un essai gratuit de GitLab Ultimate.
- Vous prévoyez un déploiement pour toutes vos équipes ? Contactez un représentant GitLab pour échanger sur les licences et l'architecture.