<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom">
    <id>https://about.gitlab.com/blog</id>
    <title>GitLab</title>
    <updated>2026-11-17T10:37:01.599Z</updated>
    <generator>https://github.com/jpmonette/feed</generator>
    <author>
        <name>The GitLab Team</name>
    </author>
    <link rel="alternate" href="https://about.gitlab.com/blog"/>
    <link rel="self" href="https://about.gitlab.com/pt-br/atom.xml"/>
    <subtitle>GitLab Blog RSS feed</subtitle>
    <icon>https://about.gitlab.com/favicon.ico</icon>
    <rights>All rights reserved 2026</rights>
    <entry>
        <title type="html"><![CDATA[Como evitar vazamentos pelo arquivo do 'Don't ask again' do Claude Code]]></title>
        <id>https://about.gitlab.com/pt-br/blog/prevent-leaks-from-claude-code-dont-ask-again-file/</id>
        <link href="https://about.gitlab.com/pt-br/blog/prevent-leaks-from-claude-code-dont-ask-again-file/"/>
        <updated>2026-11-12T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<blockquote><p><strong>Este guia mostra como encontrar e remover segredos que foram commitados por engano em projetos e repositórios hospedados no GitLab. Confirmamos que os segredos da infraestrutura do próprio GitLab estão protegidos.</strong></p></blockquote><p>No <a href="https://about.gitlab.com/pt-br/blog/claude-code-and-gitlab/" rel="">Claude Code</a>, o agente de programação da Anthropic, é possível aprovar um comando de shell selecionando “Yes, and don’t ask again”. O Claude então salva exatamente esse comando em <code>.claude/settings.local.json</code>, na pasta do projeto, e passa a executá-lo sem pedir confirmação. Se o comando continha uma senha ou um token, o arquivo também passa a conter:</p><pre className="language-json shiki shiki-themes github-light" code="{
  &quot;permissions&quot;: {
    &quot;allow&quot;: [
      &quot;Bash(npm test:*)&quot;,
      &quot;Bash(curl --header \&quot;PRIVATE-TOKEN: glpat-EXAMPLEdummyTOKEN1234\&quot; \&quot;https://gitlab.com/api/v4/projects/1234567/issues?state=closed\&quot;)&quot;
    ]
  }
}
" language="json" meta="" style=""><code><span class="line" line="1"><span class="sgsFI">{
</span></span><span class="line" line="2"><span class="sYu0t">  &quot;permissions&quot;</span><span class="sgsFI">: {
</span></span><span class="line" line="3"><span class="sYu0t">    &quot;allow&quot;</span><span class="sgsFI">: [
</span></span><span class="line" line="4"><span class="sYBdl">      &quot;Bash(npm test:*)&quot;</span><span class="sgsFI">,
</span></span><span class="line" line="5"><span class="sYBdl">      &quot;Bash(curl --header </span><span class="sYu0t">\&quot;</span><span class="sYBdl">PRIVATE-TOKEN: glpat-EXAMPLEdummyTOKEN1234</span><span class="sYu0t">\&quot;</span><span class="sYu0t"> \&quot;</span><span class="sYBdl">https://gitlab.com/api/v4/projects/1234567/issues?state=closed</span><span class="sYu0t">\&quot;</span><span class="sYBdl">)&quot;
</span></span><span class="line" line="6"><span class="sgsFI">    ]
</span></span><span class="line" line="7"><span class="sgsFI">  }
</span></span><span class="line" line="8"><span class="sgsFI">}
</span></span></code></pre><p>O Claude Code mantém o arquivo fora do Git pelas exclusões globais pessoais de quem desenvolve, e não pelo <code>.gitignore</code> do projeto. Essa proteção fica em um único notebook e não acompanha o repositório; por isso, o arquivo acaba sendo commitado e enviado por push para onde quer que o repositório esteja. No início de novembro de 2026, a <a href="https://apiiro.com/blog/coding-agents-leaking-secrets-github-dont-ask-again" rel="">Apiiro relatou</a> (em inglês) que esse problema fez 104.185 cópias do arquivo aparecerem em repositórios públicos, 1.122 delas com pelo menos um segredo. Outras centenas de segredos estavam apenas no histórico, em arquivos que já tinham sido excluídos.</p><p>Se a sua equipe usa o Claude Code com repositórios hospedados no GitLab, este guia mostra como evitar que isso aconteça daqui para frente, avaliar a exposição atual ou passada e limpar todos os projetos afetados de uma só vez.</p><h2 id="prevenir-mantenha-o-arquivo-fora-do-repositório">Prevenir: mantenha o arquivo fora do repositório</h2><p>Algumas medidas garantem que ninguém consiga commitar o arquivo por acidente e que, se uma cópia escapar, alguém fique sabendo. São quatro camadas, cada uma um pouco mais trabalhosa que a anterior, e a ordem abaixo é uma boa sequência a seguir. Todas são configurações que um Owner do grupo altera uma única vez. Esta é a única parte do processo em que o GitLab Duo pode orientar o passo a passo, mas não pode executar o trabalho, já que o acesso dele às configurações do GitLab é somente leitura.</p><h3 id="comece-pelo-gitignore">Comece pelo <code>.gitignore</code></h3><p>A correção mais simples é também a que o Claude Code deveria ter feito, mas não faz: uma linha <code>.claude/settings.local.json</code> no <code>.gitignore</code> de cada repositório. O Claude Code só adiciona a exclusão à configuração global do Git de quem desenvolve, que fica naquele notebook.</p><p>No Premium ou no Ultimate, coloque a mesma linha no <code>.gitignore</code> do projeto de templates de arquivos do grupo (no grupo, acesse <strong>Settings &gt; General &gt; Templates</strong>). Assim, todo projeto criado a partir de agora herda essa linha sem que ninguém precise se lembrar disso.</p><h3 id="bloqueie-o-nome-do-arquivo-com-uma-regra-de-push-premium-e-ultimate">Bloqueie o nome do arquivo com uma regra de push (Premium e Ultimate)</h3><p>Uma <a href="https://docs.gitlab.com/user/project/repository/push_rules/" rel="">regra de push</a> transforma a convenção em algo que o GitLab faz valer. No grupo, acesse <strong>Settings &gt; Repository &gt; Pre-defined push rules</strong> e, em Prohibited filenames, insira:</p><pre className="language-plaintext shiki shiki-themes github-light" code="(^|/)\.claude/settings\.local\.json$
" language="plaintext" meta="" style=""><code><span class="line" line="1"><span>(^|/)\.claude/settings\.local\.json$
</span></span></code></pre><p>A partir daí, todo push que tentar adicionar esse arquivo, na raiz do repositório ou em qualquer subdiretório, em qualquer branch, é rejeitado antes de chegar ao repositório, e quem fez o push vê uma mensagem com o padrão bloqueado.</p><p>Há dois pontos sobre o comportamento das regras de push que fazem diferença aqui. A regra verifica apenas arquivos que estão sendo adicionados, não alterações em um arquivo que já é rastreado. Por isso, a limpeza das cópias existentes, descrita na seção Mitigar, precisa vir primeiro. Além disso, uma regra definida no grupo é copiada para os projetos criados depois daquele momento; ela não alcança os projetos que já existem. Para esses, defina a mesma regra em cada projeto, em <strong>Settings &gt; Repository &gt; Push rules</strong> do próprio projeto ou, se forem mais do que alguns poucos, com um loop sobre os IDs dos projetos do grupo:</p><pre className="language-plaintext shiki shiki-themes github-light" code="POST /api/v4/projects/&lt;id&gt;/push_rule
{&quot;file_name_regex&quot;: &quot;(^|/)\\.claude/settings\\.local\\.json$&quot;}
" language="plaintext" meta="" style=""><code><span class="line" line="1"><span>POST /api/v4/projects/&lt;id&gt;/push_rule
</span></span><span class="line" line="2"><span>{&quot;file_name_regex&quot;: &quot;(^|/)\\.claude/settings\\.local\\.json$&quot;}
</span></span></code></pre><p>Para um projeto que já tem regras de push próprias, use <code>PUT</code> no mesmo caminho; com <code>POST</code>, a resposta será <code>422 Project push rule exists</code>.</p><h3 id="adicione-a-secret-push-protection-para-os-tokens-ultimate">Adicione a Secret Push Protection para os tokens (Ultimate)</h3><p>A regra de push barra o arquivo pelo nome. A <a href="https://docs.gitlab.com/user/application_security/secret_detection/secret_push_protection/" rel="">Secret Push Protection</a> analisa o conteúdo de cada push, seja qual for o nome do arquivo, e o rejeita se encontrar um formato de token conhecido. No GitLab Self-Managed e no Dedicated, primeiro é preciso permitir o recurso na instância, em <strong>Admin &gt; Settings &gt; Security and compliance</strong>; no GitLab.com, essa etapa já está feita. Depois, ative-o em cada projeto, em <strong>Secure &gt; Security configuration &gt; Secret push protection</strong>, ou em um grupo inteiro de uma vez pela API de configurações de segurança do grupo.</p><h3 id="faça-a-varredura-de-tudo-com-uma-única-política-ultimate">Faça a varredura de tudo com uma única política (Ultimate)</h3><p>Uma <a href="https://docs.gitlab.com/user/application_security/policies/scan_execution_policies/" rel="">política de execução de varredura</a> no grupo de nível superior executa a GitLab Secret Detection em todos os projetos, inclusive nos que não têm nenhum <code>.gitlab-ci.yml</code>, e os projetos não podem desativá-la individualmente. Crie a política em <strong>Group &gt; Secure &gt; Policies &gt; New policy &gt; Scan execution policy</strong>, com uma regra que roda em toda pipeline e outra que roda em uma programação semanal. A execução programada percorre o histórico na primeira vez que roda; adicione a variável <code>SECRET_DETECTION_HISTORIC_SCAN: &#39;true&#39;</code> a essa regra se quiser que toda execução semanal cubra o histórico completo, e não apenas os commits novos. A política detecta os mesmos formatos de token que a Secret Push Protection e também cobre o que já está no repositório, incluindo o histórico quando a varredura histórica está ativada.</p><h2 id="avaliar-o-arquivo-existe-nos-seus-repositórios">Avaliar: o arquivo existe nos seus repositórios?</h2><p>Além das medidas preventivas, é preciso saber se o <code>.claude/settings.local.json</code> existe em algum dos seus repositórios, agora ou em algum momento no passado. O conteúdo do arquivo só importa quando a lista de repositórios afetados estiver pronta, e há algumas formas de obtê-la, dependendo do que a sua assinatura do GitLab inclui.</p><h3 id="pergunte-ao-gitlab-duo">Pergunte ao GitLab Duo</h3><p>Se o seu grupo tem o GitLab Duo (Duo Core no Premium e no Ultimate, ou <a href="https://docs.gitlab.com/subscriptions/gitlab_credits/" rel="">GitLab Credits</a> em um grupo Free no GitLab.com), o caminho mais rápido é abrir o <a href="https://docs.gitlab.com/user/gitlab_duo_chat/agentic_chat/" rel="">Agentic Chat</a> do GitLab Duo, parte da GitLab Duo Agent Platform, no grupo de nível superior e colar isto:</p><pre className="language-plaintext shiki shiki-themes github-light" code="Algum projeto do grupo &lt;GRUPO&gt; já teve um arquivo chamado .claude/settings.local.json, incluindo projetos em que o arquivo foi excluído depois e projetos em que ele só existe em uma branch diferente da padrão? Para cada projeto, diga se ele tem o arquivo agora e, se não tiver, o commit em que ele foi adicionado e o commit em que foi removido. Explique como a verificação foi feita.
" language="plaintext" meta="" style=""><code><span class="line" line="1"><span>Algum projeto do grupo &lt;GRUPO&gt; já teve um arquivo chamado .claude/settings.local.json, incluindo projetos em que o arquivo foi excluído depois e projetos em que ele só existe em uma branch diferente da padrão? Para cada projeto, diga se ele tem o arquivo agora e, se não tiver, o commit em que ele foi adicionado e o commit em que foi removido. Explique como a verificação foi feita.
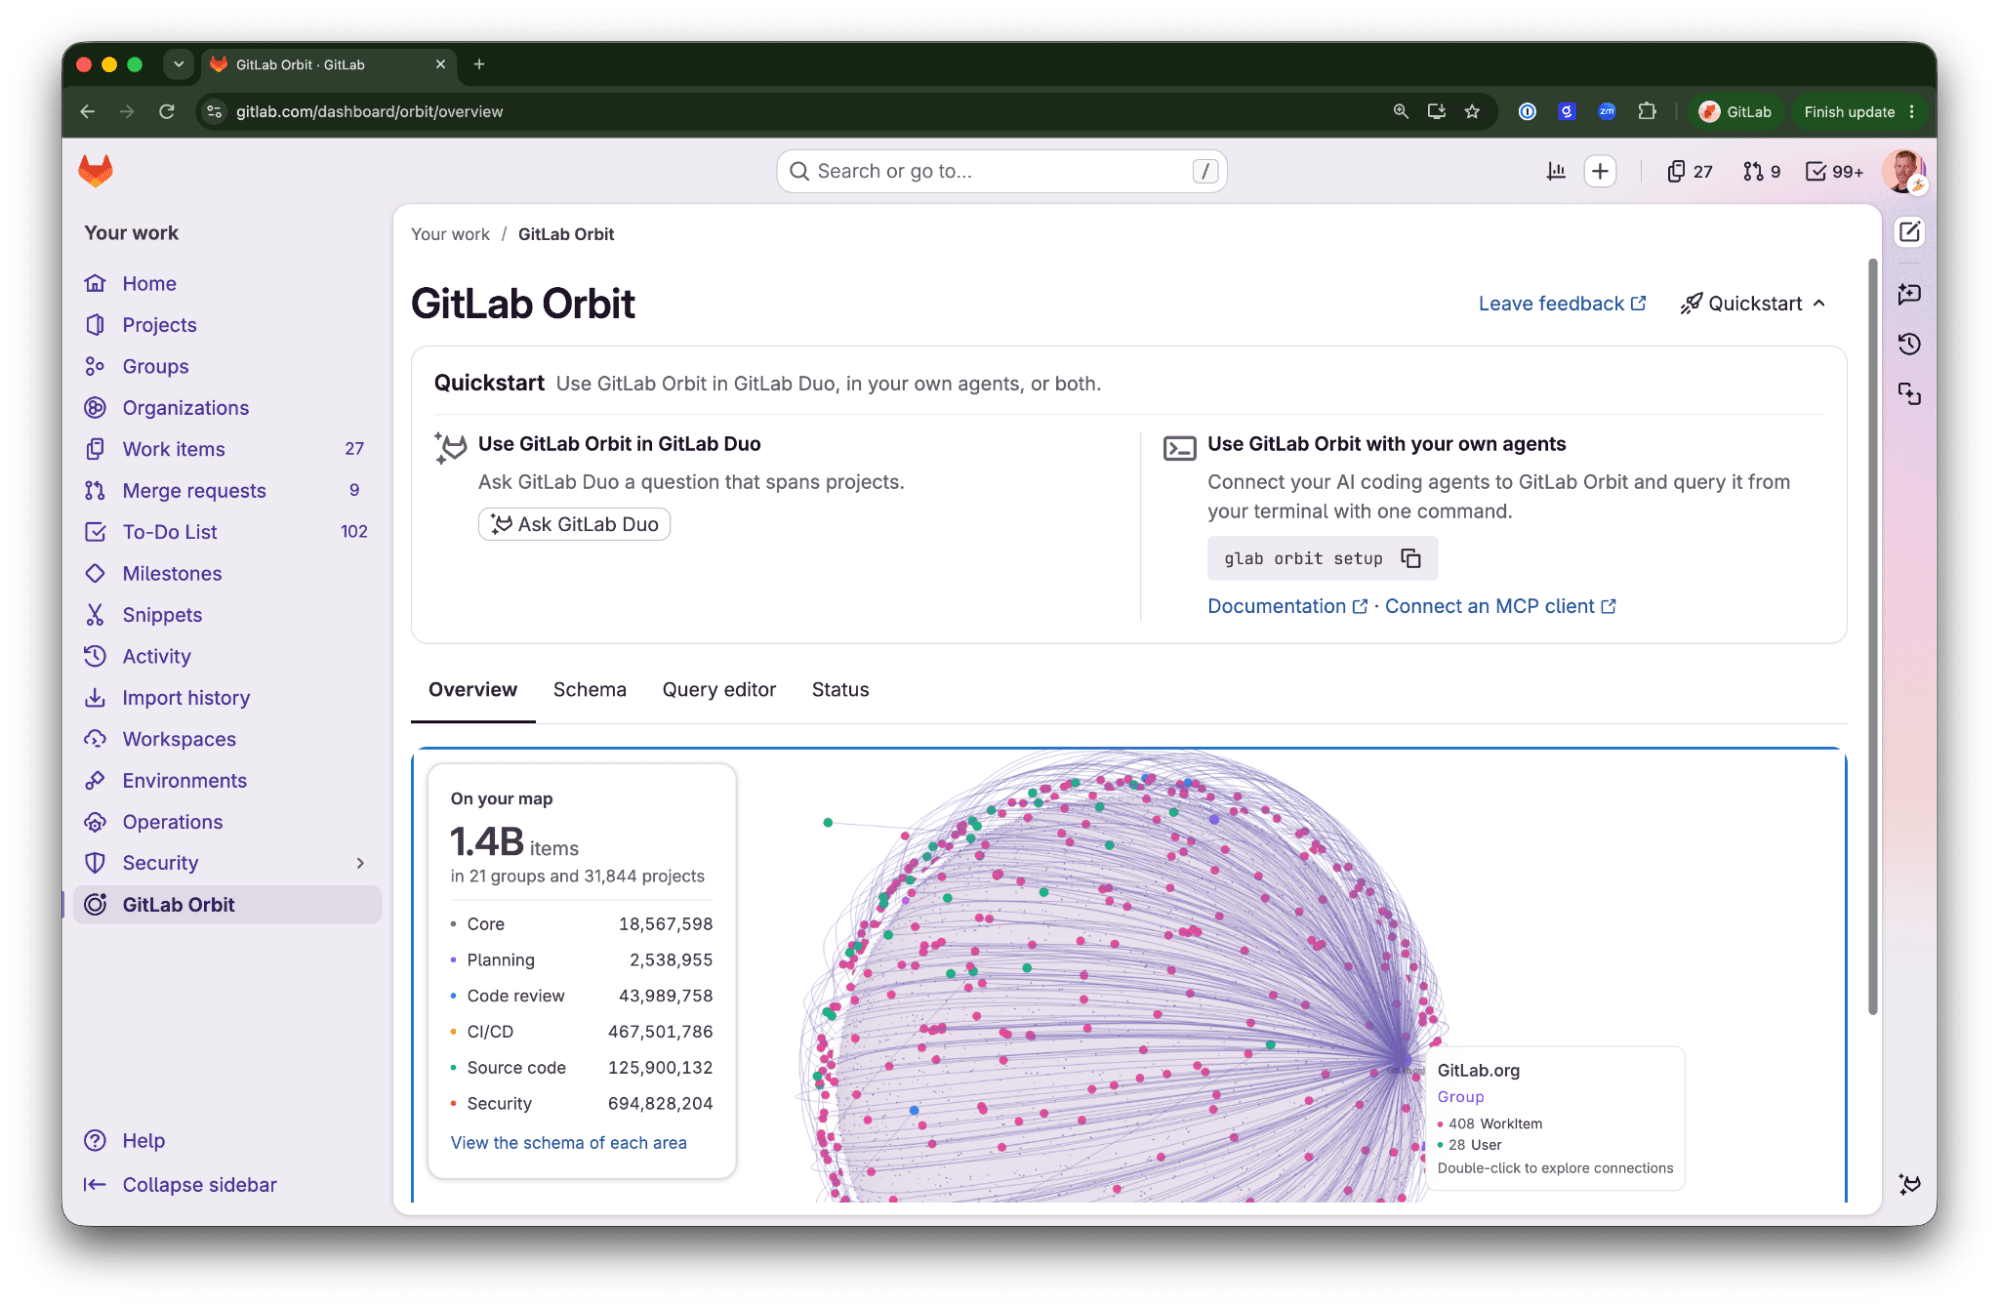
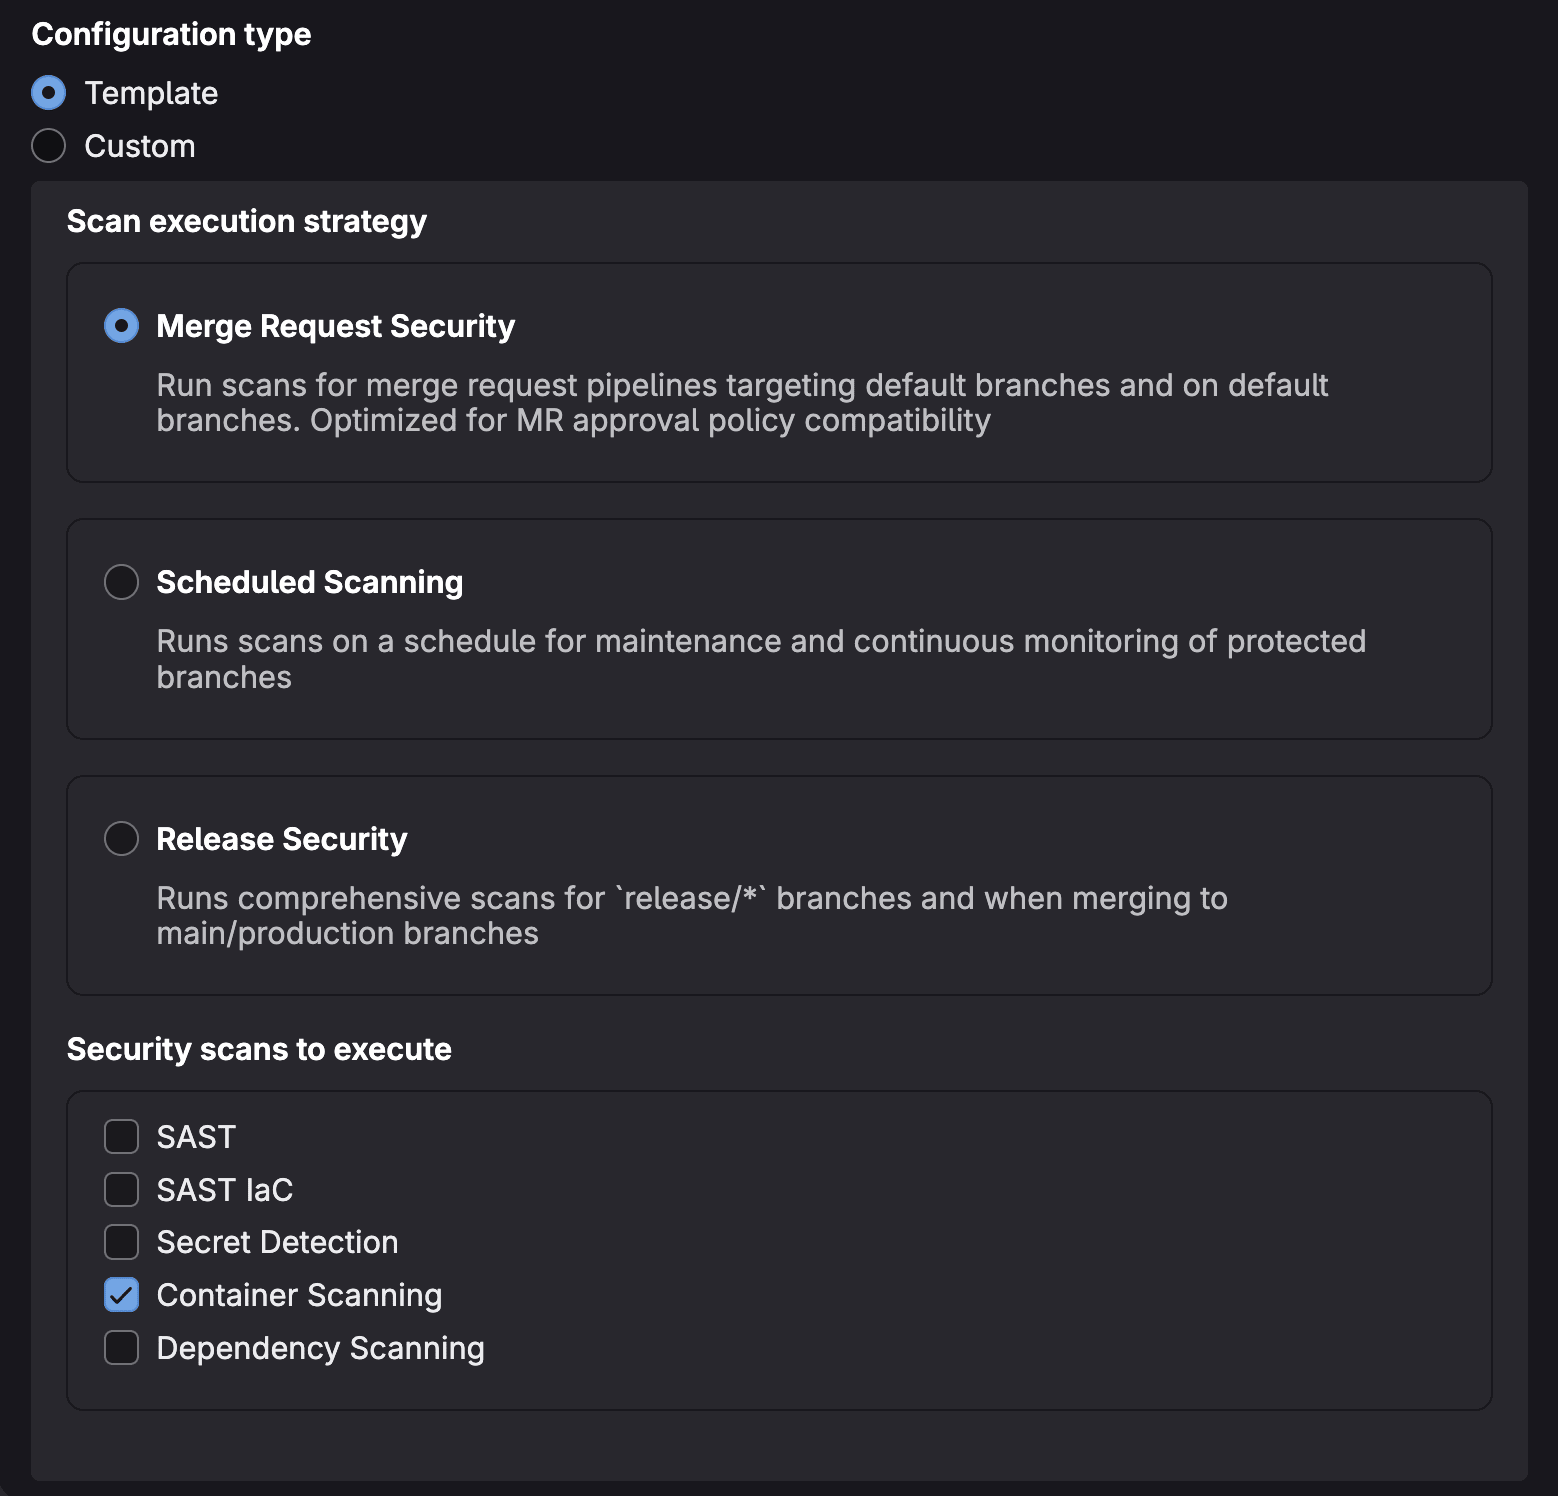
</span></span></code></pre><p>O GitLab Duo percorre o grupo e seus subgrupos, consulta o histórico de commits de cada projeto para esse caminho exato, lista as branches de todo projeto com ocorrência e busca o arquivo atual para distinguir uma cópia que ainda existe de uma que foi excluída.</p><p>O resultado é uma única tabela: o projeto, se o arquivo existe agora, os commits que o adicionaram e removeram e uma observação quando uma versão excluída ainda continha um segredo. Os forks dentro do grupo também entram na verificação, porque cada fork é um projeto com histórico próprio, e o GitLab Duo termina dizendo o que não verificou, como projetos fora do grupo. Como ele lê o histórico em vez de um índice de busca, um grupo com cerca de cem projetos leva vários minutos, e é justamente esse cuidado que permite encontrar as cópias excluídas que uma busca não encontra.</p><p>Se o seu grupo tem o <a href="https://docs.gitlab.com/orbit/" rel="">GitLab Orbit</a>, o GitLab Duo pode usar esse grafo de conhecimento no lugar do índice de busca para as cópias atuais, o que traz essa parte da resposta em cerca de um minuto, com os mesmos resultados.</p><h3 id="faça-a-busca-por-conta-própria-premium-e-ultimate">Faça a busca por conta própria (Premium e Ultimate)</h3><p>Sem o GitLab Duo, a forma mais rápida de encontrar as cópias atuais é a busca de código. Em cada grupo de nível superior, abra Search, escolha o escopo Code e marque “Include archived”. A consulta depende do mecanismo de busca que o grupo usa, e a página de resultados mostra qual é. Onde a <a href="https://docs.gitlab.com/user/search/exact_code_search/" rel="">busca exata de código</a> está ativa, o que acontece nos planos pagos do GitLab.com e em instâncias Self-Managed com Zoekt, ative as expressões regulares e busque por:</p><pre className="language-plaintext shiki shiki-themes github-light" code="file:\.claude/settings\.local\.json$
" language="plaintext" meta="" style=""><code><span class="line" line="1"><span>file:\.claude/settings\.local\.json$
</span></span></code></pre><p>Onde a <a href="https://docs.gitlab.com/user/search/advanced_search/" rel="">busca avançada</a> está ativa, o que inclui o GitLab Dedicated e instâncias Self-Managed com Elasticsearch, a consulta é:</p><pre className="language-plaintext shiki shiki-themes github-light" code="filename:settings.local.json path:.claude
" language="plaintext" meta="" style=""><code><span class="line" line="1"><span>filename:settings.local.json path:.claude
</span></span></code></pre><p>A busca de código funciona em um grupo de nível superior por vez, incluindo os subgrupos. Para quem tem vários grupos, a API faz esse loop sem dor de cabeça, e o formato com <code>filename:</code> e <code>path:</code> funciona nos dois mecanismos:</p><pre className="language-plaintext shiki shiki-themes github-light" code="GET /api/v4/groups?owned=true&amp;top_level_only=true&amp;per_page=100
GET /api/v4/groups/&lt;id&gt;/search?scope=blobs&amp;search=filename:settings.local.json%20path:.claude&amp;exclude_forks=false&amp;per_page=100
" language="plaintext" meta="" style=""><code><span class="line" line="1"><span>GET /api/v4/groups?owned=true&amp;top_level_only=true&amp;per_page=100
</span></span><span class="line" line="2"><span>GET /api/v4/groups/&lt;id&gt;/search?scope=blobs&amp;search=filename:settings.local.json%20path:.claude&amp;exclude_forks=false&amp;per_page=100
</span></span></code></pre><p>Mantenha <code>exclude_forks=false</code>, porque, sem esse parâmetro, a busca exata de código deixa os forks de fora. Em uma instância GitLab Self-Managed com busca avançada ou busca exata de código ativada, um administrador pode dispensar o loop e buscar na instância inteira com <code>GET /api/v4/search?scope=blobs&amp;search=filename:settings.local.json%20path:.claude</code>. Use um token de administrador, porque a API só retorna os projetos que quem faz a chamada consegue ver.</p><p>Seja qual for o mecanismo, lembre-se de que a busca mostra a branch padrão como ela está hoje. Um arquivo excluído, ou que está em outra branch, fica invisível para ela, e é por isso que existe a próxima verificação.</p><h3 id="verifique-o-histórico-todos-os-planos">Verifique o histórico (todos os planos)</h3><p>Um arquivo commitado e depois excluído continua sendo um vazamento; por isso, é preciso saber, em cada projeto, se o arquivo já existiu em alguma branch. A <a href="https://docs.gitlab.com/api/commits/" rel="">API de commits</a> responde a essa pergunta, funciona em todos os planos e modalidades de implantação e não exige que nada seja ativado antes:</p><pre className="language-plaintext shiki shiki-themes github-light" code="GET /api/v4/groups/&lt;id&gt;/projects?include_subgroups=true&amp;per_page=100
GET /api/v4/projects/&lt;id&gt;/repository/commits?path=.claude/settings.local.json&amp;all=true&amp;follow=false&amp;per_page=100
" language="plaintext" meta="" style=""><code><span class="line" line="1"><span>GET /api/v4/groups/&lt;id&gt;/projects?include_subgroups=true&amp;per_page=100
</span></span><span class="line" line="2"><span>GET /api/v4/projects/&lt;id&gt;/repository/commits?path=.claude/settings.local.json&amp;all=true&amp;follow=false&amp;per_page=100
</span></span></code></pre><p>Se a segunda chamada retornar commits, o conteúdo está no histórico do projeto; se retornar uma lista vazia, ele nunca esteve lá. Essa também é a verificação que encontra forks, já que eles são projetos como quaisquer outros.</p><p>Um detalhe importa mais do que parece: não remova <code>follow=false</code>. Quando <code>all=true</code> é combinado com um caminho, o GitLab percorre primeiro os commits mais recentes do repositório inteiro e só depois filtra pelo caminho; assim, um repositório com mais de uma página de commits pode voltar vazio, mesmo que o arquivo esteja no histórico. Com <code>follow=false</code>, a busca é filtrada pelo caminho desde o início, e a primeira página lista todos os commits que já mexeram no arquivo.</p><h3 id="verifique-os-forks">Verifique os forks</h3><p>Cada fork de um projeto afetado mantém a própria cópia do arquivo e o próprio histórico. Liste os forks com <code>GET /api/v4/projects/&lt;id&gt;/forks</code> e repita as verificações acima para cada um.</p><h2 id="mitigar-rotacionar-remover-limpar-o-histórico">Mitigar: rotacionar, remover, limpar o histórico</h2><p>Sejam quais forem os segredos encontrados, a ordem é esta: rotacionar, depois remover e, por fim, limpar o histórico. Trate como público todo segredo que o arquivo já conteve, a partir da data do primeiro commit em que ele apareceu, e faça a rotação no provedor antes de mexer no arquivo. Excluir o arquivo, por si só, não resolve nada: o valor continua no histórico do repositório e em todos os forks, e segue utilizável até que o segredo seja trocado.</p><h3 id="remova-o-arquivo-de-todos-os-projetos-de-uma-vez-com-o-gitlab-duo">Remova o arquivo de todos os projetos de uma vez (com o GitLab Duo)</h3><p>Com a rotação em andamento, abra o Agentic Chat no grupo de nível superior e cole:</p><pre className="language-plaintext shiki shiki-themes github-light" code="No grupo &lt;GRUPO&gt;, para cada projeto que tem atualmente um .claude/settings.local.json commitado na branch padrão, abra uma merge request que remova o arquivo e adicione .claude/settings.local.json ao .gitignore do projeto. Não faça merge de nada. Ignore os projetos que já têm uma merge request desse tipo aberta. Ao terminar, me dê uma única tabela: projeto, link da merge request e os tipos de segredo que o arquivo continha (sem os valores). Depois, diga o que ainda resta para eu fazer em todos eles.
" language="plaintext" meta="" style=""><code><span class="line" line="1"><span>No grupo &lt;GRUPO&gt;, para cada projeto que tem atualmente um .claude/settings.local.json commitado na branch padrão, abra uma merge request que remova o arquivo e adicione .claude/settings.local.json ao .gitignore do projeto. Não faça merge de nada. Ignore os projetos que já têm uma merge request desse tipo aberta. Ao terminar, me dê uma única tabela: projeto, link da merge request e os tipos de segredo que o arquivo continha (sem os valores). Depois, diga o que ainda resta para eu fazer em todos eles.
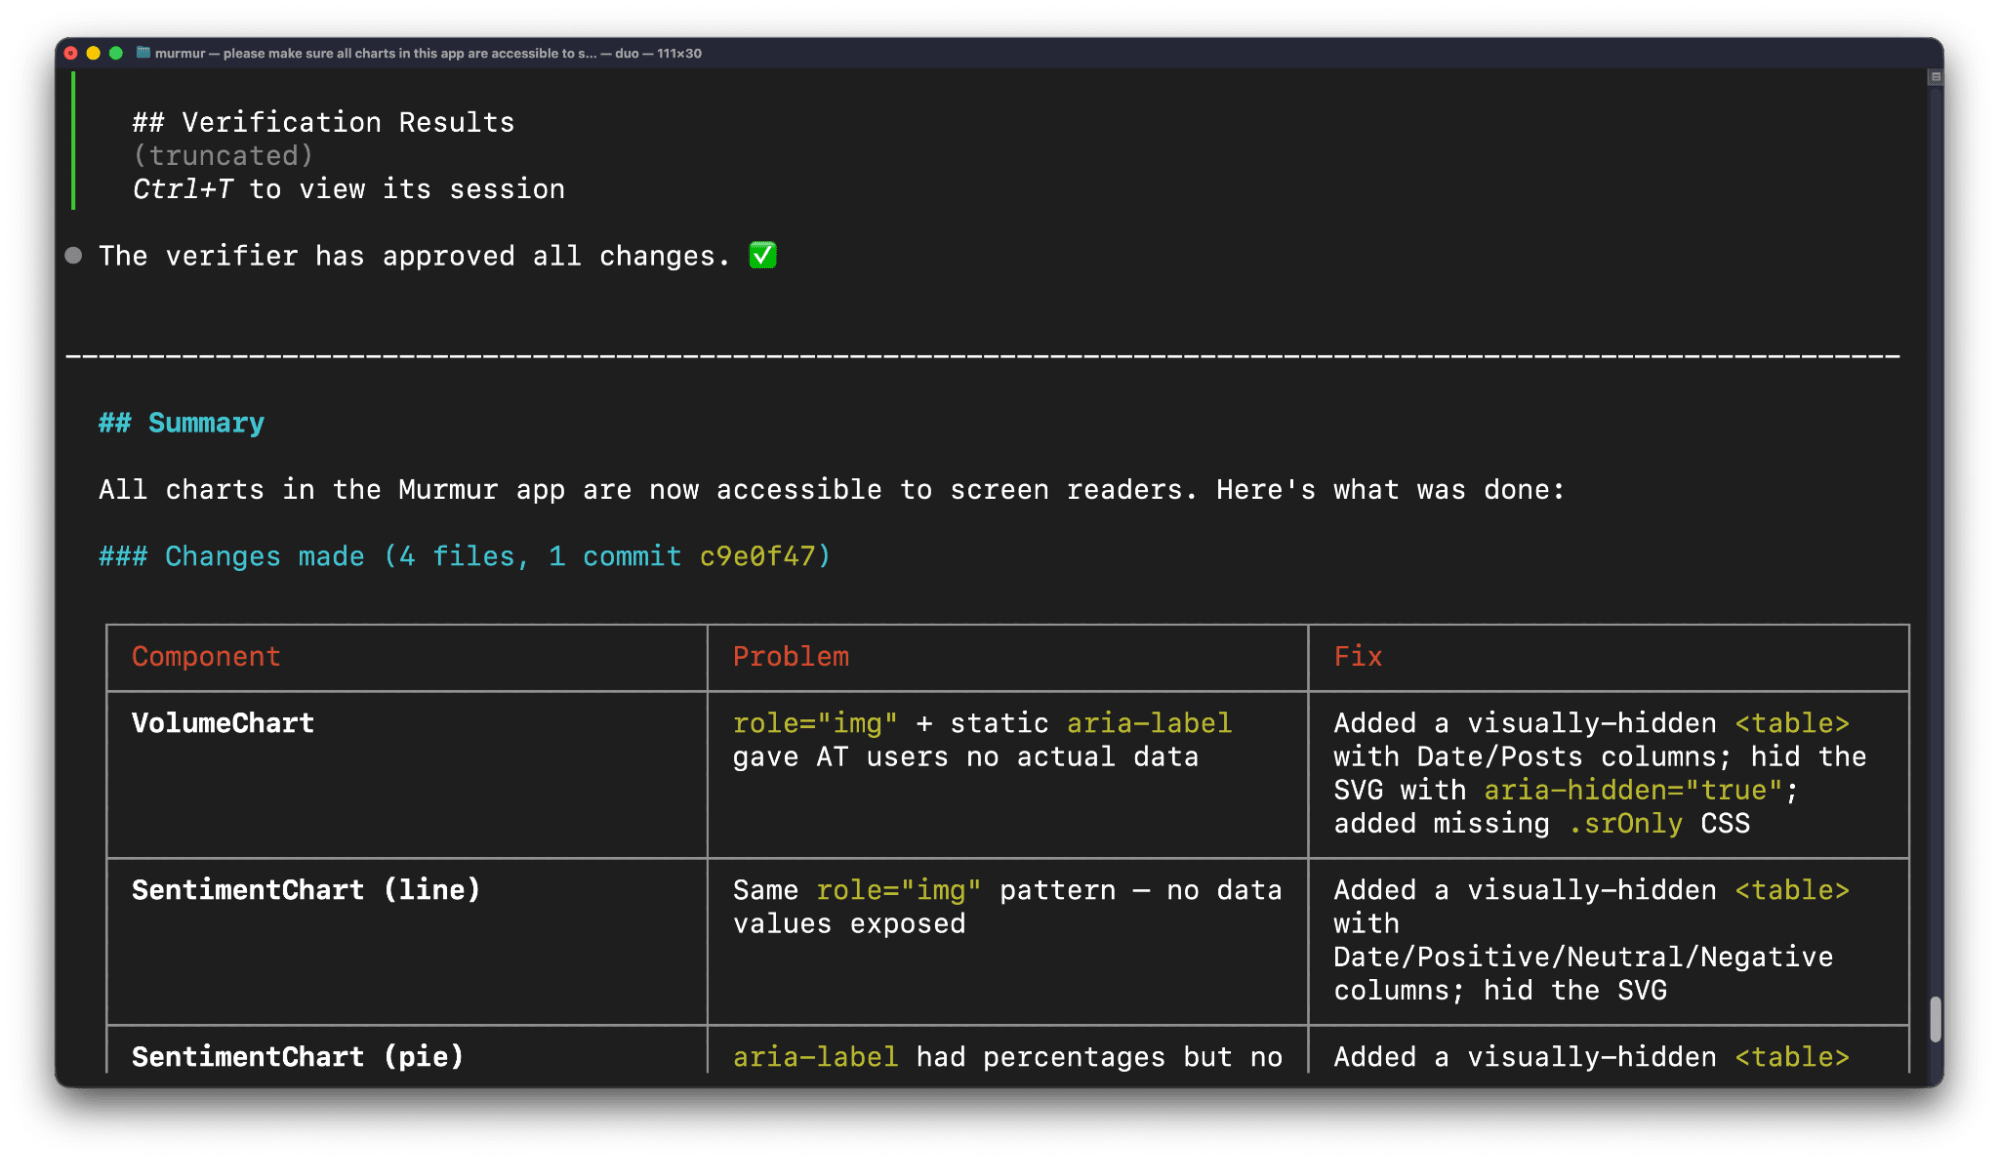
</span></span></code></pre><p>O GitLab Duo encontra os projetos afetados (pelo GitLab Orbit, quando o grupo tem, ou pela busca, caso contrário) e prepara um commit por projeto que exclui o arquivo e adiciona a entrada no <code>.gitignore</code>. Em seguida, ele pausa duas vezes para pedir aprovação: uma para todos os commits juntos e outra para todas as merge requests juntas. Ou seja, limpar um grupo inteiro custa dois cliques. No fim, vem uma tabela com os projetos, os links das merge requests e os tipos de segredo de cada arquivo, sem reproduzir nenhum valor, seguida da lista do que ainda fica por sua conta. Só falta revisar as merge requests e fazer o merge.</p><p>Sem o GitLab Duo, a mesma mudança em cada projeto leva quatro comandos:</p><pre className="language-plaintext shiki shiki-themes github-light" code="git rm --cached .claude/settings.local.json
echo &#39;.claude/settings.local.json&#39; &gt;&gt; .gitignore
git add .gitignore
git commit -m &quot;Stop tracking Claude Code local settings&quot;
" language="plaintext" meta="" style=""><code><span class="line" line="1"><span>git rm --cached .claude/settings.local.json
</span></span><span class="line" line="2"><span>echo &#39;.claude/settings.local.json&#39; &gt;&gt; .gitignore
</span></span><span class="line" line="3"><span>git add .gitignore
</span></span><span class="line" line="4"><span>git commit -m &quot;Stop tracking Claude Code local settings&quot;
</span></span></code></pre><h3 id="limpe-o-conteúdo-do-histórico">Limpe o conteúdo do histórico</h3><p>Remover o arquivo só o tira da árvore atual. As versões antigas continuam no repositório até que o histórico seja reescrito; por isso, faça essa limpeza em todo projeto em que o arquivo tinha um segredo, depois de rotacionar os segredos.</p><p>No projeto, acesse <strong>Settings &gt; Repository &gt; Repository maintenance &gt; Remove blobs</strong>, cole os IDs das versões antigas do arquivo (abra a árvore do repositório em um commit antigo para copiá-los) e confirme. Em seguida, execute o housekeeping, aguarde 30 minutos e remova os objetos inacessíveis (prune unreachable objects).</p><p>Para confirmar que funcionou: os IDs dos commits posteriores ao blob removido mudam, e a verificação de histórico da seção Avaliar não retorna nada para o caminho. Se nada mudar depois de alguns minutos, confira o seu e-mail, porque uma reescrita com falha só é informada por lá, para quem a iniciou.</p><p>Dois casos exigem cuidado. Se o projeto é um fork, ou um projeto público com forks, o pool de objetos compartilhado mantém o conteúdo acessível mesmo depois da reescrita; desvincule os forks primeiro ou limpe cada repositório separadamente. E, depois de qualquer reescrita, merge requests abertas podem precisar de rebase, e todo mundo precisa clonar o repositório de novo.</p><h2 id="resumo">Resumo</h2><p>Em resumo: pergunte ao GitLab Duo se o arquivo existe, agora ou no passado. Rotacione tudo o que os arquivos continham. Peça ao GitLab Duo para abrir as merge requests de limpeza em todo o grupo, revise-as e faça o merge. Limpe o histórico onde havia segredos. Configure a regra de push, ative a Secret Push Protection e adicione a política. Dois prompts no total, dois cliques de aprovação e alguns minutos de configuração ajudam a manter seus repositórios livres desse tipo de vazamento.</p><h2 id="saiba-mais">Saiba mais</h2><p>Documentação do GitLab (em inglês):</p><ul><li><a href="https://docs.gitlab.com/user/gitlab_duo_chat/agentic_chat/" rel="">GitLab Duo Agentic Chat</a></li><li><a href="https://docs.gitlab.com/user/application_security/secret_detection/secret_push_protection/" rel="">Secret Push Protection</a> e <a href="https://docs.gitlab.com/user/application_security/secret_detection/pipeline/" rel="">Pipeline Secret Detection</a></li><li><a href="https://docs.gitlab.com/user/project/repository/push_rules/" rel="">Push rules</a>: nomes de arquivo proibidos</li><li><a href="https://docs.gitlab.com/user/application_security/policies/scan_execution_policies/" rel="">Scan execution policies</a></li><li><a href="https://docs.gitlab.com/user/project/repository/repository_size/" rel="">Remove blobs</a> e manutenção do repositório</li></ul><style>html .default .shiki span {color: var(--shiki-default);background: var(--shiki-default-bg);font-style: var(--shiki-default-font-style);font-weight: var(--shiki-default-font-weight);text-decoration: var(--shiki-default-text-decoration);}html .shiki span {color: var(--shiki-default);background: var(--shiki-default-bg);font-style: var(--shiki-default-font-style);font-weight: var(--shiki-default-font-weight);text-decoration: var(--shiki-default-text-decoration);}html pre.shiki code .sgsFI, html code.shiki .sgsFI{--shiki-default:#24292E}html pre.shiki code .sYu0t, html code.shiki .sYu0t{--shiki-default:#005CC5}html pre.shiki code .sYBdl, html code.shiki .sYBdl{--shiki-default:#032F62}</style>]]></content>
        <author>
            <name>Amar Patel</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/amar-patel/</uri>
        </author>
        <author>
            <name>Daniel Abeles</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/daniel-abeles/</uri>
        </author>
        <published>2026-11-12T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Open source e OSS: o que é e o que sua empresa ganha com isso]]></title>
        <id>https://about.gitlab.com/pt-br/blog/what-is-open-source-software/</id>
        <link href="https://about.gitlab.com/pt-br/blog/what-is-open-source-software/"/>
        <updated>2026-11-11T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<h1 id="open-source-e-oss-o-que-é-e-o-que-sua-empresa-ganha-com-isso">Open source e OSS: o que é e o que sua empresa ganha com isso</h1><p>Poucos temas de tecnologia acumulam tantos mal-entendidos e contradições aparentes quanto o software de código aberto (OSS, do inglês <em>open source software</em>).</p><p>De um lado, estão os números de adoção. Na Alemanha, o número de empresas que usam OSS cresceu quase 15% só entre 2019 e 2023, e hoje mais de três quartos delas usam software de código aberto ao menos em parte. Diante desse cenário, até a PwC, consultoria líder mundial, foi categórica: “O software de código aberto já é o estado da arte na economia alemã.”</p><blockquote><p><strong>Mais de 6,4 milhões de builds por mês: como a Siemens transforma seu desenvolvimento de software com o GitLab</strong> Mais de 40.000 usuários do GitLab na Siemens colaboram no mundo todo e entregam automaticamente mais de 6,4 milhões de versões de software por mês. Veja como uma cultura DevOps aberta e uma plataforma central aumentam a eficiência e a segurança. <a href="https://about.gitlab.com/pt-br/customers/siemens/" rel="">Ler o estudo de caso</a></p></blockquote><p>Do outro lado, muitas empresas têm dificuldade para integrar o OSS, na prática, à sua estrutura de TI e aos seus processos. A Computer Weekly deixou isso claro em uma edição especial sobre o tema: “Para empresas de médio porte, em especial, adotar OSS costuma ser um desafio considerável. Sem <span>...</span> investimento inicial, todo projeto de código aberto fracassa antes mesmo de começar.”</p><p>À primeira vista, isso contradiz uma ideia bastante popular: a de que o OSS compensa justamente porque não custa nada.</p><p>Como conciliar as duas perspectivas? É isso que este artigo ajuda a responder. Vamos ver quais vantagens o OSS oferece, quanto ele custa na prática e como superar as dificuldades de implementação. Mas, antes, vale entender de onde vem a ideia.</p><h2 id="o-que-significa-open-source">O que significa open source?</h2><p>Normalmente, tratamos <em>open source</em> e software de código aberto como sinônimos. Mas a ideia por trás dos dois, a troca livre de certas tecnologias, ideias e conceitos, é bem mais antiga.</p><p>Um dos exemplos mais antigos e mais citados vem dos primeiros anos da indústria automobilística americana. Durante um período, as montadoras decidiram não patentear novos desenvolvimentos. A lógica era que todos sairiam ganhando se o mercado como um todo crescesse. Ainda hoje, montadoras concorrentes trabalham juntas em projetos de código aberto.</p><p>Nos anos 1950 e 1960, a IBM também compartilhou seus segredos de software com o mundo. Na época, foi uma jogada extremamente inovadora. Mas, por honestidade, vale acrescentar: naquele tempo, o software era visto como algo quase sem valor, e a empresa ganhava dinheiro alugando seu hardware.</p><p>Esses primeiros exemplos têm algo em comum: em vez de proteger os resultados da própria pesquisa das outras empresas, quem os produziu decidiu colocá-los generosamente à disposição do público.</p><h2 id="software-de-código-aberto-definição">Software de código aberto: definição</h2><p>No universo do software, a ideia do código aberto ganhou um alcance que foi muito além do próprio setor.</p><p>Ela segue viva até hoje em várias áreas, em projetos como as sementes de código aberto (<em>open source seeds</em>), sementes que, de propósito, não são patenteadas. Talvez porque códigos genéticos possam muito facilmente ser vistos como software.</p><p>Esta é a definição de software de código aberto:</p><p><strong>Um software é de código aberto quando seu código-fonte é compartilhado abertamente e pode ser consultado e modificado. Outros programadores podem criar obras derivadas a partir dele ou incorporá-lo aos próprios projetos.</strong></p><p>Essa definição ainda não cobre todos os detalhes. A questão das licenças, por exemplo, tem algumas sutilezas, que vamos detalhar mais adiante. Como ponto de partida, porém, ela já é bastante precisa e abrangente.</p><h2 id="o-oss-é-sempre-gratuito">O OSS é sempre gratuito?</h2><p>Não. Esse mal-entendido acompanha o tema até hoje. E foi justamente por isso que se escolheu o nome <em>open source</em>: o nome original, <em>free software</em>, já tinha se mostrado ambíguo demais. Em inglês, <em>free</em> significa tanto “livre” quanto “gratuito”.</p><p>Ou seja, é perfeitamente possível vender um produto de código aberto a um preço premium. Desde que o código-fonte seja aberto, o critério mais importante está atendido.</p><p>É verdade que, na maioria dos casos, o software de código aberto é oferecido gratuitamente. Hoje, a maior parte dos fornecedores profissionais não baseia sua receita na venda de licenças, e sim em serviços em torno do produto.</p><p>O software de código aberto se entende como um instrumento de transparência e inovação. Nesse papel, continua seguindo os princípios do software livre, mesmo que já não leve esse nome.</p><p>Vale olhar com um pouco mais de atenção para esse caminho: do software proprietário ao software livre e, de lá, à filosofia do código aberto.</p><h2 id="do-software-proprietário-ao-software-livre">Do software proprietário ao software livre</h2><p>O termo software livre (<em>free software</em>) surgiu no início dos anos 1980. Na época, um número crescente de desenvolvedores passou a considerar antiético que grandes empresas, e até instituições de ensino como universidades, explorassem comercialmente o trabalho deles.</p><p>Quando a IBM compartilhou seus sistemas operacionais com o mundo, não havia ali nem idealismo nem busca de lucro. Foi uma decisão tomada quase de passagem, à qual poucos dos envolvidos devem ter dado muita importância. Mas logo surgiu uma indústria movimentada em torno da venda de licenças de software, às vezes a preços extremamente altos. Essas soluções pagas, cujo código-fonte era guardado como segredo comercial e protegido por patentes, são chamadas de software fechado (<em>closed software</em>) ou software proprietário: software sobre o qual alguém detém a propriedade.</p><p>Com os melhores softwares proprietários do mercado, empresas com mais recursos muitas vezes conquistavam uma vantagem competitiva clara. Já concorrentes menores, com boas ideias mas pouco orçamento, ficavam para trás.</p><p>O software livre deveria estar disponível para todos. Com o código-fonte aberto, passou a ser possível incorporar suas funcionalidades às próprias soluções e, assim, tornar o desenvolvimento de software mais eficiente.</p><h2 id="do-software-livre-ao-software-de-código-aberto">Do software livre ao software de código aberto</h2><p>O nome <em>free software</em> foi um problema desde o início. <em>Free</em> deveria se referir à liberdade de uso, não à gratuidade. Para deixar essa ideia mais clara, optou-se, por fim, por um novo nome.</p><p><em>Open source</em>, código aberto, expressa exatamente o que está em jogo: o código-fonte, que é a base de toda a funcionalidade.</p><p>Hoje, os dois conceitos coexistem, e a diferença de foco entre eles é pequena. A comunidade do software livre, por exemplo, se vê como a base filosófica e política de todo o setor, sobre a qual se apoiam, em última instância, conceitos mais concretos como o OSS.</p><h2 id="software-de-código-aberto-exemplos">Software de código aberto: exemplos</h2><p>Hoje há inúmeros exemplos de uso do código aberto no desenvolvimento de novos softwares.</p><p>O primeiro com que a maioria dos usuários domésticos teve contato foi, sem dúvida, o navegador Firefox. Antes de sua chegada, o mercado tinha sido dominado primeiro por um navegador gratuito, mas que não era de código aberto (o Netscape Navigator), e depois por um navegador integrado ao sistema operacional proprietário Microsoft Windows (o Internet Explorer). O Firefox trouxe uma excelente alternativa de código aberto, elogiada por suas muitas extensões.</p><p>Desde então, o código aberto se tornou o modelo dominante de distribuição e licenciamento. A revista alemã on-line Deutsche Startups montou uma ótima visão geral por setor:</p><p><strong>Ferramentas de desenvolvimento:</strong> Python, Ruby e OGC são exemplos de ferramentas de código aberto à disposição dos desenvolvedores.</p><p><strong>Bancos de dados:</strong> o MySQL, a principal solução de banco de dados do mundo, é de código aberto. O mesmo vale para concorrentes como PostgreSQL e MongoDB.</p><p><strong>Infraestrutura:</strong> o <a href="https://about.gitlab.com/pt-br/blog/kubernetes-the-container-orchestration-solution/" rel="">Kubernetes</a>, plataforma de orquestração de contêineres, também é software de código aberto.</p><p><strong>Design gráfico e multimídia:</strong> GIMP e Blender são excelentes ferramentas para quem acha caros demais os produtos proprietários e pagos. O player VLC deixa no chinelo a maioria dos players que não são de código aberto.</p><p><strong>Tecnologias web:</strong> algumas tecnologias fundamentais, como o PHP, atendem aos critérios do código aberto.</p><p><strong>Outros:</strong> LibreOffice e OpenOffice são aplicações inteiramente de código aberto. O cliente de e-mail Thunderbird também usa uma licença de código aberto, assim como o gerenciador de arquivos FreeCommander.</p><h2 id="o-que-as-empresas-esperam-do-software-de-código-aberto">O que as empresas esperam do software de código aberto?</h2><p>Talvez você também esteja pensando em levar a TI da sua empresa, tanto quanto possível, para uma base de código aberto. Como vimos, não seria uma decisão isolada: as empresas que apostam apenas em soluções proprietárias já são minoria.</p><p>Para a maioria das empresas, estes pontos pesam na decisão:</p><ul><li>O software de código aberto pode ajudar a reduzir os custos de TI.</li><li>O software de código aberto é flexível e, por isso, mais fácil de adaptar a necessidades específicas.</li><li>O software de código aberto tem fama de consumir menos capacidade de armazenamento e, com isso, melhorar o desempenho do sistema.</li><li>O software de código aberto é visto como mais inovador e mais adaptável às mudanças do mercado.
Como essas supostas vantagens se comportam na prática? Vamos olhar mais de perto o papel do OSS dentro da empresa, começando por um ponto que nunca é demais reforçar.</li></ul><h2 id="oss-não-é-um-modelo-de-negócio">OSS não é um modelo de negócio</h2><p>Como dissemos, as empresas esperam muito do OSS e se decepcionam quando essas expectativas não se cumprem. O impacto financeiro, principalmente, muitas vezes fica bem longe do que se imaginava.</p><p>Vamos detalhar os motivos mais adiante. Mas uma coisa precisa ficar sempre clara: o código aberto, por si só, nunca é um modelo de negócio, nem mesmo para as empresas que distribuem software sob uma licença de código aberto!</p><p>O software de código aberto é um conceito que nasceu do movimento pela liberdade de informação e de dados. Ele facilita certos métodos e práticas, mas pode tornar outros mais complexos e trabalhosos.</p><p>O código aberto pode, sim, impulsionar os resultados do negócio. Mas a estratégia para chegar lá continua sendo trabalho da própria empresa.</p><h2 id="por-que-algumas-empresas-ainda-preferem-soluções-proprietárias">Por que algumas empresas ainda preferem soluções proprietárias</h2><p>A ascensão do código aberto é inegável. Em boa parte, ela se explica pelo fato de que software gratuito quase sempre exerce uma atração irresistível, mesmo quando está claro que esse “preço zero” às vezes sai caro.</p><p>Ainda assim, o software proprietário continua vivo. Por quê?</p><p>Primeiro, porque é extremamente satisfatório ter um pacote de software tão completo que não só funciona de imediato como já traz todos os componentes necessários. Em muitas áreas, os produtos proprietários são simplesmente mais profissionais e completos. LibreOffice e OpenOffice são excelentes, mas ainda não estão à altura do Office.</p><p>Mais importante ainda: com OSS, problemas de compatibilidade aparecem com mais facilidade. Em documentos do Word, isso ainda é tolerável. Em casos mais complexos, porém, pode deixar o processo de desenvolvimento mais lento, mais sujeito a erros ou até inviável.</p><p>Além disso, embora alguns fornecedores de software proprietário respondam aos clientes mais devagar que seus concorrentes de código aberto, outros se destacam por respostas rápidas e atualizações frequentes. De todo modo, é sempre tranquilizador ter um contato direto quando surgem problemas, e é por isso que muitos produtos de OSS também passaram a oferecer esse tipo de atendimento.</p><h2 id="as-verdadeiras-vantagens-do-software-de-código-aberto">As verdadeiras vantagens do software de código aberto</h2><p>Algumas das vantagens que as empresas esperam do código aberto são, de fato, reais. O OSS aumenta a transparência do software em uso: como o código-fonte está aberto, é possível adaptá-lo, ampliá-lo ou enxugá-lo conforme a necessidade. Também é possível incorporá-lo a pacotes de software desenvolvidos internamente, o que reduz bastante o esforço.</p><p>Muitos programas de código aberto também se destacam pela capacidade de inovação. As comunidades por trás deles são dinâmicas, abertas e, em geral, recebem bem quem está chegando.</p><p>Além disso, vale citar estas vantagens:</p><ul><li><strong>Feedback contínuo:</strong> como o software é testado na prática o tempo todo por outros usuários, os desenvolvedores recebem um fluxo constante de feedback, que serve de ponto de partida para atualizações e novas versões.</li><li><strong>Longevidade:</strong> o software comercial proprietário muitas vezes sai do mercado tão rápido quanto uma série de TV que não emplaca, quando as vendas não decolam. Os projetos de código aberto não estão presos a esse tipo de cálculo e podem continuar existindo mesmo depois que os desenvolvedores originais saem de cena.
O OSS é mesmo mais barato? Na nossa avaliação, depende do caso, mas, em geral, sim.</li></ul><p>O OSS gera custos adicionais com treinamentos, com uma seleção mais criteriosa dos componentes e com o ajuste fino entre eles. Mas, especialmente quando as licenças por usuário são muito caras, o OSS continua sendo a alternativa mais econômica.</p><h2 id="os-três-modelos-de-licença-do-software-de-código-aberto">Os três modelos de licença do software de código aberto</h2><p>Aqui cabe, na nossa visão, um pequeno parêntese. A essa altura, pode ter ficado a impressão de que o OSS, por ser aberto e muitas vezes gratuito, é incompatível com modelos de licença.</p><p>Não é o caso. Na prática, o software de código aberto também está quase sempre ligado a uma licença específica. São essas licenças que regulam o reúso do software, e elas são essenciais para garantir que os princípios do movimento de código aberto sejam de fato respeitados.</p><p>Estas são as três licenças mais comuns:</p><p><strong>Licença copyleft:</strong> é a mais rígida. Protege as liberdades originais do software e obriga todos os usuários a distribuir ou oferecer qualquer obra derivada sob as mesmas condições de licença.</p><p><strong>Licenças de copyleft fraco:</strong> em alguns produtos, a licença das modificações pode ser parcialmente diferente. Isso dá mais liberdade a usuários e desenvolvedores.</p><p><strong>Licenças permissivas:</strong> impõem poucas condições, em geral manter o aviso de direitos autorais e o texto da licença. Para o OSS, isso significa que quem modifica o software decide livremente quais condições de licença valem para o resultado do próprio trabalho.</p><p>Com qualquer uma dessas licenças, é possível cobrar pelos produtos e pelo trabalho.</p><h2 id="código-aberto-e-metodologia-ágil">Código aberto e metodologia ágil</h2><p>Um dos principais motivos pelos quais o código aberto teve uma recepção tão ampla e positiva no desenvolvimento de software, quase de imediato, é sua proximidade com a metodologia ágil.</p><p>Na <a href="https://about.gitlab.com/pt-br/solutions/agile-delivery/" rel="">entrega ágil</a>, o foco está em um processo em que protótipos funcionais são desenvolvidos de forma rápida e regular, com coleta contínua de dados e uma troca estruturada dentro da equipe. Esses protótipos servem, por sua vez, de base para novas melhorias.</p><p>Nas duas abordagens, o centro é o mesmo: transparência, abertura, agilidade, trabalho em equipe, foco no cliente e um caminho rápido até o produto final. E, ao contrário das soluções proprietárias, os produtos de código aberto nunca ficam prontos de verdade: são sempre uma versão intermediária.</p><p>Para quem já tem experiência com métodos ágeis, introduzir o OSS na empresa fica bem mais fácil.</p><h2 id="estudo-de-caso-1-linux">Estudo de caso 1: Linux</h2><p>Talvez o software de código aberto mais conhecido de todos seja o Linux.</p><p>O Linux é 100% de código aberto, e seu código-fonte pode ser consultado livremente. Disso surgiu, num desenvolvimento fascinante, uma grande variedade das chamadas “distribuições”: configurações específicas do Linux, cada uma com sua própria interface e um conjunto de ferramentas associadas.</p><p>Em relação ao Windows, o Linux tem várias das vantagens citadas acima: é bem mais eficiente e rápido, mais flexível e mais barato. Foi justamente sua capacidade única de adaptação que o levou à liderança no mercado de servidores.</p><p>Ao mesmo tempo, é mais complicado, tanto na instalação quanto no uso no dia a dia, e depende de uma equipe de TI bem preparada.</p><p>O que o Linux tem de especial é que suas distribuições são oferecidas sob licenças diferentes. Há versões totalmente gratuitas e bem minimalistas; variantes pensadas para desenvolvedores inovadores; e, por fim, pacotes completos, tão práticos e completos quanto o software proprietário comercial (e, por isso mesmo, bem mais caros).</p><p>O Linux é um exemplo clássico de como o código aberto pode ser versátil na prática.</p><h2 id="estudo-de-caso-2-gitlab">Estudo de caso 2: GitLab</h2><p>O <a href="https://about.gitlab.com/pt-br/" rel="">GitLab</a> também nasceu, desde o início e por convicção, como um projeto de código aberto.</p><p>O que o código aberto significa para nós, na prática?</p><ul><li>O núcleo aberto (<em>open core</em>) do GitLab é publicado sob a licença de código aberto MIT, e seu código-fonte pode ser consultado livremente. O restante tem o código-fonte disponível para consulta (<em>source-available</em>).</li><li>Ficamos sempre felizes em receber sugestões de melhorias ou de novos recursos. No <a href="https://forum.gitlab.com/c/community/gitlab-for-open-source/49" rel="">Fórum do GitLab</a>, também é possível encontrar outros desenvolvedores para trocar ideias especificamente sobre código aberto.</li><li>Com o GitLab Development Kit, oferecemos uma forma de adaptar o código-fonte por conta própria a preferências e necessidades específicas.</li><li>Nossos repositórios abrigam inúmeros projetos de código aberto.</li><li>Com o <a href="https://about.gitlab.com/pt-br/solutions/open-source/" rel="">programa GitLab para Open Source</a>, apoiamos a criação de novos projetos de OSS que beneficiam toda a comunidade.
No GitLab, o código aberto não fica só na teoria. Um exemplo marcante é o do Drupal, plataforma de gestão de conteúdo, que se reinventou ao completar 20 anos e, com o GitLab, abriu seus serviços a novos públicos. Saiba mais no <a href="https://about.gitlab.com/customers/drupalassociation/" rel="">estudo de caso da Drupal Association</a> (em inglês).</li></ul><p>Se quiser experimentar, a <a href="https://gitlab.com/-/trials/new" rel="">avaliação gratuita do GitLab</a> está à sua disposição.</p><h2 id="oss-desafios-na-implementação">OSS: desafios na implementação</h2><p>Na visão da Computer Weekly, o principal motivo pelo qual muitos projetos de código aberto fracassam na implementação é a falta de conhecimento técnico dentro da empresa.</p><p>Segundo a publicação, “as empresas precisam investir tempo e recursos já de antemão para desenvolver as habilidades e os conhecimentos necessários ou buscar apoio externo, seja por meio de um parceiro, seja contratando novos profissionais”.</p><p>A Computer Weekly também ressalta que uma das possíveis vantagens do OSS, o dinamismo da comunidade e a grande quantidade de soluções que surgem quase todos os dias, pode virar desvantagem para algumas empresas. É o que acontece, por exemplo, quando as opções deixam de ser administráveis e, principalmente, quando montar a combinação certa de componentes se torna complexo e trabalhoso demais.</p><p>Por isso, a especialista Marieke Merkle recomenda um mapeamento de riscos:</p><p>“Nele, são identificados os riscos ligados ao uso de software de código aberto que a empresa já faz ou planeja fazer. Com base nisso, é possível estruturar um processo de compliance começando pela área de uso com os maiores riscos. Em seguida, a estrutura de compliance pode ser ampliada para as demais áreas em que o software de código aberto é usado.”</p><h2 id="qual-é-o-futuro-do-oss">Qual é o futuro do OSS?</h2><p>Fazer previsões em TI costuma ser difícil. Neste caso, porém, algumas tendências claras já se desenham.</p><p>O OSS vai continuar avançando por todos os setores da indústria. Sergio Vemic, Chief Visionary Officer da Telmekom, afirma: “Acredito que o código aberto vai ganhar cada vez mais importância no futuro. Cada vez mais pessoas vão se dedicar a ele, desenvolvê-lo e impulsioná-lo. Até empresas que hoje oferecem software proprietário vão avaliar se vale a pena publicá-lo como código aberto no futuro.”</p><p>O OSS também deve ganhar um impulso considerável com a preferência, no mundo todo, por produtos de código aberto no setor público. A União Europeia já assume um papel pioneiro nesse sentido.</p><p>Em alguns setores-chave, o OSS vai se firmar como uma alternativa séria ao software proprietário. Entre eles estão edge computing, <a href="https://about.gitlab.com/pt-br/platform/" rel="">DevOps</a>, orquestração de contêineres e, claro, inteligência artificial (IA).</p><p>Ao mesmo tempo, alguns especialistas observam um ceticismo crescente entre investidores quanto à capacidade desses projetos de gerar um retorno relevante. Já dissemos: código aberto não é modelo de negócio e, às vezes, pode até atrapalhar um negócio rentável! Ou seja, o jogo continua aberto.</p><h2 id="oss-e-ia-qual-é-o-potencial">OSS e IA: qual é o potencial?</h2><p>A IA e o software de código aberto talvez sejam as tendências mais fortes do desenvolvimento de software hoje. Não surpreende, então, que valha a pena olhar para os dois juntos.</p><p>O Institut für Innovation und Technik, de Berlim, faz a pergunta central: “O que o código aberto significa para a inteligência artificial (IA)?” A análise discute alguns casos fascinantes em que a IA, no desenvolvimento de software de código aberto, viabilizou projetos que simplesmente não teriam saído do papel em um ambiente comercial e proprietário. Entre eles, uma ferramenta de tradução para diversas línguas africanas.</p><p>Para desenvolvedores, também já existem diversas soluções de OSS com um componente relevante de IA. Entre elas estão o FauxPilot (ferramenta de desenvolvimento), o Diffusers, da Hugging Face (biblioteca de geração de imagens a partir de texto), e o PaddleNLP (biblioteca de processamento de linguagem natural). Outros exemplos de IA e OSS aparecem em um artigo da revista alemã Computerwoche.</p><p>Mas também cabe a pergunta inversa: o que a IA significa para o código aberto? Avi Press, CEO da Scarf, empresa especializada em análise de uso de software de código aberto, responde:</p><p>“Uma parcela cada vez maior do código (de código aberto e de outros tipos) em que confiamos vai ser escrita por IA, e não por pessoas... e ainda não sabemos como lidar com todas as consequências de um mundo em que as pessoas não são os únicos protagonistas.”</p><p>E esse movimento já aparece nos números. Em uma pesquisa da McKinsey com mais de 700 líderes de tecnologia de 41 países, 63% das empresas disseram usar regularmente modelos de IA de código aberto. No Brasil, a proporção é de 50%, como mostrou <a href="https://exame.com/bussola/tecnologia-open-source-na-era-da-ia-metade-das-empresas-brasileiras-ja-utilizam-codigo-aberto/" rel="">Rafael Siqueira, sócio da McKinsey em São Paulo, na Exame</a>.</p><p>Uma coisa é certa: IA e OSS vão crescer, e vão crescer juntos. E os resultados, ao menos em parte, vão superar em muito o que hoje conseguimos imaginar.</p><h2 id="será-que-um-dia-vamos-dispensar-de-vez-o-software-proprietário">Será que um dia vamos dispensar de vez o software proprietário?</h2><p>Diante das tendências descritas acima, a hipótese parece quase óbvia.</p><p>O que é certo: o OSS vai ganhar importância, seja como produto independente, seja como componente de uma arquitetura de software maior. Mas é igualmente certo que, no futuro, ainda haverá áreas em que as empresas vão apostar no software proprietário:</p><ul><li>Tecnologias que geram lucros maiores em um ambiente proprietário.</li><li>Tecnologias desenvolvidas e usadas internamente, que garantem uma vantagem significativa sobre a concorrência.</li><li>Tecnologias que exigem um nível extremamente alto de <a href="https://about.gitlab.com/pt-br/solutions/application-security-testing/" rel="">segurança e conformidade</a>. Parece improvável que bancos passem a usar OSS de forma ampla, ou mesmo exclusiva, num futuro próximo.
Já existem, porém, esforços para eliminar sistematicamente os pontos fracos do OSS. Se eles derem certo, nada mais vai impedir um uso ainda mais amplo do código aberto, inclusive em setores críticos para a segurança.</li></ul>]]></content>
        <author>
            <name>GitLab Germany Team</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/gitlab-germany-team/</uri>
        </author>
        <published>2026-11-11T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[O que é um servidor MCP? Funcionamento e uso no desenvolvimento de software]]></title>
        <id>https://about.gitlab.com/pt-br/blog/what-is-mcp-server/</id>
        <link href="https://about.gitlab.com/pt-br/blog/what-is-mcp-server/"/>
        <updated>2026-11-10T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>Empresas de vários setores vêm adotando a IA para ganhar eficiência e melhorar a experiência dos clientes. Nesse movimento, uma tecnologia passou a chamar atenção: o servidor MCP. No desenvolvimento de software, ele ajuda a tornar o trabalho mais eficiente e a automatizar tarefas.</p><p>Se a sua equipe está avaliando essa tecnologia, este artigo reúne o essencial: o que é um servidor MCP, como ele funciona, quais benefícios traz, que cuidados exige e onde ele faz diferença no dia a dia do desenvolvimento.</p><h2 id="o-que-é-um-servidor-mcp">O que é um servidor MCP</h2><p><img alt="O que é um servidor MCP" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1786001468/j7zz5feed8zjokbw6bcz.jpg" /></p><p>MCP é a sigla de <em>Model Context Protocol</em>, um protocolo padrão para conectar aplicações de IA baseadas em LLMs a sistemas externos de forma segura e eficiente. A Anthropic lançou este protocolo em novembro de 2024 para oferecer às aplicações de IA uma forma única de acessar fontes de dados e sistemas diversos.</p><p>Explicando melhor, o servidor MCP é o programa que coloca esse padrão em prática: é ele que de fato liga a aplicação de IA a um sistema externo, seguindo as regras do protocolo.</p><p>Vale distinguir o servidor MCP de uma API. Uma API é um mecanismo genérico de troca de dados entre sistemas, pensado para ser operado por pessoas, no caso, desenvolvedores. O servidor MCP foi feito especificamente para aplicações de IA e funciona como as &quot;mãos&quot; delas no sistema externo. É isso que permite a agentes e outras aplicações de IA decidir e agir por conta própria.</p><h2 id="por-que-os-servidores-mcp-ganharam-espaço">Por que os servidores MCP ganharam espaço</h2><p><img alt="Por que os servidores MCP ganharam espaço" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1786001469/ezib0bdwthpnpgw9kc0a.jpg" /></p><p>Dois movimentos explicam o interesse, tanto no desenvolvimento de software, quanto fora dele: a demanda crescente por integrar a IA a sistemas externos e a necessidade de reduzir o custo de desenvolver e manter essas integrações.</p><p>Até pouco tempo atrás, usar IA no trabalho significava, na maioria dos casos, dar uma instrução a um modelo de IA generativa e aproveitar a resposta. Com a popularização dos agentes de IA, que agem de forma autônoma, a expectativa mudou: agora se espera que a IA opere ferramentas e automatize etapas inteiras do trabalho.</p><p>Para isso, o obstáculo estava na integração. Cada ferramenta tem a sua API, com especificações próprias, e cada conexão exigia um trabalho sob medida. Quanto mais ferramentas, maior o custo de manutenção e mais difícil manter tudo seguro. Esse custo vinha freando a adoção da IA.</p><p>O MCP resolve esse ponto ao definir um padrão de comunicação comum. Servidores que seguem esse padrão tornam a integração entre IA e sistemas externos mais simples, e é por isso que vêm sendo adotados em contextos tão diferentes.</p><h2 id="como-um-servidor-mcp-funciona">Como um servidor MCP funciona</h2><p><img alt="Como um servidor MCP funciona" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1786001465/p2emvurnjib6axidpbho.jpg" /></p><p>Para entender o funcionamento, é preciso olhar para quatro aspectos: os papéis envolvidos, o que o servidor oferece à IA, o caminho de uma solicitação e onde o servidor roda.</p><h3 id="host-cliente-e-servidor">Host, cliente e servidor</h3><p>O MCP é organizado em três papéis: host MCP, cliente MCP e servidor MCP.</p><p>O host MCP é a própria aplicação de IA, como o ChatGPT, o Cursor ou o Claude Desktop. É ele que recebe a instrução do usuário e decide o que precisa ser feito.</p><p>O cliente MCP fica dentro do host e é o intermediário: cada cliente mantém uma conexão 1:1 com um servidor MCP e cuida da comunicação entre os dois lados.</p><p>O servidor MCP, na outra ponta, expõe à IA o que um sistema externo tem a oferecer.</p><h3 id="o-que-um-servidor-mcp-oferece-à-ia">O que um servidor MCP oferece à IA</h3><p>Um servidor MCP pode oferecer três tipos de funcionalidade à IA: ferramentas (<em>tools</em>), recursos (<em>resources</em>) e prompts.</p><p><strong>Ferramentas</strong> são as ações que a IA pode executar em um sistema externo. Com elas, a IA deixa de apenas responder e passa a agir, por exemplo:</p><ul><li>chamar uma API web;</li><li>consultar ou alterar um banco de dados;</li><li>enviar mensagens;</li><li>criar ou buscar documentos;</li><li>executar cálculos.</li></ul><p><strong>Recursos</strong> são os dados que a IA pode ler, como:</p><ul><li>documentos de design e especificações;</li><li>código-fonte;</li><li>issues;</li><li>logs de CI.</li></ul><p>A IA consulta esses dados para tomar decisões e produzir suas respostas.</p><p><strong>Prompts</strong> são modelos de instrução que dizem à IA que tipo de tarefa executar. Ficam configurados no servidor, prontos para uso. Instruções recorrentes, como pedir uma revisão de código ou investigar um bug, podem virar modelos, e o time inteiro passa a reaproveitar os prompts que funcionam melhor.</p><h3 id="o-fluxo-de-uma-solicitação">O fluxo de uma solicitação</h3><p>Na prática, uma solicitação percorre este caminho:</p><ol><li>O usuário dá uma instrução à aplicação de IA (o host).</li><li>O cliente, dentro do host, pergunta ao servidor MCP quais ferramentas e recursos estão disponíveis e recebe a resposta.</li><li>A IA decide qual ferramenta usar e, por meio do cliente, envia a solicitação ao servidor MCP.</li><li>O servidor executa a solicitação e gera um resultado.</li><li>O resultado volta para a IA, de novo por meio do cliente.</li><li>A IA monta a resposta final e a entrega ao usuário.</li></ol><h3 id="servidores-locais-e-remotos">Servidores locais e remotos</h3><p>Um servidor MCP pode rodar em dois lugares.</p><p><strong>Servidor local:</strong> roda diretamente na máquina do usuário. A comunicação com o cliente fica na própria máquina, sem passar pela rede, o que ajuda a manter o desempenho e a continuidade do trabalho. A limitação é o alcance: um servidor local não serve bem a um time inteiro.</p><p><strong>Servidor remoto:</strong> roda em uma rede, seja na nuvem, seja em um ambiente fechado. Exige pouca configuração em cada máquina e permite que o time todo use o mesmo servidor. Em troca, depende da conexão: a velocidade de resposta da IA pode variar conforme a rede, e é preciso proteger o servidor contra vazamento de informações e acesso indevido.</p><h2 id="benefícios-dos-servidores-mcp">Benefícios dos servidores MCP</h2><p><img alt="Benefícios dos servidores MCP" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1786001469/imouowalter2bwgbbisp.jpg" /></p><h3 id="mais-eficiência-no-desenvolvimento">Mais eficiência no desenvolvimento</h3><p>O primeiro benefício é a padronização. Antes, integrar IA a sistemas externos exigia uma conexão específica para cada combinação de modelo de IA e ferramenta, o que pesava no desenvolvimento e na manutenção. É o chamado problema M×N.</p><p>Com o MCP, um servidor construído uma única vez atende a qualquer aplicação de IA compatível com o protocolo, e o problema M×N deixa de existir. Os desenvolvedores ganham espaço para se concentrar no que importa no desenvolvimento de software, como o design e a implementação de funcionalidades.</p><h3 id="mais-capacidade-de-ação-para-a-ia">Mais capacidade de ação para a IA</h3><p>Até aqui, a IA trabalhava sobretudo de forma passiva: recebia uma instrução (o prompt) e devolvia informação.</p><p>Com servidores MCP, a IA vai além de uma resposta pontual a um pedido. Diante de um objetivo, a aplicação de IA decide os passos e conclui a tarefa por conta própria.</p><p>Com isso, cresce a parte do ciclo de desenvolvimento que pode ser automatizada, e as entregas ganham velocidade.</p><h3 id="flexibilidade-para-trocar-de-ia-e-crescer">Flexibilidade para trocar de IA e crescer</h3><p>Como as regras de comunicação são comuns, qualquer IA compatível com o MCP funciona com o mesmo servidor. Trocar de IA, quando for preciso, fica simples.</p><p>Acrescentar uma nova fonte de dados também é direto: basta conectar o servidor MCP correspondente.</p><p>Com sistemas cada vez maiores e processos de desenvolvimento cada vez mais complexos, essa flexibilidade e essa facilidade de expansão ajudam muito a aliviar a carga dos desenvolvedores.</p><h2 id="cuidados-ao-adotar-servidores-mcp">Cuidados ao adotar servidores MCP</h2><p><img alt="Cuidados ao adotar servidores MCP" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1786001465/r93kgoqvnpnlwznndvoc.jpg" /></p><p>Os benefícios vêm acompanhados de dois pontos de atenção: a curva de aprendizado e a segurança.</p><h3 id="curva-de-aprendizado-e-maturidade-da-tecnologia">Curva de aprendizado e maturidade da tecnologia</h3><p>O MCP surgiu em 2024 e ainda é uma tecnologia relativamente nova. Há poucos casos e materiais de referência, então se torna uma questão a necessidade dos desenvolvedores entenderem a fundo os conceitos e o funcionamento do protocolo. Dependendo da empresa, isso significa investir em capacitação ou contratação.</p><p>A tecnologia também está em evolução, e mudanças de especificação e novas funcionalidades são esperadas. Quem adota o MCP precisa estar preparado para acompanhar essas atualizações no longo prazo.</p><p>Um exemplo recente é a versão 2026-07-28 da especificação: a principal mudança é que o protocolo passou a ser sem estado (<em>stateless</em>) na camada de protocolo. Os detalhes estão no anúncio do <em>release candidate</em> (em inglês):</p><p><a href="https://blog.modelcontextprotocol.io/posts/2026-07-28-release-candidate/" rel="">The 2026-07-28 MCP Specification Release Candidate</a></p><h3 id="segurança">Segurança</h3><p>Para que a IA opere sistemas externos por meio de um servidor MCP, ela precisa das credenciais desses sistemas. Isso cria riscos de segurança que precisam ser tratados desde o início. Três medidas são centrais.</p><p><strong>Usar servidores MCP confiáveis.</strong> Qualquer pessoa que entenda o protocolo pode criar um servidor MCP. Entre os servidores disponíveis, há os que se passam por outros e os que praticam o chamado <em>rug pull</em>: conquistam confiança e depois passam a agir de forma maliciosa. Conectar um servidor de origem desconhecida a uma aplicação de IA aumenta o risco. Por isso, a escolha deve se limitar a servidores de publicadores confiáveis.</p><p><strong>Gerenciar permissões e controlar o acesso.</strong> Um servidor MCP com permissões em excesso pode levar a IA a executar automaticamente ações perigosas e inesperadas. O princípio do menor privilégio (PoLP), já conhecido da operação em nuvem, vale também aqui: usuários e sistemas recebem apenas as permissões estritamente necessárias para cumprir seu objetivo. Se a ideia é só consultar issues ou logs de execução, por exemplo, a permissão padrão deve ser somente leitura. Além de limitar as permissões do servidor MCP, é importante controlar, na infraestrutura, os sistemas sobre os quais ele atua. E as permissões e os controles de acesso devem ser revistos periodicamente, à medida que as necessidades do negócio mudam.</p><p><strong>Proteger contra injeção de prompt.</strong> A injeção de prompt (<em>prompt injection</em>) é um risco próprio da IA: um ataque em que alguém, se passando por usuário legítimo, envia à IA instruções maliciosas para provocar comportamentos não previstos. As defesas incluem confirmação e aprovação humanas e sanitização das entradas. Registrar e monitorar logs também é importante para reagir rápido quando houver um incidente.</p><h2 id="casos-de-uso-no-desenvolvimento-de-software">Casos de uso no desenvolvimento de software</h2><p><img alt="Casos de uso no desenvolvimento de software" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1786001464/jf5e29tk93adzzzp9xpl.jpg" /></p><h3 id="requisitos-e-design">Requisitos e design</h3><p>Conectar a IA, por meio de servidores MCP, ao serviço de armazenamento ou ao sistema de controle de versão onde ficam os documentos de requisitos e de design torna esse trabalho mais ágil. A IA pode, por exemplo, consultar especificações anteriores e montar um primeiro rascunho do documento de design de uma nova funcionalidade.</p><p>Ela também pode comparar a definição de requisitos atual com projetos parecidos do passado e apontar lacunas, omissões ou inconsistências.</p><p>Aceitar de olhos fechados o que a IA produz ou valida é arriscado. Como apoio para ter uma visão geral e revisar o conteúdo, porém, ela torna o trabalho mais eficiente.</p><h3 id="revisão-de-código-e-qualidade">Revisão de código e qualidade</h3><p>Quando as convenções de código do time são disponibilizadas à aplicação de IA como recursos de um servidor MCP, o esforço de revisão de código cai bastante.</p><p>A IA pode, por conta própria, verificar violações aos padrões de codificação, procurar vulnerabilidades de segurança e detectar bugs.</p><p>Além disso, a partir da análise do código, a IA sugere melhorias. Quem faz a revisão usa essas sugestões como apoio e melhora a qualidade do código com menos esforço.</p><h3 id="gestão-de-issues-e-tarefas">Gestão de issues e tarefas</h3><p>Com servidores MCP dos sistemas de acompanhamento de issues e de gestão de tarefas, a IA passa a acessar essas informações, e acompanhar o andamento e organizar o trabalho fica mais simples.</p><p>Durante a correção de bugs que surgiram no meio do desenvolvimento, por exemplo, a IA pode listar só as tarefas pendentes ou reorganizar prioridades quando uma especificação muda de repente.</p><p>Com a gestão de issues e tarefas apoiada pela IA, ninguém precisa alternar entre várias ferramentas: as informações ficam disponíveis como contexto no próprio fluxo de codificação, e o projeto anda com menos atrito.</p><h3 id="cicd-e-operações">CI/CD e operações</h3><p>CI/CD é um dos casos de uso mais típicos para servidores MCP. Ao usar o servidor MCP de uma plataforma de <a href="https://about.gitlab.com/pt-br/topics/ci-cd/cicd-pipeline/" rel="">pipelines de CI/CD</a>, a IA consegue operar e analisar as ferramentas de CI/CD diretamente, executando pipelines e verificando o status com agilidade.</p><p>Quando uma pipeline falha, a IA pode fazer a primeira análise da causa. O desenvolvedor gasta menos tempo vasculhando logs, e a resposta ao incidente fica mais rápida.</p><h3 id="gestão-do-conhecimento-e-busca-de-informações">Gestão do conhecimento e busca de informações</h3><p>Muitas empresas acumulam conhecimento em wikis internas, atas de reunião e outros registros. Isso pode causar um problema: como encontrar o que se procura? Afinal, não se sabe onde a informação está guardada nem de quando ela é.</p><p>Com servidores MCP que dão à IA acesso a esse conhecimento interno, a busca fica rápida. Um engenheiro recém-chegado que precisa consultar as regras de desenvolvimento, por exemplo, encontra a resposta sozinho, e o custo de integração de novos profissionais diminui. A IA também ajuda no compartilhamento de conhecimento e nas passagens de bastão entre colegas, uma boa aliada para acabar com os silos de conhecimento.</p><h2 id="como-escolher-um-servidor-mcp">Como escolher um servidor MCP</h2><p><img alt="Como escolher um servidor MCP" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1786001469/ljrhnvo0kojfx3d1xv2f.jpg" /></p><p>Logicamente, há servidores MCP para propósitos muito diferentes. Por isso, na hora de escolher um servidor público para o desenvolvimento de software, três critérios ajudam.</p><h3 id="os-casos-de-uso-que-você-quer-atender">Os casos de uso que você quer atender</h3><p>Comece verificando se o servidor oferece as funcionalidades que correspondem aos objetivos e aos desafios do seu time. O desenvolvimento de software envolve muitas atividades, então vale definir quais processos devem ganhar eficiência com a IA:</p><ul><li>gestão de projetos (issues, tarefas etc.);</li><li>apoio à revisão de código;</li><li>execução de pipelines de CI/CD e investigação de falhas;</li><li>compartilhamento de conhecimento.</li></ul><p>Cada servidor MCP define o que a IA pode fazer (as ferramentas) de um jeito diferente. Por isso, a escolha deve vir depois de definir com clareza os casos de uso.</p><h3 id="compatibilidade-com-o-seu-ambiente-e-as-suas-ferramentas-de-ia">Compatibilidade com o seu ambiente e as suas ferramentas de IA</h3><p>Outro critério importante é se o servidor se integra ao seu ambiente de desenvolvimento e às aplicações de IA que a equipe usa. Como cada servidor MCP se conecta a um conjunto diferente de ferramentas e de IAs, verificar a compatibilidade antes evita problemas depois da adoção.</p><p>A avaliação de um servidor MCP também é uma boa oportunidade para rever, se for o caso, o próprio ambiente de desenvolvimento.</p><h3 id="suporte-e-documentação">Suporte e documentação</h3><p>Para usar um servidor MCP com estabilidade no longo prazo, suporte e documentação são importantes. Verifique, por exemplo, se há canal de atendimento, perguntas frequentes e guias de configuração.</p><p>Com bom suporte e boa documentação, problemas e dúvidas na adoção e na operação se resolvem rápido.</p><p>Também é importante saber se o servidor recebe manutenção e atualizações contínuas.</p><h2 id="o-que-faz-a-ia-ser-melhor-aproveitada-no-desenvolvimento-de-software">O que faz a IA ser melhor aproveitada no desenvolvimento de software</h2><p><img alt="O que faz a IA ser melhor aproveitada no desenvolvimento de software" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1786001465/kahnwrjtveghlqsqrctz.jpg" /></p><p>Para a IA trazer resultados no desenvolvimento de software, um fator é importante: a facilidade de acesso às informações de todo o ciclo de vida do desenvolvimento.</p><p>Explicando melhor: na prática, é comum que código-fonte, issues, dados de CI/CD e outras informações estejam espalhados por várias ferramentas. Nesse cenário, integrar a IA exige combinar vários servidores MCP, o que aumenta a carga de gestão dos desenvolvedores e os riscos de segurança.</p><p>Quando as informações de desenvolvimento estão centralizadas em uma única plataforma, com um servidor MCP compatível com ela, a integração e a gestão ficam simples, e a IA acessa tudo o que precisa de forma transversal.</p><h2 id="por-que-usar-o-gitlab-como-base-para-o-desenvolvimento-com-ia">Por que usar o GitLab como base para o desenvolvimento com IA</h2><p><img alt="Por que usar o GitLab como base para o desenvolvimento com IA" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1757988295/ldz4szcwrxwnpfl0bfnk.png" /></p><p>Para centralizar as informações de desenvolvimento e integrar a IA de forma eficiente, o <a href="https://about.gitlab.com/pt-br/" rel="">GitLab</a> é uma opção que vale considerar.</p><h3 id="todo-o-ciclo-de-desenvolvimento-em-uma-única-plataforma">Todo o ciclo de desenvolvimento em uma única plataforma</h3><p>O <a href="https://about.gitlab.com/pt-br/" rel="">GitLab</a> reúne em uma única plataforma todas as etapas do desenvolvimento de software: gerenciamento de código-fonte, gestão de tarefas, CI/CD e varredura de segurança, entre outras. Todas as informações do desenvolvimento, do código às tarefas, ficam no GitLab. Não é preciso distribuí-las por várias ferramentas, o que reduz custos e trabalho de gestão.</p><p>Com tudo no mesmo lugar, a integração com a IA por meio do servidor MCP do GitLab também fica mais simples.</p><h3 id="o-servidor-mcp-do-gitlab">O servidor MCP do GitLab</h3><p>O <a href="https://docs.gitlab.com/user/gitlab_duo/model_context_protocol/mcp_server/" rel="">servidor MCP do GitLab</a> (em inglês) conecta aplicações de IA às informações de desenvolvimento gerenciadas no GitLab. Com ele, a aplicação de IA acessa as fontes de dados do GitLab e executa ações em nome do usuário, tomando os dados do GitLab como SSoT (<em>single source of truth</em>, ou fonte única da verdade). Tudo o que já está no GitLab, do código às tarefas, é aproveitado como está, o que contribui para um desenvolvimento de software rápido e de alta qualidade.</p><p>O servidor MCP do GitLab funciona com várias aplicações de IA, como o Cursor, o Claude Code e o Claude Desktop, e conta com guias de configuração.</p><h2 id="o-futuro-dos-servidores-mcp">O futuro dos servidores MCP</h2><p><img alt="O futuro dos servidores MCP" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1786001466/xzia6gaea3vkfyqtbsjb.jpg" /></p><p>O MCP é uma tecnologia recente, e a praticidade dos servidores MCP indica que o uso deve se espalhar, no desenvolvimento de software e em outras áreas. A especificação deve continuar evoluindo, o número de ferramentas compatíveis deve crescer e, à medida que mais empresas adotarem a tecnologia, os casos de uso e o conhecimento operacional devem se consolidar.</p><p>À medida que tecnologias como o MCP se firmam no desenvolvimento de software, também deve crescer a necessidade de plataformas que centralizem todas as informações de desenvolvimento, como o <a href="https://about.gitlab.com/pt-br/" rel="">GitLab</a>, para que a integração com a IA traga mais resultado.</p><h2 id="perguntas-frequentes-sobre-servidores-mcp">Perguntas frequentes sobre servidores MCP</h2><p><img alt="Perguntas frequentes sobre servidores MCP" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1786001465/fdh1zesup466xnciyuck.jpg" /></p><h3 id="qual-é-a-diferença-entre-mcp-e-rag">Qual é a diferença entre MCP e RAG?</h3><p>RAG é a sigla de <em>Retrieval-Augmented Generation</em> (geração aumentada por recuperação), uma técnica em que a IA generativa busca, em documentos e materiais externos ao modelo, como os documentos internos de uma empresa, conhecimento especializado que ela não aprendeu no treinamento, para produzir respostas fundamentadas.</p><p>O MCP, por sua vez, é um padrão para conectar a IA a sistemas externos com segurança, permitindo que ela execute ações e obtenha informações por conta própria.</p><p>As duas tecnologias não competem entre si: há casos em que são usadas em conjunto.</p><h3 id="quais-aplicações-de-ia-funcionam-com-servidores-mcp">Quais aplicações de IA funcionam com servidores MCP?</h3><p>Entre as principais aplicações de IA compatíveis com servidores MCP estão:</p><ul><li>ChatGPT (assistente de IA generativa conversacional);</li><li>Claude Code (ferramenta de apoio à programação);</li><li>Claude Desktop (versão para desktop do Claude);</li><li>Cursor (editor de código para desenvolvedores).</li></ul><p>Antes de adotar um servidor MCP, confira com quais aplicações de IA ele funciona.</p><h3 id="é-possível-usar-mais-de-um-servidor-mcp">É possível usar mais de um servidor MCP?</h3><p>Sim. Servidores MCP podem ser combinados conforme a necessidade, e essa facilidade de expansão ajuda a lidar com tarefas complexas e com necessidades que mudam.</p><p>Cada servidor a mais, porém, é mais um item a gerenciar. Por isso, vale considerar a segurança e o esforço de operação antes de adicionar um novo servidor.</p><h2 id="conclusão">Conclusão</h2><p>Com servidores MCP, a IA se conecta a sistemas externos com segurança e eficiência, e boa parte do trabalho de desenvolvimento de software passa a andar mais rápido.</p><p>Para que essa integração funcione ainda melhor, ajuda contar com uma plataforma que reúna as informações de desenvolvimento em um só lugar.</p><p>O <a href="https://about.gitlab.com/pt-br/" rel="">GitLab</a> concentra em uma única ferramenta todas as informações do desenvolvimento de software. Com o servidor MCP do GitLab, esses dados se conectam à IA, que executa uma série de ações de forma automática.</p><p>Se a sua empresa está avaliando servidores MCP, vale conhecer também o que o GitLab oferece.</p><blockquote><p><a href="https://about.gitlab.com/pt-br/pricing/" rel="">Conheça os planos do GitLab</a></p></blockquote><p>Revisão técnica: Hiroyuki Wakabayashi <a href="https://gitlab.com/hwakabayashi" rel="">@hwakabayashi</a><br />
Senior Technical Architect, Professional Services, Customer Success, GitLab G.K. (Japão)</p>]]></content>
        <author>
            <name>GitLab Team</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/gitlab-team/</uri>
        </author>
        <published>2026-11-10T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Guia de API REST]]></title>
        <id>https://about.gitlab.com/pt-br/blog/guide-to-rest-api/</id>
        <link href="https://about.gitlab.com/pt-br/blog/guide-to-rest-api/"/>
        <updated>2026-11-09T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>Seja no desenvolvimento de um app de reservas online, de uma solução de pagamento mobile ou de um serviço de mensagens, é bem provável que a sua equipe esteja usando uma API REST. Neste artigo, explicamos o que é uma API REST e como ela funciona, além dos seus benefícios e usos.</p><h2 id="o-que-é-uma-api-rest">O que é uma API REST?</h2><p>API REST, API RESTful ou API web RESTful: todos esses nomes designam APIs que seguem um padrão específico, a arquitetura REST. Antes de ir adiante, vale lembrar que uma API, ou interface de programação de aplicações, é um software que permite que duas aplicações se comuniquem. Na computação, as APIs são essenciais para que diferentes aplicações funcionem em conjunto.</p><p>Para criar uma API, os desenvolvedores seguem métodos e princípios rigorosamente definidos, para que o conjunto funcione. Antes dos anos 2000, os desenvolvedores usavam o <a href="https://www.techtarget.com/searchapparchitecture/definition/SOAP-Simple-Object-Access-Protocol" rel="">SOAP</a> (Simple Object Access Protocol), um protocolo baseado em XML (Extensible Markup Language), complexo de coordenar e que consumia muitos recursos. Embora o SOAP ainda seja usado hoje, ele foi amplamente substituído pela API REST.</p><p>Criado em 2000 pelo cientista da computação norte-americano Roy Fielding durante a sua tese de doutorado, o REST (REpresentational State Transfer) se tornou o modelo dominante para criar APIs e um marco essencial na evolução da World Wide Web. Hoje, a grande maioria das APIs se baseia no REST, principalmente para oferecer serviços web, interativos ou mobile. Vamos ver como as APIs RESTful funcionam, quais são as suas vantagens e as suas diversas aplicações.</p><h2 id="como-funciona-uma-api-rest">Como funciona uma API REST?</h2><p>Na prática, a API REST funciona com base no princípio do ambiente cliente-servidor. A API RESTful recebe e transmite, de um lado, as requisições de um usuário ou de uma aplicação e, do outro, as informações devolvidas pelo servidor (aplicação ou banco de dados).</p><p>Alguns conceitos-chave ajudam a entender como uma API RESTful funciona. O cliente é a entidade que faz uma requisição. É o caso, por exemplo, de um usuário que faz uma busca em um catálogo de produtos no navegador. A API é responsável por comunicar a requisição ao servidor e devolver ao cliente as informações solicitadas. As informações que passam pela API são os recursos. O servidor processa as requisições. Neste caso, ele vai devolver a lista de produtos que correspondem aos critérios de busca.</p><p>As requisições do cliente são feitas pelo protocolo HTTP (Hypertext Transfer Protocol). Estes são os principais métodos e as tarefas que eles permitem realizar:</p><ul><li>GET: recuperar dados enviados pelo servidor.</li><li>POST: enviar e publicar informações no servidor (dados de um formulário de cadastro, por exemplo).</li><li>PUT: atualizar as informações do servidor.</li><li>PATCH: modificar parcialmente um recurso existente.</li><li>DELETE: excluir informações do servidor.</li></ul><p>Há vários formatos de dados para usar uma API REST. O formato JSON (JavaScript Object Notation) é leve, fácil de entender e utilizável por muitas linguagens de programação. O XML permite gerenciar estruturas de dados complexas e é compatível com outros padrões, como o RSS. YAML e HTML são outros formatos usados com frequência para comunicar recursos.</p><h2 id="quais-são-os-princípios-da-api-rest">Quais são os princípios da API REST?</h2><p>Uma API REST segue os princípios REST de arquitetura de software. Esses princípios funcionam como diretriz para criar APIs flexíveis e leves, perfeitamente adequadas à transmissão de dados pela internet.</p><p>Estes são os seis princípios de arquitetura que regem uma interface REST:</p><ul><li>Desacoplamento entre cliente e servidor. O cliente conhece apenas o URI (Uniform Resource Identifier) do recurso a ser recuperado. O servidor interage apenas transmitindo os seus dados via HTTP.</li><li>Interface uniforme. A arquitetura REST padroniza a forma como as informações são identificadas, gerenciadas e transmitidas, e usa hiperlinks para levar recursos adicionais ao cliente.</li><li>Código sob demanda. O servidor pode transmitir código ao cliente para ampliar as suas funcionalidades, por exemplo, para ajudar a identificar erros em um formulário.</li><li>Sistema em camadas. Uma API RESTful pode rodar em vários servidores organizados de forma hierárquica, para oferecer ao cliente um serviço mais estável e eficiente.</li><li>Armazenável em cache. O servidor REST pode armazenar dados em cache para atender melhor o cliente, por exemplo, guardando as imagens de um site para servi-las novamente depois.</li><li>Sem estado (stateless). Cada requisição do cliente é independente e processada isoladamente pelo servidor. Por isso, cada requisição precisa conter todos os elementos necessários para o seu processamento.</li></ul><h2 id="quais-são-os-benefícios-de-uma-api-rest">Quais são os benefícios de uma API REST?</h2><p>Ao seguir os requisitos do framework da API REST, os desenvolvedores aproveitam as muitas vantagens da API RESTful para criar aplicações eficazes e poderosas:</p><ul><li>Versatilidade: não há restrições quanto à linguagem de programação, e há uma grande variedade de formatos de dados (XML, PYTHON, JSON, HTML etc.).</li><li>Leveza: os formatos de dados leves de uma API REST a tornam ideal para aplicações mobile ou para a Internet das Coisas (IoT).</li><li>Portabilidade: a separação entre cliente e servidor permite a troca de dados entre plataformas.</li><li>Flexibilidade: esta API não tem as complexidades de um protocolo, já que é um estilo de arquitetura.</li><li>Independência: os desenvolvedores podem trabalhar separadamente na parte do cliente ou do servidor.</li></ul><p>Os benefícios da API REST se traduzem em mais produtividade e escalabilidade para as equipes de desenvolvimento. Escalar sistemas que usam API REST é mais fácil. Assim, as funcionalidades conseguem suportar melhor uma grande carga de usuários e operações.</p><h2 id="restrições-de-segurança">Restrições de segurança</h2><p>Criar e gerenciar uma API web RESTful tem os seus desafios. A autenticação de usuários pode ficar complexa quando usa vários métodos diferentes, como HTTP, chaves de API ou OAuth (Open Authorization). Em aplicações grandes e complexas, a multiplicação de endpoints entre o servidor e o cliente pode prejudicar a consistência geral, assim como as atualizações que deixam pontos de contato antigos ainda ativos.</p><p>Além disso, a interface REST tem um ponto fraco: ela transmite dados potencialmente sensíveis, como identificadores, pela URL do endpoint. Protegê-la exige medidas específicas, como criptografia Transport Layer Security (TLS), um modelo robusto de autenticação de usuários e um sistema para lidar com requisições maliciosas e limitar a vazão.</p><h2 id="usos-de-uma-api-rest">Usos de uma API REST</h2><p>Os desenvolvedores usam APIs com arquitetura REST para criar e manter muitos serviços. Por isso, a maioria das aplicações web e mobile usa APIs REST para acessar e compartilhar recursos e informações. Na nuvem, esse tipo de API permite conectar rapidamente os serviços de arquiteturas distribuídas e híbridas. Em grandes empresas, ele viabiliza a interoperabilidade entre os componentes dos sistemas de informação.</p><p>Atualizar os preços de um e-commerce, automatizar publicações, <a href="https://about.gitlab.com/pt-br/blog/kubernetes-the-container-orchestration-solution/" rel="">orquestrar clusters do Kubernetes</a>… O escopo de uso das APIs RESTful é limitado apenas pela imaginação dos desenvolvedores e criadores de aplicações digitais.</p><h2 id="a-api-rest-do-gitlab">A API REST do GitLab</h2><p>O <a href="https://about.gitlab.com/pt-br/" rel="">GitLab</a> oferece um conjunto completo de ferramentas e APIs para integrar e automatizar aplicações externas. Ele inclui GraphQL, webhooks, extensões de IDE e, claro, uma API REST. A API REST do GitLab pode ser autenticada de várias formas, como por token de acesso, OAuth ou cookies de sessão. Há endpoints disponíveis para templates de Dockerfile, .gitignore, <a href="https://docs.gitlab.com/ci/yaml/" rel="">GitLab CI/CD YAML</a> e de código aberto. Para aproveitar ao máximo todas as possibilidades no desenvolvimento das suas aplicações ágeis e cloud native, consulte a <a href="https://docs.gitlab.com/api/rest/" rel="">documentação completa da API REST do GitLab</a> (em inglês).</p><h2 id="perguntas-frequentes">Perguntas frequentes</h2><p><strong>O que é uma API REST?</strong></p><p>Uma API REST é uma interface de programação de aplicações que segue o estilo de arquitetura REST (REpresentational State Transfer) e permite que duas aplicações se comuniquem pela internet de forma leve e escalável.</p><p><strong>Como funciona uma API REST?</strong></p><p>Uma API REST opera em um modelo cliente-servidor, em que o cliente envia requisições HTTP a um servidor, e o servidor processa essas requisições e devolve os dados ou recursos correspondentes. Os métodos HTTP mais comuns são GET, POST, PUT, PATCH e DELETE.</p><p><strong>Quais são os seis princípios de uma API REST?</strong></p><p>Uma API REST segue os seis princípios principais da arquitetura REST: interface uniforme, código sob demanda, sistema em camadas, armazenável em cache, sem estado e desacoplamento entre cliente e servidor. Este último princípio é a base da estrutura de uma API RESTful e é essencial para o sucesso dessa API no mundo das aplicações web.</p><p><strong>Quais formatos de dados uma API REST aceita?</strong></p><p>As APIs REST aceitam vários formatos de dados, entre eles JSON, XML, YAML e HTML. O JSON é o mais usado, graças à sua estrutura leve e à compatibilidade com muitas linguagens de programação.</p><p><strong>Quais são os benefícios de usar uma API REST?</strong></p><p>As APIs REST oferecem versatilidade, formatos de dados leves, portabilidade, flexibilidade e independência entre o desenvolvimento do cliente e o do servidor. Essas vantagens se traduzem em mais produtividade e em escalabilidade mais fácil para as equipes de desenvolvimento.</p><p><strong>Quais são os cuidados de segurança com uma API REST?</strong></p><p>As APIs REST podem expor dados sensíveis pelas URLs dos endpoints. Por isso, protegê-las exige medidas como criptografia Transport Layer Security (TLS), um modelo de autenticação robusto e sistemas para lidar com requisições maliciosas e limitar a vazão.</p><p><strong>Qual é a diferença entre REST e SOAP?</strong></p><p>O REST é um estilo de arquitetura leve e flexível, que aceita vários formatos de dados, enquanto o SOAP é um protocolo mais antigo e mais rígido, disponível apenas em XML. O SOAP ainda pode ser usado em aplicações que exigem um alto nível de segurança.</p><p><strong>O GitLab oferece uma API REST?</strong></p><p>Sim, o GitLab oferece uma API REST como parte do seu conjunto de ferramentas de integração e automação. Ela aceita autenticação por tokens de acesso, OAuth e cookies de sessão, com endpoints disponíveis para templates de Dockerfile, .gitignore, GitLab CI/CD YAML e de código aberto.</p><h2 id="saiba-mais">Saiba mais</h2><ul><li><a href="https://docs.gitlab.com/api/rest/" rel="">Documentação da API REST do GitLab</a> (em inglês)</li><li><a href="https://docs.gitlab.com/api/" rel="">Extend with GitLab</a> (em inglês)</li></ul>]]></content>
        <author>
            <name>GitLab</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/gitlab/</uri>
        </author>
        <published>2026-11-09T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Como usar o GitLab no desenvolvimento ágil de software]]></title>
        <id>https://about.gitlab.com/pt-br/blog/gitlab-for-agile-software-development/</id>
        <link href="https://about.gitlab.com/pt-br/blog/gitlab-for-agile-software-development/"/>
        <updated>2026-11-06T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>O GitLab atende à <a href="https://about.gitlab.com/pt-br/solutions/agile-delivery/" rel="">metodologia ágil</a>? Para quem está avaliando o GitLab, nem sempre é óbvio como os recursos da plataforma DevSecOps se relacionam com os artefatos ágeis. Por isso, organizamos uma explicação sobre esta correspondência aqui.</p><p>A metodologia ágil (ou agile em inglês) é uma das mais importantes e transformadoras proposições que a engenharia de software conheceu nas últimas décadas. Mesmo que nem todo mundo concorde com a terminologia detalhada dos conceitos ágeis, o impacto positivo é inegável: equipes de desenvolvimento de software passaram a criar, com eficiência, produtos centrados no cliente por meio de processos de <a href="https://about.gitlab.com/pt-br/topics/agile-delivery/" rel="">desenvolvimento e entrega ágeis de software</a>.</p><p>O GitLab foi pensado para ser flexível o bastante para se adaptar à sua metodologia de desenvolvimento de software, seja ela ágil ou apenas influenciada pelo ágil. Neste artigo, mostramos uma correspondência simples entre artefatos ágeis e recursos do GitLab, e explicamos como clientes conduzem com sucesso <a href="https://about.gitlab.com/pt-br/solutions/agile-delivery/" rel="">equipes ágeis de entrega de software</a> de alto desempenho com o GitLab.</p><h2 id="correspondência-entre-artefatos-ágeis-e-recursos-do-gitlab">Correspondência entre artefatos ágeis e recursos do GitLab</h2><h3 id="artefato-ágil-recurso-do-gitlab">Artefato ágil → recurso do GitLab</h3><ul><li>História de usuário → <a href="https://docs.gitlab.com/user/project/issues/" rel="">Issues</a></li><li>Tarefa → <a href="https://docs.gitlab.com/user/tasks/" rel="">Tasks</a></li><li>Épico → <a href="https://docs.gitlab.com/user/group/epics/" rel="">Épicos</a></li><li>Pontos e estimativa → <a href="https://docs.gitlab.com/user/project/issues/issue_weight/" rel="">Peso da issue</a></li><li>Backlog do produto → <a href="https://docs.gitlab.com/user/project/issue_board/" rel="">Quadros de issues</a></li><li>Sprint/iteração → <a href="https://docs.gitlab.com/user/group/iterations/" rel="">Iterações</a></li><li>Quadro ágil → <a href="https://docs.gitlab.com/user/project/issue_board/" rel="">Quadros de issues</a></li><li>Carga de trabalho da equipe → <a href="https://docs.gitlab.com/user/project/issue_board/" rel="">Quadros de issues</a></li><li>Gráfico de burndown → <a href="https://docs.gitlab.com/user/project/milestones/burndown_and_burnup_charts/" rel="">Gráficos de burndown</a></li></ul><h2 id="uma-iteração-ágil-com-o-gitlab">Uma iteração ágil com o GitLab</h2><h3 id="histórias-de-usuário-issues-do-gitlab">Histórias de usuário → issues do GitLab</h3><p>No desenvolvimento ágil de software, o ponto de partida costuma ser uma história de usuário, que descreve uma única funcionalidade capaz de gerar valor de negócio para os usuários. No GitLab, uma <a href="https://docs.gitlab.com/user/project/issues/" rel="">issue</a> cumpre esse papel com facilidade. As issues são essenciais para equipes ágeis, porque oferecem uma forma eficaz de gerenciar tarefas e projetos. Os desenvolvedores podem criar, atribuir e acompanhar issues, com responsabilidades claras e visibilidade do andamento. As issues trazem metadados robustos, como responsável, iteração, peso e labels, que ajudam a priorizar tarefas e a gerir o fluxo de trabalho ao longo de todo o processo de desenvolvimento. Além disso, a colaboração da equipe nas issues fica mais simples com threads de discussão, anexos e atualizações em tempo real, o que favorece a comunicação e o trabalho em equipe.</p><p><img alt="captura de tela de uma issue do GitLab" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097468/Blog/Content%20Images/Blog/Content%20Images/image1_aHR0cHM6_1750097468371.png" /></p><p>A issue do GitLab tem um título e uma área de descrição no centro, um espaço para documentar qualquer detalhe, como o valor de negócio e as personas relevantes de uma história de usuário. A barra lateral à direita reúne a integração com outros recursos compatíveis com o ágil, como o épico pai ao qual a issue pertence, a iteração em que a issue deve ser trabalhada e o peso da issue, que reflete o esforço estimado.</p><h3 id="tarefa-tasks">Tarefa → tasks</h3><p>Muitas vezes, uma história de usuário é dividida em tarefas individuais. As <a href="https://docs.gitlab.com/user/tasks/" rel="">tasks</a> do GitLab simplificam a gestão de projetos ao permitir que equipes ágeis dividam as histórias de usuário em partes de trabalho bem delimitadas. Esse recurso apoia o framework ágil, pois permite que os desenvolvedores criem, atribuam e acompanhem tasks dentro dos seus projetos. Com a gestão de tarefas integrada diretamente ao GitLab, as equipes mantêm um fluxo de trabalho coeso, em que todas as atividades do projeto de desenvolvimento são acompanhadas e gerenciadas com facilidade.</p><p><img alt="captura de tela mostrando a gestão precisa de tarefas e o acompanhamento de projetos no GitLab" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097469/Blog/Content%20Images/Blog/Content%20Images/image3_aHR0cHM6_1750097468372.png" /></p><p>Gerar mais valor para o usuário passa por uma gestão precisa de tarefas e pelo acompanhamento de projetos no GitLab. As tasks têm os mesmos metadados das issues, incluindo responsável, iteração, peso, labels, controle de tempo e recursos de colaboração. Esse conjunto completo de recursos permite que equipes ágeis e gerentes de projeto administrem a carga de trabalho com eficácia, priorizem tarefas e garantam uma colaboração sem atritos entre os desenvolvedores.</p><h3 id="épicos-épicos-do-gitlab">Épicos → épicos do GitLab</h3><p>No sentido oposto, alguns praticantes da metodologia ágil definem uma abstração acima das histórias de usuário, geralmente chamada de épico, que representa um fluxo maior do usuário, composto de várias funcionalidades. No GitLab, um <a href="https://docs.gitlab.com/user/group/epics/" rel="">épico</a> também tem um título e uma descrição, bem como uma issue, mas permite vincular várias issues filhas a ele para indicar essa hierarquia.</p><p><img alt="captura de tela de épicos aninhados no GitLab" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097469/Blog/Content%20Images/Blog/Content%20Images/image7_aHR0cHM6_1750097468374.png" /></p><p>Com os épicos do GitLab, equipes ágeis organizam e gerenciam grandes projetos com eficiência, aninhando épicos em até sete níveis. Essa estrutura hierárquica oferece uma visão clara do roadmap do projeto e ajuda desenvolvedores e gerentes de projeto a dividir iniciativas complexas em partes gerenciáveis. Com épicos filhos e <a href="https://docs.gitlab.com/user/group/epics/linked_epics/" rel="">épicos vinculados</a>, as equipes acompanham melhor o andamento, as dependências e os marcos do projeto, o que fortalece a colaboração e garante uma entrega ágil coesa.</p><h3 id="backlog-do-produto-quadros-de-issues-do-gitlab">Backlog do produto → quadros de issues do GitLab</h3><p>Normalmente, quem cria essas histórias de usuário são os responsáveis pelo produto ou pelo negócio, para refletir as necessidades da empresa e dos clientes. As histórias são priorizadas em um backlog do produto, que registra a urgência e a ordem desejada de desenvolvimento. O product owner conversa com os stakeholders para definir as prioridades e refina o backlog continuamente. No GitLab, um <a href="https://docs.gitlab.com/user/project/issue_board/" rel="">quadro de issues</a> organizado com as iterações como listas oferece um fluxo de trabalho de arrastar e soltar, que facilita a priorização do backlog e a atribuição de histórias à próxima sprint.</p><p><img alt="GIF do quadro de issues do GitLab" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097469/Blog/Content%20Images/Blog/Content%20Images/WIP_limit_aHR0cHM6_1750097468376.gif" /></p><h3 id="sprints-iterações-do-gitlab">Sprints → iterações do GitLab</h3><p>Uma sprint é um período finito em que o trabalho deve ser concluído: uma semana, algumas semanas ou talvez um mês ou mais. O product owner e a equipe de desenvolvimento se reúnem para decidir o que entra no escopo da próxima sprint. O recurso de <a href="https://docs.gitlab.com/user/group/iterations/" rel="">iterações</a> do GitLab apoia esse processo: cada iteração recebe uma data de início e uma data de término, que delimitam o seu período. Em seguida, a equipe coloca issues na sprint atribuindo-as àquela iteração específica.</p><p>Ao usar iterações, você aproveita os recursos avançados do GitLab para a gestão ágil de projetos, com mais visibilidade e controle sobre o <a href="/blog/ditch-your-legacy-planning-tool-get-agile-with-gitlab/">planejamento e a entrega ágeis</a>.</p><h3 id="pontos-e-estimativa-peso-da-issue-no-gitlab">Pontos e estimativa → peso da issue no GitLab</h3><p>Nessa mesma reunião, as histórias de usuário são apresentadas, e o nível de esforço técnico é estimado para cada história que entra no escopo. No GitLab, as issues têm um atributo de <a href="https://docs.gitlab.com/user/project/issues/issue_weight/" rel="">peso</a>, usado para indicar o esforço estimado.</p><p>Nessa reunião (ou nas seguintes), as histórias de usuário são divididas em entregáveis técnicos, às vezes com a documentação de planos técnicos e da arquitetura. No GitLab, essas informações podem ficar na issue ou na <a href="https://docs.gitlab.com/user/project/merge_requests/" rel="">descrição da merge request</a>, já que é na merge request que a colaboração técnica costuma acontecer.</p><p>Durante a sprint (a iteração do GitLab), os membros da equipe de desenvolvimento pegam as histórias de usuário, uma de cada vez, para trabalhar. No GitLab, as issues têm responsáveis. Basta <a href="https://docs.gitlab.com/user/project/issues/multiple_assignees_for_issues/" rel="">atribuir</a> a issue a si mesmo para indicar que você está trabalhando nela. Recomendamos <a href="https://docs.gitlab.com/user/project/issues/" rel="">criar primeiramente uma merge request vazia e vinculada à issue</a> para dar início à colaboração técnica antes mesmo de escrever a primeira linha de código.</p><h3 id="quadro-ágil-quadros-de-issues-do-gitlab">Quadro ágil → quadros de issues do GitLab</h3><p>Ao longo da sprint, as issues passam por várias etapas, como <code>Ready for dev</code>, <code>In dev</code>, <code>In QA</code>, <code>In review</code> e <code>Done</code>, de acordo com o fluxo de trabalho de cada organização. Em geral, essas etapas são colunas em um quadro ágil. No GitLab, os <a href="https://docs.gitlab.com/user/project/issue_board/" rel="">quadros de issues</a> permitem definir as etapas e mover as issues por elas. A equipe pode <a href="https://docs.gitlab.com/user/project/issue_board/#board-with-configuration" rel="">configurar o quadro</a> de acordo com a iteração e outros atributos relevantes. Nas reuniões diárias, a equipe olha o quadro em conjunto para ver o status da sprint do ponto de vista do fluxo de trabalho.</p><p><img alt="captura de tela do quadro de issues do GitLab" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097469/Blog/Content%20Images/Blog/Content%20Images/image6_aHR0cHM6_1750097468378.png" /></p><p>O quadro de issues do GitLab também carrega as issues de forma dinâmica, como a lista de issues, mas permite fluxos de trabalho mais flexíveis. É possível criar listas individuais no quadro para refletir as etapas do quadro ágil. Assim, a equipe controla e acompanha as histórias de usuário enquanto elas avançam, por exemplo, de <code>Ready for dev</code> até <code>Released to production</code>.</p><h3 id="carga-de-trabalho-da-equipe-quadros-de-issues-do-gitlab">Carga de trabalho da equipe → quadros de issues do GitLab</h3><p>Equipes ágeis podem otimizar o fluxo de trabalho criando, no GitLab, quadros de issues com listas por responsável. Esse recurso permite visualizar a distribuição das tarefas entre os membros da equipe, o que fortalece a entrega ágil. Para configurar, acesse o projeto ou grupo, crie um novo quadro na seção &quot;Boards&quot; e <a href="https://docs.gitlab.com/user/project/issue_board/#create-a-new-list" rel="">adicione listas</a> para cada responsável. Atribua as issues aos membros da equipe, e elas vão aparecer automaticamente nas listas correspondentes. Essa visão dinâmica ajuda a equilibrar a carga de trabalho e a gerir as tarefas com eficácia.</p><p><img alt="captura de tela de um quadro de issues organizado no GitLab" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097469/Blog/Content%20Images/Blog/Content%20Images/image5_aHR0cHM6_1750097468380.png" /></p><p>Também é possível organizar um quadro de issues por responsável ou por squad usando <a href="https://docs.gitlab.com/user/project/labels/#scoped-labels" rel="">labels com escopo</a>. O quadro de issues do GitLab é incrivelmente versátil e apoia fluxos de trabalho em todo o ciclo de vida de desenvolvimento de software.</p><h3 id="gráficos-de-burndown-gráficos-de-burndown-do-gitlab">Gráficos de burndown → gráficos de burndown do GitLab</h3><p>A equipe de desenvolvimento quer saber, em tempo real, se está no caminho certo e mitigar os riscos à medida que surgem. O GitLab oferece <a href="https://docs.gitlab.com/user/project/milestones/burndown_and_burnup_charts/" rel="">gráficos de burndown</a>, que permitem à equipe visualizar o trabalho previsto para a sprint atual sendo &quot;queimado&quot; à medida que é concluído.</p><p>Perto do fim da sprint, a equipe de desenvolvimento demonstra as funcionalidades concluídas para os diversos stakeholders. Com o GitLab, esse processo fica simples com os <a href="https://docs.gitlab.com/ci/review_apps/" rel="">Review Apps</a>: até mesmo códigos que ainda não foram para produção, mas que estão em ambientes de teste, staging ou UAT (testes de aceitação do usuário), podem ser demonstrados. Os Review Apps e os <a href="https://docs.gitlab.com/ci/" rel="">recursos de CI/CD</a> são integrados à própria merge request.</p><p>Essas mesmas ferramentas ajudam desenvolvedores e QA a manter a qualidade do software, seja com testes automatizados em CI/CD, seja com testes manuais em um ambiente de Review App.</p><p><img alt="captura de tela do gráfico de burndown do GitLab" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097469/Blog/Content%20Images/Blog/Content%20Images/image8_aHR0cHM6_1750097468381.png" /></p><p>O gráfico de burndown do GitLab permite que a equipe acompanhe o trabalho previsto sendo &quot;queimado&quot; à medida que é concluído ao longo da sprint. Assim, dá para reagir aos riscos mais cedo e se adaptar, por exemplo, avisando os stakeholders de negócio de que determinadas funcionalidades devem ficar para uma sprint futura.</p><p>As retrospectivas da equipe ao fim da sprint podem ser documentadas na <a href="https://docs.gitlab.com/user/project/wiki/" rel="">wiki</a> do GitLab, para que as lições aprendidas e os itens de ação sejam acompanhados ao longo do tempo. Durante a retrospectiva, a equipe pode consultar o <a href="https://docs.gitlab.com/user/group/iterations/#iteration-report" rel="">relatório da iteração</a>, que mostra o gráfico de burndown e outras estatísticas da sprint concluída.</p><h2 id="comece-a-sua-jornada-ágil-com-o-gitlab">Comece a sua jornada ágil com o GitLab</h2><p>Pronto para levar a gestão ágil de projetos a outro patamar? O GitLab oferece um conjunto completo de recursos pensados para equipes ágeis, desenvolvedores e gerentes de projeto, com colaboração sem atritos e fluxos de trabalho eficientes. Conheça as opções de planos e preços, <a href="https://about.gitlab.com/pt-br/free-trial/" rel="">comece uma avaliação gratuita</a> e descubra como o GitLab pode transformar os seus processos de entrega ágil.</p><blockquote><p><a href="https://about.gitlab.com/pt-br/pricing/" rel="">Confira os planos e preços do GitLab</a> e comece a sua jornada hoje mesmo!</p></blockquote><h2 id="perguntas-frequentes">Perguntas frequentes</h2><p><strong>Como os artefatos ágeis correspondem aos recursos do GitLab?</strong></p><p>O GitLab corresponde diretamente aos artefatos ágeis mais comuns: histórias de usuário viram issues, tarefas viram tasks, épicos viram épicos do GitLab, sprints viram iterações e quadros ágeis viram quadros de issues. O peso da issue cuida dos pontos e da estimativa, e os gráficos de burndown acompanham o andamento da sprint.</p><p><strong>Como o GitLab lida com sprints ou iterações?</strong></p><p>O recurso de iterações do GitLab permite definir uma data de início e uma data de término para delimitar o período de uma sprint, e os membros da equipe atribuem issues a uma iteração específica para indicar o que está no escopo. Isso traz mais visibilidade e controle sobre o planejamento e a entrega ágeis.</p><p><strong>Qual é o papel dos quadros de issues do GitLab nos fluxos de trabalho ágeis?</strong></p><p>No GitLab, os quadros de issues cumprem vários papéis do ágil: funcionam como backlog do produto, como quadro ágil para acompanhar as etapas do fluxo de trabalho e como visão da carga de trabalho da equipe quando organizados por responsável. As equipes podem arrastar e soltar issues entre etapas personalizadas, como &quot;Ready for dev&quot;, &quot;In QA&quot; e &quot;Done&quot;, ao longo da sprint.</p><p><strong>Como o GitLab apoia a estimativa e o acompanhamento de esforço?</strong></p><p>As issues do GitLab têm um atributo de peso que as equipes usam para indicar o esforço estimado de cada história de usuário, no lugar dos tradicionais story points. Esse metadado também está disponível nas tasks, o que dá às equipes uma estimativa consistente em todos os níveis de trabalho.</p><p><strong>O GitLab consegue mostrar se uma sprint está no caminho certo?</strong></p><p>Sim. O GitLab oferece gráficos de burndown que mostram o trabalho sendo &quot;queimado&quot; à medida que as issues são concluídas na sprint, o que permite identificar riscos cedo e comunicar possíveis atrasos aos stakeholders.</p><p><strong>Como o GitLab apoia as demos da sprint e a garantia de qualidade?</strong></p><p>Os Review Apps do GitLab permitem que as equipes demonstrem funcionalidades que ainda não foram para produção, diretamente de ambientes de teste ou de staging. Eles são integrados às merge requests, junto com os recursos de CI/CD, tanto para testes automatizados quanto manuais.</p><p><strong>Onde documentar as retrospectivas da sprint no GitLab?</strong></p><p>As equipes podem documentar as retrospectivas na wiki integrada do GitLab, para acompanhar as lições aprendidas e os itens de ação ao longo do tempo. O relatório da iteração, que inclui o gráfico de burndown e as estatísticas da sprint, também pode ser consultado durante a retrospectiva.</p><p><strong>Como o GitLab apoia iniciativas ágeis maiores, além das histórias de usuário?</strong></p><p>Os épicos do GitLab permitem agrupar várias issues relacionadas em uma iniciativa maior, com épicos aninhados em até sete níveis. Essa estrutura hierárquica ajuda as equipes a acompanhar o andamento, as dependências e os marcos em projetos complexos.</p>]]></content>
        <author>
            <name>Victor Wu</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/victor-wu/</uri>
        </author>
        <author>
            <name>Amanda Rueda</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/amanda-rueda/</uri>
        </author>
        <published>2026-11-06T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[O GitLab e as Três Maneiras do DevOps]]></title>
        <id>https://about.gitlab.com/pt-br/blog/gitlab-and-the-three-ways-of-devops/</id>
        <link href="https://about.gitlab.com/pt-br/blog/gitlab-and-the-three-ways-of-devops/"/>
        <updated>2026-11-03T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>A maior parte das minhas conversas do dia a dia gira em torno de recursos e de conceitos técnicos bem aprofundados, que trazem insights valiosos e práticos. Só que, nesse caminho, perdemos de vista algo importante: ferramentas e tecnologia existem para resolver desafios de negócio. Quando a conversa fica em recursos e tecnologia, é fácil enxergar o possível ganho financeiro de substituir várias ferramentas por uma plataforma unificada. O que fica de fora são todas as oportunidades de melhoria que geram valor em todos os níveis da empresa, dos desenvolvedores aos executivos.</p><p>A verdade é que trabalhamos em sistemas muito complexos, e muitas vezes as árvores não deixam ver a floresta. Quem está na engenharia se concentra em resolver o próximo problema imediato, sem dar um passo atrás para reavaliar o próprio sistema. Em alguns casos, o problema nasce justamente do desenho do nosso <a href="https://handbook.gitlab.com/handbook/security/policies_and_standards/software-development-lifecycle-standard/" rel="">ciclo de vida de desenvolvimento de software (SDLC)</a>. Para quem está na liderança, é difícil equilibrar o esforço necessário para tratar os desafios técnicos com a pressão que vem do negócio, em um ritmo de mudança que só aumenta.</p><p>Meu objetivo com este artigo é oferecer um mapa de alto nível com os princípios mais importantes do <a href="https://about.gitlab.com/pt-br/topics/devops/" rel="">DevOps</a>, e também um atalho. Sei que é uma afirmação ousada, porque há muita literatura sobre o tema, mas a minha abordagem vai ser diferente.</p><p>Primeiro, vou usar as <a href="https://itrevolution.com/the-three-ways-principles-underpinning-devops/" rel="">Três Maneiras</a> (em inglês), conceito cunhado no livro <a href="https://www.amazon.com/DevOps-Handbook-World-Class-Reliability-Organizations/dp/1942788002" rel="">The DevOps Handbook</a>, porque esses são os três princípios fundamentais do DevOps, refinados a partir do Lean, do Sistema Toyota de Produção, da Teoria das Restrições, do Seis Sigma e do pensamento sistêmico. Segundo, vou usar o GitLab como a ferramenta de referência, porque acredito que uma boa ferramenta permite que o foco fique no trabalho em si, e o GitLab faz exatamente isso.</p><blockquote><p>Você está convidado! Participe conosco, no dia 23 de junho, do <a href="https://page.gitlab.com/fifteen" rel="">evento de lançamento do GitLab 15</a>, com o guru do DevOps Gene Kim e várias lideranças do GitLab. Eles vão mostrar o que enxergam para o futuro do DevOps e da One DevOps Platform.</p></blockquote><p>A seguir, uma breve descrição do que são as Três Maneiras, do que tratam e por que elas importam.</p><h2 id="primeira-maneira-maximizar-o-fluxo">Primeira Maneira: maximizar o fluxo</h2><p>A Primeira Maneira tem tudo a ver com fazer o trabalho e o valor fluírem melhor por todo o fluxo de valor (da esquerda para a direita). Para isso, é preciso adotar o pensamento sistêmico e olhar sempre para o resultado de ponta a ponta. Em TI, isso significa otimizar a velocidade desde o momento em que surge a ideia até o software gerar valor rodando em produção.</p><p>Precisamos entender bem o sistema para encontrar possíveis gargalos e pontos de melhoria. As melhorias devem sempre levar a um desempenho geral melhor; por isso, é preciso reconhecer os casos em que um ganho local provoca uma piora global, e evitá-los.</p><p>Nesse processo, é fundamental impedir que defeitos passem de uma etapa do fluxo de trabalho para as etapas seguintes. Por quê? Porque defeitos geram desperdício (de tempo e de recursos).</p><h2 id="segunda-maneira-ciclos-de-feedback">Segunda Maneira: ciclos de feedback</h2><p>A Segunda Maneira trata dos ciclos de feedback: ampliá-los e encurtá-los para obter insights valiosos sobre o trabalho que estamos fazendo. O feedback pode dizer respeito ao código escrito ou às iniciativas de melhoria. Os ciclos de feedback maximizam o fluxo no sentido contrário do fluxo de valor, da direita para a esquerda.</p><p>Ciclos de feedback rápidos e consistentes ajudam a incorporar qualidade ao produto e garantem que os defeitos não sigam para as etapas seguintes. Quanto antes isso acontece, mais rápido e mais barato é resolver os problemas, mantendo o software continuamente pronto para deploy. Para um desenvolvedor, é mais fácil corrigir um bug enquanto ainda está trabalhando na alteração, com o código e o raciocínio frescos na memória. Agora imagine que se passem dias, ou até semanas, entre o commit e o momento em que percebemos que há um problema com a alteração. Vai ser bem mais difícil resolvê-lo, sem contar que provavelmente só percebemos o problema na hora de fazer o deploy, e agora temos nas mãos um serviço que não funciona. Por outro lado, os ciclos de feedback viabilizam o aprendizado e a experimentação, um ponto ao qual volto um pouco mais adiante.</p><p>Em geral, mais desenvolvedores significam mais produtividade, mas, como mostra o <a href="https://cloud.google.com/blog/products/devops-sre/announcing-dora-2021-accelerate-state-of-devops-report" rel="">State of DevOps Report</a>, isso só vale para as equipes de alto desempenho. Por quê? Se temos uma equipe de 50 desenvolvedores e os problemas não são detectados de imediato, a dívida técnica se acumula. A situação só piora com 100 desenvolvedores, porque eles vão gerar ainda mais dívida técnica a cada ciclo de desenvolvimento. A tendência natural seria contratar mais desenvolvedores na esperança de que a velocidade melhore, mas ela piora; então contratamos ainda mais gente, tudo piora ainda mais, e a frequência de deploy começa a sofrer, porque leva muito tempo corrigir todos os problemas que vieram das etapas anteriores até chegar a um estado pronto para deploy.</p><h2 id="terceira-maneira-experimentação-e-aprendizado-contínuos">Terceira Maneira: experimentação e aprendizado contínuos</h2><p>A Terceira Maneira consiste em criar uma cultura de confiança em que a experimentação e o aprendizado contínuos possam prosperar. Para dar certo, ela se apoia nas duas primeiras.</p><p>Quando o trabalho flui com facilidade pelo fluxo de valor, podemos experimentar e até correr alguns riscos, falhando rápido e com baixo custo. Os ciclos de feedback funcionam como as proteções que mantêm o risco sob controle, mas também facilitam o aprendizado, porque só se aprende quando há feedback rápido e consistente. Podemos adotar uma abordagem científica, experimentar e extrair o aprendizado e as melhorias que resultam desses experimentos e do feedback sobre eles.</p><p>É um processo iterativo que leva ao domínio (pela repetição). Ele precisa vir acompanhado de um ambiente em que o aprendizado local se torne global e seja incorporado ao trabalho diário de todas as equipes. Para essa abordagem funcionar e começar a dar resultados, 20% do nosso tempo deve ser reservado para essas atividades de melhoria. Sei como pode ser difícil separar 20% do tempo para iniciativas de melhoria quando resolver problemas urgentes já ocupa o expediente inteiro. Proteger esse tempo de melhoria nos ajuda a pagar a dívida técnica e a evitar que as coisas saiam do controle.</p><h2 id="o-gitlab-e-as-três-maneiras">O GitLab e as Três Maneiras</h2><p>Agora que apresentamos as Três Maneiras do DevOps (maximizar o fluxo da esquerda para a direita, os ciclos de feedback que maximizam o fluxo da direita para a esquerda e um processo de aprendizado contínuo), colocá-las em prática exige algum esforço em ferramentas e processos.</p><p>É hora de trazer o <a href="https://about.gitlab.com/pt-br/" rel="">GitLab</a> para o cenário: a única plataforma DevOps que cobre todo o SDLC. Por que isso é útil? Porque existe uma sinergia quando todas as funcionalidades necessárias estão na mesma plataforma: o resultado é maior do que a soma das partes. Além disso, uma boa ferramenta deixa o foco no trabalho, e não na própria ferramenta, e sobram mais tempo e energia para conduzir a transformação DevOps. Gastar menos dinheiro e menos tempo integrando ferramentas diferentes é o primeiro retorno imediato do investimento.</p><p>Quando o objetivo é maximizar o fluxo da esquerda para a direita, o GitLab facilita esse caminho, da ideia à produção. Por ser uma plataforma construída desde o início como um todo, o trabalho flui sem atrito do planejamento para o commit e o gerenciamento de código-fonte, e daí para o <a href="https://about.gitlab.com/pt-br/blog/getting-started-with-gitlab-understanding-ci-cd/" rel="">CI/CD</a>. Qualquer pessoa envolvida no SDLC pode fazer o seu trabalho na mesma interface. Todas as informações necessárias estão disponíveis sem precisar alternar entre interfaces diferentes, nem pagar o custo mental da troca de contexto que vem com o uso de ferramentas desconectadas.</p><p>O GitLab oferece diferentes mecanismos de controle para garantir que, se algum defeito for introduzido, ele fique isolado e não siga para as etapas seguintes. Trabalhar com feature branches de curta duração, os diferentes controles sobre o merge e as regras de aprovação de merge requests funcionam como portões.</p><p>Com tudo na mesma plataforma, fica mais fácil entender o fluxo de trabalho como um todo. Somado às nossas Value Stream Metrics, isso permite que todos os envolvidos entendam melhor o sistema e encontrem possíveis gargalos e oportunidades de melhoria.</p><h3 id="fluxo-nos-dois-sentidos">Fluxo nos dois sentidos</h3><p>Como vimos, o fluxo em um único sentido, da esquerda para a direita, não basta para entregar produtos de software melhores e mais rápido. Ciclos de feedback rápidos e consistentes são essenciais para bons resultados de negócio. Do ponto de vista de quem desenvolve, os resultados da pipeline de CI trazem um feedback imediato sobre a alteração. Se essa pipeline incluir varreduras de segurança, melhor ainda. O feedback do ponto de vista da segurança garante que não estamos fazendo deploy de código vulnerável e dá ao desenvolvedor a oportunidade de voltar e corrigir o problema na hora. É um feedback muito prático, que também traz uma oportunidade de aprendizado: os relatórios de segurança vêm com informações sobre as vulnerabilidades e, quando possível, com uma possível solução para cada uma. Tudo isso fica disponível sem nenhum trabalho extra para integrar ferramentas diferentes.</p><p>Mudando de perspectiva, quem precisa revisar ou aprovar uma alteração de código tem tudo o que precisa à mão, em um só lugar. É simples incluir outras pessoas na conversa ou fazer uma “@menção”, e elas terão acesso a todo o contexto necessário. A decisão pode ser tomada na hora, com base em um feedback preciso e claro, rastreável até a ideia inicial.</p><h3 id="métricas-importam">Métricas importam</h3><p>Dando mais um passo atrás, temos diferentes métricas (Value Stream, Contribution) no nível do projeto. Essa é uma das vantagens da abordagem de plataforma, e esses insights são muito fáceis de obter e de levar de volta ao processo. No desenvolvimento de software em escala, os gestores mais seniores precisam desse feedback em um nível ainda mais alto e, por isso, as métricas também estão disponíveis para várias equipes, projetos ou departamentos. Todas essas informações são muito valiosas para entender o momento atual, mas também ajudam a orientar e moldar as decisões de negócio. Se a velocidade não é a que o negócio precisa, podemos remover gargalos, melhorar processos ou investir em algumas áreas-chave.</p><p>Com essas duas capacidades estabelecidas, temos uma estrutura para iterar com rapidez e segurança. Experimentar se torna fácil e muito seguro: podemos testar diferentes hipóteses de negócio e ver quais funcionam melhor com os nossos clientes. Isso deve acontecer de forma contínua, porque essa é a base da inovação.</p><h3 id="o-contexto-é-decisivo">O contexto é decisivo</h3><p>Cada experimento realizado e cada problema resolvido se torna um aprendizado valioso, que deve estar acessível a todos na organização. Ter tudo (contexto, ações, resultados, aprendizados) em um só lugar nos permite abrir o trabalho para que todos possam contribuir. Isso exige um ambiente de confiança, em que todos se sintam à vontade para fazer pequenos experimentos que levem a melhorias, e em que essas melhorias possam se espalhar por toda a organização. Com uma ferramenta que simplesmente funciona e oferece tudo o que é necessário sem trabalho extra, você recupera capacidade para melhorar o seu produto, o sistema como um todo ou a sua organização.</p><p>Foi um longo caminho até aqui, com o objetivo de olhar além das comparações imediatas de recursos e do ganho financeiro imediato de substituir várias ferramentas por uma só. Vimos os princípios centrais do DevOps como um mapa para a sua transformação <a href="https://about.gitlab.com/pt-br/topics/single-application/" rel="">DevOps e o GitLab</a> como a ferramenta que a facilita. Melhorar sistemas muito complexos é difícil, e conduzir essa mudança na empresa é um desafio; com uma ferramenta que atende de fato às suas necessidades, sobra foco para desenvolver código e para os esforços de melhoria contínua.</p><p>Espero que este artigo seja útil para todos os envolvidos no SDLC, dos engenheiros que trabalham com o sistema, e dentro dele, todos os dias às lideranças seniores que precisam entregar resultados de negócio.</p>]]></content>
        <author>
            <name>Vlad Budica</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/vlad-budica/</uri>
        </author>
        <published>2026-11-03T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[GitLab Orbit está disponível para todos: agentes mais precisos]]></title>
        <id>https://about.gitlab.com/pt-br/blog/gitlab-orbit-ga/</id>
        <link href="https://about.gitlab.com/pt-br/blog/gitlab-orbit-ga/"/>
        <updated>2026-10-30T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>O custo real de um agente não está só nos tokens que ele consome. Ele está também na revisão que declara o seu código “seguro para merge” depois de olhar o diff, sem saber nada sobre a pipeline. Isso é confiança artificial, não inteligência artificial. Os agentes chutam porque só enxergam o código: não veem a merge request que o alterou pela última vez, a pipeline que o executou, a vulnerabilidade que ele carrega nem as pessoas que o escreveram e revisaram.</p><p>E chutar sai caro. Quem já tentou rodar agentes em um repositório único grande, com dezenas de milhares de arquivos, conhece o roteiro: o agente faz uma iteração atrás da outra e consulta o back-end repetidas vezes em busca das informações de que precisa para concluir a tarefa. Cada ida e volta custa mais tempo e mais tokens. Até que, então, o agente desiste.</p><p>O que limita os agentes não é o modelo. Na verdade, o que limita é o contexto.</p><p>É esse limite que o <a href="https://about.gitlab.com/blog/introducing-gitlab-orbit/" rel="">GitLab Orbit</a> remove. Agora em disponibilidade geral, o Orbit é o grafo de contexto do ciclo de vida do seu software: uma visão viva e consultável de todo o código, das merge requests, dos itens de trabalho, das pipelines, das vulnerabilidades e dos responsáveis, com cada relação atualizada continuamente à medida que as entregas acontecem. Todos os <a href="https://about.gitlab.com/pt-br/blog/redesign-how-your-team-ships-software-with-ai-agents/" rel="">agentes e engenheiros</a> passam a trabalhar a partir de uma única visão conectada do ciclo de vida. Nos testes do GitLab, os agentes conectados ao Orbit precisaram de até 45 vezes menos tentativas repetidas e usaram até 4,5 vezes menos tokens nas mesmas tarefas, com o mesmo modelo.</p><p><img alt="Um único grafo de contexto para toda a sua instância do GitLab" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1793223579/kwn4st4vqqylpf3lhkic.png" title="Um único grafo de contexto para toda a sua instância do GitLab" /></p><h2 id="agentes-com-contexto-acertam-de-primeira">Agentes com contexto acertam de primeira</h2><p>Um agente como o <a href="https://about.gitlab.com/pt-br/blog/claude-code-and-gitlab/" rel="">Claude Code</a>, conectado ao GitLab Orbit por meio do MCP, para de vasculhar arquivos e passa a consultar o grafo. A primeira resposta já chega com o código que de fato chama cada trecho, as alterações recentes e os responsáveis. Assim, os prompts seguintes servem para refinar a resposta, e não para corrigi-la.</p><p>A diferença é mensurável. A Compare the Market, uma das maiores plataformas de comparação de preços do Reino Unido, testou quatro abordagens de contexto para um revisor de código interno com IA, em 79 merge requests reais. O revisor conectado ao GitLab Orbit acertou cerca de 70% dos comentários inline esperados; o RAG ficou em cerca de 58%, resultado pior do que não adicionar contexto nenhum.</p><blockquote><p><em>“O GitLab Orbit nos deu um revisor de código com IA que de fato entende a nossa base de código, e não só o diff que está na frente dele. Comparamos o Orbit com o RAG e com algumas outras abordagens em merge requests reais, e a diferença ficou clara: comentários mais bem posicionados e resumos melhores do que mudou de verdade.”</em></p><p>— Ryan Harvey, Head de Engenharia de IA, Compare the Market</p></blockquote><h2 id="menos-tentativas-menos-tokens">Menos tentativas, menos tokens</h2><p>Uma análise recente de uma importante empresa de pesquisa e consultoria concluiu que, em uma sessão de agente sem disciplina, o custo vem principalmente da retransmissão de um contexto que não mudou de um turno para o outro. Esse <a href="https://about.gitlab.com/pt-br/blog/make-every-ai-credit-count/" rel="">custo com tokens</a> vem da forma como o agente é configurado, e não do modelo em si.</p><p>O GitLab Orbit muda essa configuração. Em vez de recarregar tudo o que pode ser relevante, o agente recebe do grafo uma única resposta delimitada. Nos testes do GitLab, os agentes conectados ao Orbit usaram até 4,5 vezes menos tokens nas mesmas tarefas, com o mesmo modelo: cada turno carrega menos contexto, e menos turnos são gastos com trabalho que nunca chega à produção. Como o grafo é compartilhado, esse custo não se repete a cada agente. Os agentes do GitLab Duo, o Claude Code, o Codex e as suas próprias ferramentas consultam o mesmo grafo; ou seja, o contexto construído para o primeiro agente já está lá para o segundo.</p><h2 id="perguntas-que-antes-ficavam-sem-resposta">Perguntas que antes ficavam sem resposta</h2><p>Desde que o GitLab Orbit entrou em beta, em junho, trabalhamos com parceiros de design que o colocaram à prova em bases de código, incidentes e merge requests reais. A primeira conquista deles quase sempre foi responder a uma pergunta que antes ficava sem resposta.</p><p>Veja algumas dessas perguntas e o que o Orbit devolveu:</p><p><strong>Quais serviços em produção <a href="/blog/find-vulnerability-blast-radius-with-gitlab-orbit/">estão expostos a esta vulnerabilidade</a>?</strong> Uma única consulta retorna os serviços que incluem o componente, as merge requests que o introduziram, os ambientes aos quais ele chegou e as equipes responsáveis por cada um. Um parceiro de design respondeu a uma pergunta sobre cobertura de segurança envolvendo 34 milhões de entidades em sete minutos; pela API, a mesma pergunta teria levado meio dia. Quando uma vulnerabilidade aparece, a equipe de segurança tem um plano de correção completo em menos de uma hora, e não uma lista parcial no fim do dia.</p><p><strong>O que quebra se eu mudar esta informação?</strong> Antes de um push, um desenvolvedor ou o agente dele pode perguntar quais serviços, jobs e ambientes uma alteração afeta, em todos os projetos do grupo, e não só no projeto aberto no editor. Os agentes de revisão levam essa mesma resposta para a merge request, e um comentário de “seguro para merge” passa a refletir o sistema inteiro, e não apenas o diff. Em 79 merge requests reais, o revisor da Compare the Market sinalizou mais problemas reais, nos lugares certos, do que a versão baseada em RAG. Os problemas são detectados na revisão, antes de virarem quedas de serviço.</p><p><strong>Por que este job de CI continua falhando, e onde mais isso acontece?</strong> O GitLab Orbit mostra com que frequência um job falha em todos os projetos que o executam, quais projetos se afastaram da configuração de CI compartilhada e quem são os responsáveis por eles. O que antes era uma thread no Slack perguntando a três equipes “alguém já viu isso?” vira uma única resposta. Uma empresa de serviços financeiros usou esse recurso para rastrear a origem de uma queda do sistema de build até um job de CI que falhava 50% das vezes, um padrão que nenhuma outra ferramenta tinha correlacionado.</p><p><strong>O que depende deste projeto que estamos prestes a migrar?</strong> Todos os serviços, jobs, ambientes e responsáveis dependentes aparecem em um único resultado. Um parceiro de design concluiu uma atualização que envolvia vários repositórios fazendo a pergunta diretamente: quais projetos ainda estão na versão antiga? Os últimos retardatários apareceram em uma única consulta, sem planilha e sem auditoria repositório por repositório.</p><figure className="video_container">
  <iframe src="https://player.vimeo.com/video/1240405376?badge=0&amp;autopause=0&amp;player_id=0&amp;app_id=58479" frameBorder="0" allow="autoplay; fullscreen; picture-in-picture; clipboard-write; encrypted-media; web-share" referrerPolicy="strict-origin-when-cross-origin" style="position:absolute;top:0;left:0;width:100%;height:100%;" title="Orbit GA V1"></iframe></figure><h2 id="nem-todo-grafo-de-contexto-consegue-responder">Nem todo grafo de contexto consegue responder</h2><p>Os grafos de contexto estão se tornando uma categoria, e a maioria deles para no código. O GitLab conecta a alteração no código à <a href="https://about.gitlab.com/pt-br/topics/ci-cd/cicd-pipeline/" rel="">pipeline</a>, ao deploy, à vulnerabilidade e ao responsável, com as suas permissões preservadas. Com isso, a sua equipe e os seus agentes podem:</p><ul><li><strong>Começar com um grafo que já existe.</strong> O GitLab Orbit se baseia nos dados que já estão no GitLab: não há conector para configurar, nenhuma pipeline de ETL para manter, nem um segundo sistema de registro para sincronizar. Basta ativá-lo em um grupo, e o grafo está pronto. Um grafo montado de fora leva meses de trabalho de integração até responder à primeira pergunta. O Orbit também foi criado para se estender a fontes de dados externas ao GitLab.</li><li><strong>Indexar todo o ciclo de vida.</strong> O GitLab é o sistema de registro de todo o ciclo de vida de desenvolvimento de software, e o GitLab Orbit conecta tudo isso em um único grafo. Índices de código param no código. Grafos de trabalho param no ticket.</li><li><strong>Manter as permissões sem reconstruí-las.</strong> O GitLab Orbit espelha grupos aninhados, funções e o acesso por domínio de segurança. Um grafo que fica fora do GitLab precisa reconstruir tudo isso e mantê-lo sincronizado.</li><li><strong>Dar a todos os agentes e engenheiros o mesmo grafo.</strong> Os agentes do GitLab Duo, o Claude Code, o Codex, as ferramentas personalizadas e o Data Explorer consultam o mesmo grafo, da mesma forma. O investimento em contexto é feito uma vez, e cada novo agente sai mais barato que o anterior.</li></ul><h2 id="traga-os-agentes-que-você-já-usa">Traga os agentes que você já usa</h2><p>O GitLab Orbit não pede que a sua equipe mude a forma de trabalhar. Os agentes e as ferramentas que vocês já usam se conectam a um único grafo:</p><ul><li>Os agentes da GitLab Duo Agent Platform consultam o GitLab Orbit nativamente, sem nada para configurar.</li><li>O Claude Code, o Codex, o Cursor, o OpenCode, o Gemini CLI, o Antigravity e qualquer outro agente compatível com MCP se conectam por meio do MCP ou da CLI do GitLab:</li></ul><pre className="language-text" code="glab auth login
glab orbit setup
" language="text"><code>glab auth login
glab orbit setup
</code></pre><ul><li>Agentes personalizados e ferramentas internas se conectam pela API REST.</li><li>Os engenheiros consultam o mesmo grafo pelo Data Explorer.</li></ul><p>Todas as formas de acesso consultam o mesmo grafo da mesma maneira, e o grafo acompanha o ritmo. O GitLab Orbit indexa cada push, merge e deploy no momento em que acontecem, para que os agentes raciocinem a partir do estado mais atual do ciclo de vida. Na escala do GitLab, isso significa mais de 1,5 milhão de projetos e 8 TB de dados do grafo em menos de 2 horas. A indexação roda como um serviço próprio, ao lado do GitLab; por mais que os agentes usem o Orbit, o próprio GitLab nunca fica mais lento.</p><h2 id="preços-um-pool-compartilhado-de-consultas-para-toda-a-organização">Preços: um pool compartilhado de consultas para toda a organização</h2><p>O GitLab Orbit é vendido em pacotes de consultas que formam um único pool compartilhado, dimensionado para a sua organização. Todos na organização do GitLab usam esse pool, pessoas e agentes, e o uso se distribui entre quem usa de vez em quando, quem usa intensamente e os agentes que trabalham em nome dessas pessoas. Ninguém precisa pedir acesso nem receber uma licença. Uma consulta é uma requisição ao grafo do Orbit, venha ela de um agente (como a Duo Agent Platform, o Claude Code ou o Cursor), de um recurso integrado ao GitLab ou da API.</p><p>Cada pacote de consultas custa US$ 30 em GitLab Credits por usuário por mês e adiciona 1.000 consultas ao pool compartilhado da organização. O uso além do pool é cobrado à razão de 33 consultas por GitLab Credit, cerca de US$ 0,03 por consulta. Há preços promocionais neste trimestre para os primeiros clientes. Fale com a nossa equipe de contas para saber mais e dimensionar o número certo de pacotes de consultas para a sua organização.</p><h2 id="primeiros-passos-com-o-gitlab-orbit">Primeiros passos com o GitLab Orbit</h2><p>O GitLab Orbit já está em disponibilidade geral para clientes Premium e Ultimate, começando pelo GitLab.com, onde já está disponível, e chegando ao Self-Managed e ao GitLab Dedicated nas próximas semanas. Os clientes podem experimentá-lo gratuitamente por 30 dias por meio da equipe de contas do GitLab. Se você ainda não usa o GitLab, <a href="https://about.gitlab.com/pt-br/sales/?contact-topic=request-demo" rel="">fale com a nossa equipe de vendas</a> para começar com um plano pago do GitLab, e podemos ajudar a incluir uma avaliação do Orbit.</p><p>Confira a nossa <a href="https://docs.gitlab.com/orbit/remote/" rel="">documentação</a> (em inglês) para dar os primeiros passos.
Agradecemos aos nossos parceiros de design e aos participantes do beta, cujo feedback franco, vindo de bases de código reais, ajudou a moldar este lançamento em disponibilidade geral.</p><p><em>Este post contém “declarações prospectivas” (forward-looking statements) nos termos da Seção 27A do Securities Act de 1933, conforme alterado, e da Seção 21E do Securities Exchange Act de 1934. Embora acreditemos que as expectativas refletidas nessas declarações sejam razoáveis, elas estão sujeitas a riscos conhecidos e desconhecidos, incertezas, premissas e outros fatores que podem fazer com que os resultados reais sejam significativamente diferentes. Mais informações sobre esses riscos e outros fatores estão disponíveis na seção “Risk Factors” dos nossos relatórios arquivados na SEC. Não assumimos nenhuma obrigação de atualizar ou revisar essas declarações após a data deste post, exceto quando exigido por lei.</em></p>]]></content>
        <author>
            <name>Corinne Dent</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/corinne-dent/</uri>
        </author>
        <author>
            <name>Angelo Rivera</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/angelo-rivera/</uri>
        </author>
        <author>
            <name>Gabriel Engel</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/gabriel-engel/</uri>
        </author>
        <published>2026-10-30T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[CVE-2026-112900 no Pillow: como encontrar e corrigir com o GitLab]]></title>
        <id>https://about.gitlab.com/pt-br/blog/pillow-cve-find-and-fix-with-gitlab/</id>
        <link href="https://about.gitlab.com/pt-br/blog/pillow-cve-find-and-fix-with-gitlab/"/>
        <updated>2026-10-27T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<blockquote><p><strong>O GitLab não é afetado pelo CVE-2026-112900 nem pelas outras vulnerabilidades corrigidas no Pillow 13.0.0. Os produtos do GitLab não incluem a biblioteca Pillow, e nossa equipe de segurança não encontrou nenhum indício de impacto na infraestrutura gerenciada pelo GitLab. O GitLab.com, o GitLab Self-Managed e o GitLab Dedicated não foram impactados.</strong></p></blockquote><p>O Pillow é uma das bibliotecas de imagem mais usadas no ecossistema Python. Muitas vezes, ele fica várias camadas abaixo na árvore de dependências, trazido por um framework web, um serviço de geração de miniaturas ou um toolkit de machine learning, sem que ninguém o tenha escolhido diretamente. Em 16 de outubro de 2026, o projeto Pillow lançou a <a href="https://pillow.readthedocs.io/en/stable/releasenotes/13.0.0.html" rel="">versão 13.0.0</a>, e uma das correções de segurança dessa versão é o <a href="https://www.cve.org/CVERecord?id=CVE-2026-112900" rel="">CVE-2026-112900</a>: uma injeção de argumentos na forma como o Pillow chama o Ghostscript para renderizar imagens EPS. O registro do CVE, publicado em 19 de outubro, atribui a ele a nota 9,2 (Critical) no CVSS 4.0. A falha afeta todas as versões do Pillow a partir da 2.6.0 e anteriores à 13.0.0. Até agora, não há relatos de exploração em ambiente real, mas a avaliação da CISA classifica a falha como automatizável e com impacto técnico total.</p><p><strong>Atualize o Pillow para a versão 13.0.0 em todos os projetos e imagens de contêiner que processam imagens não confiáveis e remova o Ghostscript das imagens de contêiner que não precisam de suporte a EPS.</strong></p><p><strong>Este guia é para equipes de segurança e de plataforma com projetos Python no GitLab.</strong> Ele mostra a versão corrigida para cada distribuição, como a falha funciona, os outros problemas de severidade alta e crítica corrigidos na mesma versão, como localizar os projetos afetados com o <a href="https://docs.gitlab.com/user/application_security/dependency_scanning/dependency_scanning_sbom/" rel="">Dependency Scanning</a>, o <a href="https://docs.gitlab.com/user/application_security/container_scanning/" rel="">Container Scanning</a>, o <a href="https://docs.gitlab.com/orbit/" rel="">GitLab Orbit</a> e a <a href="https://docs.gitlab.com/user/search/exact_code_search/" rel="">busca de código</a>, e como fazer a correção em escala com a <a href="https://docs.gitlab.com/user/duo_agent_platform/" rel="">GitLab Duo Agent Platform</a>.</p><h2 id="cve-2026-112900-visão-resumida">CVE-2026-112900: visão resumida</h2><p>O CVE-2026-112900 é uma falha de injeção de argumentos e de comandos do sistema operacional no plugin EPS do Pillow, classificada como Critical (nota 9,2 no CVSS 4.0) pela CVE Numbering Authority (CNA). O <a href="https://www.cve.org/CVERecord?id=CVE-2026-112900" rel="">registro do CVE</a> foi publicado em 19 de outubro de 2026.</p><table><thead><tr><th align="left">Campo</th><th align="left">Detalhe</th></tr></thead><tbody><tr><td align="left">CVE</td><td align="left">CVE-2026-112900</td></tr><tr><td align="left">Boletim de segurança do GitHub</td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-w889-685w-c8fh" rel="">GHSA-w889-685w-c8fh</a></td></tr><tr><td align="left">Título</td><td align="left">Pillow: Argument Injection in Ghostscript call, potentially leading into RCE</td></tr><tr><td align="left">Tipos de Fraqueza</td><td align="left">CWE-88 (injeção de argumentos), CWE-78 (injeção de comandos do sistema operacional)</td></tr><tr><td align="left">CVSS 4.0</td><td align="left">9,2 Critical (AV:N/AC:L/AT:P/PR:N/UI:N/VC:H/VI:H/VA:H)</td></tr><tr><td align="left">Versões afetadas</td><td align="left">Pillow &gt;= 2.6.0 e &lt; 13.0.0</td></tr><tr><td align="left">Corrigido em</td><td align="left">Pillow 13.0.0</td></tr><tr><td align="left">Status de exploração</td><td align="left">Nenhuma exploração conhecida até a publicação deste artigo (<a href="https://www.cve.org/CVERecord?id=CVE-2026-112900" rel="">avaliação SSVC da CISA</a> de 20 de outubro de 2026)</td></tr></tbody></table><h2 id="atualize-o-pillow-para-uma-versão-corrigida-agora">Atualize o Pillow para uma versão corrigida agora</h2><p>Atualize o Pillow para a versão 13.0.0 ou posterior. O registro do CVE indica a 13.0.0 como a única versão corrigida, então todas as linhas de versão anteriores precisam migrar para ela. Atualizar frameworks ou validar o conteúdo das imagens não resolve neste caso, porque a falha está na forma como o nome do arquivo chega ao Ghostscript.</p><table><thead><tr><th align="left">Sua versão do Python</th><th align="left">O que fazer</th></tr></thead><tbody><tr><td align="left">3.11 a 3.15</td><td align="left">Atualize com <code>pip install --upgrade &quot;pillow&gt;=13.0.0&quot;</code> ou eleve a versão fixada no seu lockfile ou arquivo de requirements.</td></tr></tbody></table><br /><p><strong>Se o Pillow vem de um pacote da distribuição, consulte primeiro o tracker de segurança da distribuição.</strong> Os pacotes de distribuição têm numeração de versão própria, então a comparação deve ser feita com o tracker, e não com o <code>pip show</code>. Status em 26 de outubro de 2026:</p><table><thead><tr><th align="left">Distribuição</th><th align="left">Versão do pacote do Pillow</th><th align="left">Status</th></tr></thead><tbody><tr><td align="left"><a href="https://security-tracker.debian.org/tracker/CVE-2026-112900" rel="">Debian 12 (bookworm)</a></td><td align="left">9.4.0-1.1+deb12u1</td><td align="left">Vulnerável, ainda sem correção</td></tr><tr><td align="left"><a href="https://security-tracker.debian.org/tracker/CVE-2026-112900" rel="">Debian 13 (trixie)</a></td><td align="left">11.1.0-5+deb13u4</td><td align="left">Vulnerável, ainda sem correção</td></tr><tr><td align="left"><a href="https://security-tracker.debian.org/tracker/CVE-2026-112900" rel="">Debian forky (testing)</a></td><td align="left">12.3.0-1</td><td align="left">Vulnerável, ainda sem correção</td></tr><tr><td align="left"><a href="https://security-tracker.debian.org/tracker/CVE-2026-112900" rel="">Debian sid (unstable)</a></td><td align="left">13.0.0-1</td><td align="left">Corrigido</td></tr><tr><td align="left"><a href="https://www.suse.com/security/cve/CVE-2026-112900.html" rel="">SUSE Linux Enterprise (Server 15 SP4 a SP7 e 16.0 a 16.2, entre outros) e openSUSE Leap 16.0 e 16.1</a></td><td align="left">python-Pillow</td><td align="left">Afetado, sem correção listada</td></tr><tr><td align="left"><a href="https://explore.alas.aws.amazon.com/CVE-2026-112900.html" rel="">Amazon Linux 2023 e 2027 Preview</a></td><td align="left">python-pillow</td><td align="left">Correção pendente</td></tr></tbody></table><br /><p><em>Fontes: trackers de segurança do <a href="https://security-tracker.debian.org/tracker/CVE-2026-112900" rel="">Debian</a>, da <a href="https://www.suse.com/security/cve/CVE-2026-112900.html" rel="">SUSE</a> e do <a href="https://explore.alas.aws.amazon.com/CVE-2026-112900.html" rel="">Amazon Linux</a>, em 26 de outubro de 2026. O Amazon Linux 2 aparece como não afetado. O Ubuntu indica que todas as versões precisam de avaliação, e Red Hat, Arch Linux e Oracle Linux não tinham registro deste CVE. Não foi possível consultar o tracker do Alpine.</em></p><p>Enquanto a distribuição não disponibilizar uma correção, instale o Pillow 13.0.0 a partir do PyPI em um ambiente virtual ou em um contêiner, ou aplique as soluções alternativas descritas abaixo.</p><p><strong>Reconstrua suas imagens de contêiner.</strong> Se o Dockerfile instala o Pillow sem fixar uma versão de patch, reconstrua a imagem com <code>docker build --pull --no-cache</code> e faça o deploy novamente, para que a etapa de instalação resolva a versão corrigida. Imagens que fixam uma versão, como <code>pillow==12.3.0</code>, precisam ter essa versão alterada antes. Imagens construídas a partir de outras imagens base só recebem a correção quando os mantenedores dessas imagens as atualizam, então verifique a imagem upstream antes de reconstruir.</p><p>O Pillow 13.0.0 também muda alguns comportamentos, como o tratamento de tags TIFF duplicadas e a forma como imagens no modo I são salvas em PNG. Por isso, rode os testes de processamento de imagens antes de levar a atualização para produção.</p><h2 id="como-a-vulnerabilidade-funciona">Como a vulnerabilidade funciona</h2><p>Arquivos EPS são programas PostScript, então o Pillow chama o Ghostscript (<code>gs</code>) como processo externo para renderizá-los e passa o nome do arquivo de entrada logo depois de <code>-f</code>, sem nenhuma sanitização.</p><p>Quando o objeto de imagem tinha um <code>.name</code> existente em disco, o Pillow usava esse nome sem alterações. O parser de argumentos do Ghostscript dá significado especial a dois tipos de string:</p><ul><li><strong>Um <code>-</code> no início</strong> é lido como opção, e não como nome de arquivo, o que permite ao atacante injetar argumentos (CWE-88).</li><li><strong>Um <code>@</code> no início</strong> faz o Ghostscript ler mais argumentos de linha de comando a partir do arquivo de texto indicado. Se o atacante também controlar o conteúdo desse arquivo, ele passa a controlar argumentos adicionais do Ghostscript, e esse é o caminho para a execução de comandos (CWE-78).</li></ul><p>O relatório de segurança observa que isso funciona mesmo com <code>-dSAFER</code>, a flag de sandbox que o Pillow passa por padrão. Essa flag restringe o que um programa PostScript pode fazer, mas não impede que o atacante injete argumentos na própria linha de comando.</p><h2 id="como-verificar-se-há-exposição">Como verificar se há exposição</h2><p>A exposição só existe quando todas as condições abaixo são verdadeiras:</p><ol><li>O Pillow está em uma versão anterior à 13.0.0.</li><li>O Ghostscript está instalado.</li><li>O código abre um arquivo EPS por um nome de arquivo que um atacante pode influenciar, como um upload salvo com o nome original.</li><li>A imagem é carregada ou renderizada, e não apenas aberta.</li></ol><p>A execução completa de comandos também exige que o atacante controle um arquivo de texto referenciado com <code>@</code> no início. Serviços que geram os próprios nomes de arquivo ou usam streams em memória têm muito menos chance de ficar ao alcance de um atacante.</p><p><strong>Se ainda não for possível atualizar:</strong> salve os uploads com nomes gerados, restrinja os formatos com <code>Image.open(f, formats=[&quot;PNG&quot;, &quot;JPEG&quot;])</code> ou remova o Ghostscript das imagens de contêiner que não precisam dele.</p><h2 id="não-é-só-uma-falha-todos-os-problemas-high-e-critical-da-1300">Não é só uma falha: todos os problemas High e Critical da 13.0.0</h2><p>As <a href="https://pillow.readthedocs.io/en/stable/releasenotes/13.0.0.html" rel="">notas de versão da 13.0.0</a> listam 17 recomendações High e Critical (sendo 3 críticas e 14 altas). Quinze deles têm um CVE associado. Os dois que não têm, GHSA-xcvg-w56q-r89m e GHSA-78g4-xqwv-q3g8, merecem atenção, porque ferramentas que fazem a correspondência apenas pelo ID do CVE deixariam esses dois passar.</p><table><thead><tr><th align="left">Severidade</th><th align="left">CVE</th><th align="left">GHSA</th><th align="left">Problema</th></tr></thead><tbody><tr><td align="left">Critical</td><td align="left"><a href="https://www.cve.org/CVERecord?id=CVE-2026-96639" rel="">CVE-2026-96639</a></td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-v9pv-5gc8-w2m6" rel="">GHSA-v9pv-5gc8-w2m6</a></td><td align="left">Armazenamento nativo de imagem obsoleto reutilizado após transições de modo</td></tr><tr><td align="left">Critical</td><td align="left"><a href="https://www.cve.org/CVERecord?id=CVE-2026-112398" rel="">CVE-2026-112398</a></td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-5x8w-8jj5-q52h" rel="">GHSA-5x8w-8jj5-q52h</a></td><td align="left">Heap buffer overflow na decodificação JPEG do FlashPix (FPX)</td></tr><tr><td align="left">Critical</td><td align="left"><a href="https://www.cve.org/CVERecord?id=CVE-2026-112403" rel="">CVE-2026-112403</a></td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-8g5g-8vmr-9782" rel="">GHSA-8g5g-8vmr-9782</a></td><td align="left">Heap buffer overflow na decodificação JPEG causado por scanlines mais largas que os limites do tile</td></tr><tr><td align="left">High</td><td align="left"><a href="https://www.cve.org/CVERecord?id=CVE-2026-96644" rel="">CVE-2026-96644</a></td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-9v9v-9qvf-h2hj" rel="">GHSA-9v9v-9qvf-h2hj</a></td><td align="left">Leitura fora dos limites (out-of-bounds read) no heap em WMF/EMF causada por truncamento de dimensões</td></tr><tr><td align="left">High</td><td align="left"><a href="https://www.cve.org/CVERecord?id=CVE-2026-96637" rel="">CVE-2026-96637</a></td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-g842-9rc4-69pw" rel="">GHSA-g842-9rc4-69pw</a></td><td align="left">Contorno da proteção contra bombas de descompressão no SPIDER via <code>seek()</code></td></tr><tr><td align="left">High</td><td align="left"><a href="https://www.cve.org/CVERecord?id=CVE-2026-96643" rel="">CVE-2026-96643</a></td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-g4qv-2jxx-769h" rel="">GHSA-g4qv-2jxx-769h</a></td><td align="left">Loop ilimitado de substituição de cabeçalho Exif</td></tr><tr><td align="left">High</td><td align="left"><a href="https://www.cve.org/CVERecord?id=CVE-2026-96778" rel="">CVE-2026-96778</a></td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-g7cr-3p24-7wf7" rel="">GHSA-g7cr-3p24-7wf7</a></td><td align="left">Gravação de comentário JPEG depois que o perfil ICC preenche o buffer do encoder</td></tr><tr><td align="left">High</td><td align="left"><a href="https://www.cve.org/CVERecord?id=CVE-2026-112395" rel="">CVE-2026-112395</a></td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-462x-pgg6-55fp" rel="">GHSA-462x-pgg6-55fp</a></td><td align="left">Leitura fora dos limites na decodificação de tiles TIFF e YCbCr causada por buffers subdimensionados da libtiff</td></tr><tr><td align="left">High</td><td align="left"><a href="https://www.cve.org/CVERecord?id=CVE-2026-112404" rel="">CVE-2026-112404</a></td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-c6hw-5grf-ff96" rel="">GHSA-c6hw-5grf-ff96</a></td><td align="left">Leitura fora dos limites na decodificação de tiles TIFF e YCbCr causada por buffers subdimensionados da libtiff</td></tr><tr><td align="left">High</td><td align="left"><a href="https://www.cve.org/CVERecord?id=CVE-2026-112895" rel="">CVE-2026-112895</a></td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-p4wg-p73j-c528" rel="">GHSA-p4wg-p73j-c528</a></td><td align="left">Esgotamento da pilha no parsing de PDF causado por cadeias longas de trailers e árvores de páginas profundas ou cíclicas</td></tr><tr><td align="left">High</td><td align="left"><a href="https://www.cve.org/CVERecord?id=CVE-2026-96640" rel="">CVE-2026-96640</a></td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-mrfp-p49p-3hf2" rel="">GHSA-mrfp-p49p-3hf2</a></td><td align="left">Esgotamento de recursos ao anexar PDF causado por referências repetidas à árvore de páginas</td></tr><tr><td align="left">High</td><td align="left"><a href="https://www.cve.org/CVERecord?id=CVE-2026-112896" rel="">CVE-2026-112896</a></td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-pchr-8j38-3x4p" rel="">GHSA-pchr-8j38-3x4p</a></td><td align="left">O encoder TIFF aceitava um Colormap de tamanho incorreto em imagens que não são de 8 bits</td></tr><tr><td align="left">High</td><td align="left"><a href="https://www.cve.org/CVERecord?id=CVE-2026-112393" rel="">CVE-2026-112393</a></td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-332p-7hrc-92wf" rel="">GHSA-332p-7hrc-92wf</a></td><td align="left">Heap buffer overflow no encoder TIFF ao salvar em um objeto de arquivo</td></tr><tr><td align="left">High</td><td align="left">Nenhum CVE encontrado ainda</td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-xcvg-w56q-r89m" rel="">GHSA-xcvg-w56q-r89m</a></td><td align="left">Heap buffer overflow no encoder TIFF quando tags sobrescrevem o tamanho da imagem</td></tr><tr><td align="left">High</td><td align="left"><a href="https://www.cve.org/CVERecord?id=CVE-2026-112902" rel="">CVE-2026-112902</a></td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-xvh5-g6gv-559v" rel="">GHSA-xvh5-g6gv-559v</a></td><td align="left">Exposição de memória e travamento no encoder TIFF causados por valores de tag incompatíveis</td></tr><tr><td align="left">High</td><td align="left"><a href="https://www.cve.org/CVERecord?id=CVE-2026-112897" rel="">CVE-2026-112897</a></td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-q45j-58j2-45rg" rel="">GHSA-q45j-58j2-45rg</a></td><td align="left">A decodificação TIFF retornava memória não inicializada para strips JPEG curtas</td></tr><tr><td align="left">High</td><td align="left">Sem CVE (GitHub: &quot;No known CVE&quot;)</td><td align="left"><a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-78g4-xqwv-q3g8" rel="">GHSA-78g4-xqwv-q3g8</a></td><td align="left">Heap buffer overflow no OpenJPEG embutido no pacote ao ler dados de tile-part</td></tr></tbody></table><h2 id="localize-o-pillow-em-todos-os-seus-grupos-do-gitlab">Localize o Pillow em todos os seus grupos do GitLab</h2><p>Encontre todos os projetos que instalam o Pillow e corrija primeiro os que também têm o Ghostscript e aceitam uploads.</p><ol><li><strong>O Dependency Scanning</strong> informa a versão do Pillow nos seus lockfiles, incluindo dependências transitivas. <a href="https://docs.gitlab.com/user/application_security/dependency_scanning/dependency_scanning_sbom/" rel="">Ative o recurso</a> por projeto ou para um grupo inteiro com uma <a href="https://docs.gitlab.com/user/application_security/policies/scan_execution_policies/" rel="">política de execução de varredura</a>. As <a href="https://docs.gitlab.com/user/application_security/policies/merge_request_approval_policies/" rel="">políticas para aprovação de merge requests</a> podem bloquear merges que adicionem uma versão vulnerável, e o <a href="https://docs.gitlab.com/user/application_security/dependency_scanning/continuous_dependency_scanning/" rel="">Continuous Vulnerability Scanning</a> verifica de novo os projetos existentes quando um boletim de segurança é publicado, para boletins com até 14 dias. Todos os recursos desta etapa estão disponíveis no plano Ultimate.</li></ol><p><img alt="Vulnerability Report do GitLab simulado, com achados do Dependency Scanning para CVEs Critical e High do Pillow" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1793049447/qw4yuepojec1q89qkas4.png" title="Figura 1: Vulnerability Report do GitLab simulado, com achados do Dependency Scanning para CVEs Critical e High do Pillow" /></p><ol start="2"><li><strong>O Container Scanning</strong> encontra o Ghostscript instalado como pacote do sistema operacional. Imagens de contêiner com o Pillow, mas sem o Ghostscript, não conseguem renderizar arquivos EPS e, por isso, têm prioridade menor. O Container Scanning não detecta o Ghostscript compilado a partir do código-fonte. <a href="https://docs.gitlab.com/user/application_security/container_scanning/" rel="">Ative o Container Scanning</a> da mesma forma.</li><li><strong>GitLab Orbit</strong>: como o Pillow costuma chegar como dependência de outro pacote, é difícil responder &quot;quem usa?&quot; olhando para um projeto de cada vez. O <a href="https://docs.gitlab.com/orbit/" rel="">GitLab Orbit</a> transforma seus projetos, pipelines, achados de segurança e código em um grafo que um agente pode consultar. Ative o Orbit no grupo de nível superior e peça os projetos Python que lidam com imagens e os projetos com achados abertos para o CVE-2026-112900 ou para os outros boletins do Pillow. Com isso, a lista de candidatos fica pronta antes mesmo de abrir qualquer repositório.<br />O Orbit cobre apenas a branch padrão e está em beta para os planos Premium e Ultimate no GitLab.com e no GitLab Self-Managed. Ele ainda não analisa Dockerfiles, então confirme a presença do Ghostscript com a busca de código da próxima etapa.</li><li><strong>A busca de código</strong> encontra o que os scanners deixam passar. Execute estas buscas na <a href="https://docs.gitlab.com/user/search/exact_code_search/" rel="">busca exata de código</a> (Premium e Ultimate) no grupo de nível superior, com o modo de expressão regular ativado:<ul><li><code>file:requirements.*\.txt$ (?i)^\s*pillow</code></li><li><code>lang:Dockerfile (?i)ghostscript</code></li><li><code>(?i)EpsImagePlugin|\.eps\b</code></li></ul></li></ol><p>Por fim, compare os resultados com o que de fato está em execução. Tudo o que está rodando e não aparece declarado nos seus projetos é uma lacuna. No Kubernetes, o <a href="https://docs.gitlab.com/user/clusters/agent/vulnerabilities/" rel="">Operational Container Scanning</a> (Ultimate) cobre as imagens de contêiner dos seus clusters.</p><h2 id="corrija-em-escala-com-a-gitlab-duo-agent-platform">Corrija em escala com a GitLab Duo Agent Platform</h2><p>A GitLab Duo Agent Platform está disponível nos planos Premium e Ultimate. Com a lista de projetos afetados em mãos, o trabalho restante é repetitivo: elevar uma versão, abrir uma merge request, conseguir a revisão. Deixe a parte repetitiva com os agentes e mantenha as pessoas nas decisões.</p><p>Comece pelo <a href="https://docs.gitlab.com/user/gitlab_duo_chat/agentic_chat/" rel="">Agentic Chat</a> e peça que ele liste os achados do Dependency Scanning para esses CVEs do Pillow no Vulnerability Report (Ultimate) e, em seguida, crie um épico com uma issue para cada projeto afetado. Atribuir uma issue ao <a href="https://docs.gitlab.com/user/project/merge_requests/developer/" rel="">Developer Flow</a> gera uma merge request que eleva o Pillow para a 13.0.0 ou posterior, ou que altera a versão fixada no Dockerfile. Um <a href="https://docs.gitlab.com/user/duo_agent_platform/triggers/" rel="">gatilho de flow</a> no evento <code>Assign</code> inicia o flow assim que a issue é atribuída. Depois, o <a href="https://docs.gitlab.com/user/duo_agent_platform/flows/foundational_flows/code_review/#automatic-reviews" rel="">Code Review Flow</a> pode fazer uma primeira revisão de cada merge request com base nas suas <a href="https://docs.gitlab.com/user/duo_agent_platform/customize/review_instructions/" rel="">instruções de revisão</a>. O gatilho de flow e as instruções de revisão exigem os planos Premium ou Ultimate. O Agentic Chat, o Developer Flow e o Code Review Flow também estão disponíveis no plano Free, com GitLab Credits.</p><p><img alt="Duo Agent Chat fazendo a varredura de segurança e criando merge requests para corrigir as vulnerabilidades do Pillow" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1793049537/cckpgdrshihzaafi9z3h.jpg" title="Figura 2: Duo Agent Chat fazendo a varredura de segurança e criando merge requests para corrigir as vulnerabilidades do Pillow" /></p><p><img alt="Merge request criada pela GitLab Duo Agent Platform para corrigir as vulnerabilidades do Pillow" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1793049569/doqe0e0qrdox9buwlbjp.png" title="Figura 3: Merge request criada pela GitLab Duo Agent Platform para corrigir as vulnerabilidades do Pillow" /></p><p>Os agentes param na merge request. Uma pessoa ainda precisa revisar e fazer o merge de cada uma. Também é preciso rodar os testes de processamento de imagens, porque a 13.0.0 muda o comportamento das tags TIFF duplicadas e do salvamento em PNG no modo I, e confirmar que foi feito o deploy da versão corrigida antes de fechar a issue.</p><h2 id="linha-do-tempo">Linha do tempo</h2><table><thead><tr><th align="left">Data</th><th align="left">O que aconteceu</th></tr></thead><tbody><tr><td align="left">16 de outubro</td><td align="left">O projeto Pillow lança a <a href="https://pillow.readthedocs.io/en/stable/releasenotes/13.0.0.html" rel="">13.0.0</a> com correções para 38 itens de segurança. As notas de versão listam o problema do EPS com o Ghostscript como GHSA-w889-685w-c8fh, ainda sem CVE.</td></tr><tr><td align="left">19 de outubro</td><td align="left">O GitHub, como CNA, reserva e publica o <a href="https://www.cve.org/CVERecord?id=CVE-2026-112900" rel="">CVE-2026-112900</a> com nota 9,2 (Critical) no CVSS 4.0. O CVE-2026-112393 e o CVE-2026-112403, os heap buffer overflows do encoder TIFF e do decoder JPEG, são publicados no mesmo dia.</td></tr><tr><td align="left">20 de outubro</td><td align="left">O coordenador da CISA adiciona uma avaliação SSVC para o CVE-2026-112900: exploração, nenhuma; automatizável, sim; impacto técnico, total.</td></tr><tr><td align="left">23 de outubro</td><td align="left">O Debian indica apenas a versão unstable (13.0.0-1) como corrigida. O Ubuntu indica que todas as versões precisam de avaliação.</td></tr></tbody></table><h2 id="fontes">Fontes</h2><ul><li><a href="https://pillow.readthedocs.io/en/stable/releasenotes/13.0.0.html" rel="">Notas de versão do Pillow 13.0.0</a></li><li><a href="https://www.cve.org/CVERecord?id=CVE-2026-112900" rel="">Registro do CVE-2026-112900</a> e <a href="https://github.com/python-pillow/Pillow/security/advisories/GHSA-w889-685w-c8fh" rel="">GHSA-w889-685w-c8fh</a></li><li><a href="https://github.com/python-pillow/Pillow/commit/a2c363141da31a265dd536c945677db4b64f3ec9" rel="">Commit da correção a2c3631</a></li><li><a href="https://security-tracker.debian.org/tracker/CVE-2026-112900" rel="">Tracker de segurança do Debian</a> e <a href="https://ubuntu.com/security/CVE-2026-112900" rel="">tracker de segurança do Ubuntu</a>, em 23 de outubro de 2026</li><li><a href="https://docs.gitlab.com/user/application_security/dependency_scanning/dependency_scanning_sbom/" rel="">GitLab: Dependency Scanning com SBOM (lista de materiais de software)</a></li><li><a href="https://docs.gitlab.com/user/application_security/dependency_scanning/continuous_dependency_scanning/" rel="">GitLab: Continuous Dependency Scanning</a></li><li><a href="https://docs.gitlab.com/user/application_security/container_scanning/" rel="">GitLab: Container Scanning</a> e <a href="https://docs.gitlab.com/user/search/exact_code_search/" rel="">busca exata de código</a></li></ul>]]></content>
        <author>
            <name>Abisheik Magesh</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/abisheik-magesh/</uri>
        </author>
        <author>
            <name>Daniel Abeles</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/daniel-abeles/</uri>
        </author>
        <published>2026-10-27T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[PHP2Shell: o GitLab ajuda a encontrar e corrigir falhas críticas no PHP]]></title>
        <id>https://about.gitlab.com/pt-br/blog/gitlab-helps-remediate-critical-php-flaws/</id>
        <link href="https://about.gitlab.com/pt-br/blog/gitlab-helps-remediate-critical-php-flaws/"/>
        <updated>2026-10-23T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<blockquote><p>O GitLab não é afetado pela PHP2Shell (CVE-2026-109618 e CVE-2026-109619). A aplicação do GitLab não é escrita em PHP nem usa PHP para atender a requisições web, e nossa equipe de Segurança não encontrou evidências de impacto na infraestrutura gerenciada pelo GitLab. GitLab.com, GitLab Self-Managed e GitLab Dedicated não foram afetados.</p></blockquote><p>O PHP é uma linguagem de programação amplamente usada, que roda em servidores web e é a base de plataformas populares como WordPress, Drupal e Magento. Por isso, uma falha no próprio PHP pode afetar diversos sites e aplicações. Em 21 de outubro de 2026, o projeto PHP <a href="https://www.php.net/archive/2026.php#2026-10-21-5" rel="">corrigiu duas falhas críticas de execução remota de código</a> no PHP, conhecidas em conjunto como PHP2Shell (<a href="https://www.cve.org/CVERecord?id=CVE-2026-109618" rel="">CVE-2026-109618</a> e <a href="https://www.cve.org/CVERecord?id=CVE-2026-109619" rel="">CVE-2026-109619</a>). O PHP atribui a ambas a nota 9,2 no CVSS v4.0. As falhas estão no núcleo do PHP, e não em algum framework, biblioteca ou código de aplicação; por isso, não há correção no nível da aplicação. Qualquer servidor web que execute PHP é afetado, incluindo NGINX e Apache. O <a href="https://www.php.net/archive/2026.php#2026-10-21-5" rel="">projeto PHP confirmou a vulnerabilidade no Apache</a> com mod_php, em que uma requisição sem autenticação pode chegar à execução remota de código antes mesmo que qualquer código da aplicação seja executado.</p><p>Atualize agora todos os servidores e contêineres que usam PHP para atender a requisições web: a versão deve ser o PHP <a href="https://www.php.net/archive/2026.php#2026-10-21-4" rel="">8.5.12</a>, <a href="https://www.php.net/archive/2026.php#2026-10-21-3" rel="">8.4.27</a>, <a href="https://www.php.net/archive/2026.php#2026-10-21-2" rel="">8.3.36</a> ou <a href="https://www.php.net/archive/2026.php#2026-10-21-1" rel="">8.2.35</a>, ou o pacote corrigido da sua distribuição.</p><p>Este guia é para equipes de segurança e de plataforma com projetos PHP no GitLab. Ele traz a versão corrigida de cada branch do PHP e de cada distribuição, mostra como usar recursos do GitLab para localizar projetos PHP nos seus grupos e acompanhar a correção, além de explicar como verificar sinais de comprometimento.</p><h2 id="atualize-o-php-para-uma-versão-corrigida-agora">Atualize o PHP para uma versão corrigida agora</h2><p>Atualize o PHP em todos os hosts e em todas as imagens de contêiner para uma versão corrigida. Atualizações de framework e do Composer, validação de entrada e autenticação não resolvem, porque o PHP processa a requisição antes que o código da aplicação seja executado.</p><table><thead><tr><th align="left">Branch</th><th align="left">Corrigida em</th></tr></thead><tbody><tr><td align="left">PHP 8.5.x</td><td align="left">8.5.12</td></tr><tr><td align="left">PHP 8.4.x</td><td align="left">8.4.27</td></tr><tr><td align="left">PHP 8.3.x</td><td align="left">8.3.36</td></tr><tr><td align="left">PHP 8.2.x</td><td align="left">8.2.35 (fim do suporte em 31 de dezembro de 2026)</td></tr><tr><td align="left">Release candidates do PHP 8.6</td><td align="left">8.6.0RC4. A imagem oficial php:8.6-rc ainda estava no RC3 em 21 de outubro, e o RC3 não tem a correção.</td></tr><tr><td align="left">PHP 8.1 e anteriores</td><td align="left">Sem versão oficial. O PHP publicou backports mínimos do código-fonte para 7.4, 8.0 e 8.1, e algumas distribuições oferecem pacotes corrigidos.</td></tr></tbody></table><p><strong>Se o seu PHP vem de um pacote da distribuição, atualize esse pacote.</strong> Versões corrigidas dos pacotes em 22 de outubro:</p><table><thead><tr><th align="left">Distribuição</th><th align="left">Pacote corrigido</th></tr></thead><tbody><tr><td align="left">Ubuntu 26.04</td><td align="left">php8.5 8.5.4-0ubuntu1.5</td></tr><tr><td align="left">Ubuntu 24.04</td><td align="left">php8.3 8.3.6-0ubuntu0.24.04.13</td></tr><tr><td align="left">Ubuntu 22.04</td><td align="left">php8.1 8.1.2-1ubuntu2.28</td></tr><tr><td align="left">Debian 13</td><td align="left">php8.4 8.4.27-1~deb13u1</td></tr><tr><td align="left">Debian 12</td><td align="left">php8.2 8.2.35-1~deb12u1</td></tr><tr><td align="left">Alpine 3.24</td><td align="left">php83 8.3.36, php84 8.4.27, php85 8.5.12</td></tr><tr><td align="left">RHEL 10</td><td align="left">php 8.3.36-1.el10_2 (RHSA-2026:87070), php8.4 8.4.27-1.el10_2 (RHSA-2026:87071)</td></tr><tr><td align="left">RHEL 9</td><td align="left">php 8.0.30-8.el9_8.1 (RHSA-2026:87151), php:8.2 8.2.35-1 (RHSA-2026:87072), php:8.3 8.3.36-1 (RHSA-2026:87079); php:8.4 ainda sem correção em 22 de outubro</td></tr><tr><td align="left">RHEL 8</td><td align="left">php:7.4 7.4.33-8 (RHSA-2026:87080); para php:8.2, consulte as páginas de CVE da Red Hat. Streams descontinuados (7.2, 7.3, 8.0) não recebem correção</td></tr></tbody></table><p><em>Fontes: trackers de segurança do <a href="https://ubuntu.com/security/CVE-2026-109618" rel="">Ubuntu</a>, do <a href="https://security-tracker.debian.org/tracker/CVE-2026-109618" rel="">Debian</a>, do Alpine e da <a href="https://access.redhat.com/security/cve/cve-2026-109618" rel="">Red Hat</a>, em 22 de outubro de 2026.</em></p><p>O Ubuntu e os pacotes 7.4 e 8.0do Red Hat mantêm o número de versão original do upstream e fazem o backport da correção. Por isso, compare as versões dos pacotes, e não a saída de <code>php -v</code>. Depois da atualização, reinicie todos os processos que executam PHP.</p><p><strong>Recrie suas imagens de contêiner.</strong> Se a sua imagem usa uma tag flutuante da imagem oficial do php, como php:8, php:8.3, php:8.3-apache ou php:latest, recrie-a com <code>docker build --pull</code> e faça o deploy de novo. Imagens que fixam uma versão de patch, como php:8.3.35-apache, precisam, primeiro, ter a tag alterada para a versão corrigida. Imagens criadas a partir de derivadas, como <code>wordpress</code> ou <code>drupal</code>, só recebem a correção depois que os mantenedores publicam uma imagem atualizada; por isso, verifique a imagem upstream antes de recriar a sua.</p><h2 id="localize-projetos-php-nos-seus-grupos-do-gitlab">Localize projetos PHP nos seus grupos do GitLab</h2><p>Todo projeto que executa PHP para atender a requisições web precisa de uma versão corrigida, inclusive os que podem ser considerados menos relevantes, como um dashboard interno, um site de marketing ou a imagem de um job de CI. Para encontrá-los, são necessárias duas visões: uma busca estática do que os repositórios declaram e as imagens contêm, e um inventário do que de fato está em execução. O GitLab cobre a visão estática com dois recursos. Use os dois, nesta ordem.</p><h3 id="_1-container-scanning">1. Container Scanning</h3><p>O <a href="https://docs.gitlab.com/user/application_security/container_scanning/" rel="">Container Scanning</a> aponta vulnerabilidades em pacotes do sistema operacional. Assim, ele encontra o PHP instalado com apt, apk ou dnf e aponta os dois CVEs assim que eles chegam ao banco de dados de vulnerabilidades do scanner. Para ativá-lo em um projeto, adicione o template ao .gitlab-ci.yml:</p><pre className="language-yaml shiki shiki-themes github-light" code="include:
  - template: Security/Container-Scanning.gitlab-ci.yml
" language="yaml" meta="" style=""><code><span class="line" line="1"><span class="shJU0">include</span><span class="sgsFI">:
</span></span><span class="line" line="2"><span class="sgsFI">  - </span><span class="shJU0">template</span><span class="sgsFI">: </span><span class="sYBdl">Security/Container-Scanning.gitlab-ci.yml
</span></span></code></pre><p>Também é possível usar uma <a href="https://docs.gitlab.com/user/application_security/policies/scan_execution_policies/" rel="">política de execução de varredura</a> no nível do grupo para ativar o Container Scanning em todos os projetos do grupo de uma só vez. Com a política ativada, a próxima pipeline executada já inclui a <a href="https://about.gitlab.com/pt-br/blog/complete-guide-to-gitlab-container-scanning/" rel="">varredura de contêineres</a>. Depois que o scanner termina, os resultados do Container Scanning na branch padrão podem ser revisados no <a href="https://docs.gitlab.com/user/application_security/vulnerability_report/" rel="">Vulnerability Report</a>.</p><p>Além disso, é possível configurar <a href="https://docs.gitlab.com/user/application_security/policies/merge_request_approval_policies/" rel="">políticas para aprovação de merge requests</a> com o Container Scanning. Com essas políticas em vigor, se uma alteração de código introduzir uma versão do PHP vulnerável à PHP2Shell, a política bloqueia o merge até que os aprovadores definidos deem sua aprovação.</p><p>A varredura de contêineres detecta apenas o PHP instalado como pacote. O PHP compilado a partir do código-fonte, incluindo o das imagens oficiais do php, não tem registro de pacote. Ou seja, um projeto pode passar na varredura e ainda assim executar um PHP vulnerável. A busca de código cobre essa lacuna.</p><h3 id="_2-busca-de-código">2. Busca de código</h3><p>A <a href="https://docs.gitlab.com/user/search/exact_code_search/" rel="">busca exata de código</a> consegue encontrar os dois tipos de arquivo que indicam um projeto PHP. Execute as consultas no grupo de nível superior, com o modo de expressão regular ativado (o botão .* à direita da caixa de busca).</p><p><strong>Imagens base de contêiner:</strong> esta consulta procura em todos os arquivos que o GitLab identifica como Dockerfile. O padrão corresponde a qualquer imagem cujo nome ou tag contenha php, então também encontra derivadas como wordpress, frankenphp ou bitnami/php-fpm. Alguns falsos positivos podem aparecer, devendo ser descartados com a leitura do resultado:</p><pre className="language-text" code="lang:Dockerfile ^FROM.*php
" language="text" meta=""><code>lang:Dockerfile ^FROM.*php
</code></pre><p><strong>Projetos Composer:</strong> esta consulta encontra projetos que usam PHP mesmo quando não têm Dockerfile, ou quando o Dockerfile recebe a imagem de um argumento de build, como <code>FROM $BASE_IMAGE</code>:</p><pre className="language-text" code="file:composer\.json$
" language="text" meta=""><code>file:composer\.json$
</code></pre><p>A busca exata de código cobre apenas a branch padrão. No GitLab.com, ela vem ativada por padrão nos planos pagos. Em instâncias do GitLab Self-Managed, um administrador precisa instalar o Zoekt primeiro. O GitLab Dedicated não oferece suporte à busca exata de código.</p><p><strong>Para cada resultado, confirme a versão.</strong> Verifique a linha <code>FROM php:&lt;tag&gt;</code> ou execute <code>php -v</code> no contêiner em execução e compare com a tabela acima. A Dependency List do grupo mostra os pacotes do Composer e as versões dos frameworks, mas não a versão do PHP em si.</p><h3 id="_3-compare-com-o-inventário-do-que-está-em-execução">3. Compare com o inventário do que está em execução</h3><p>A varredura de contêineres e a busca de código mostram o que os projetos declaram e constroem, não o que está em execução. O PHP pode rodar fora dos seus projetos do GitLab: por exemplo, em servidores web com mod_php ou PHP-FPM ativados apenas na configuração, em hosts configurados manualmente ou em contêineres que continuam rodando em clusters sem uma pipeline ativa. Compare os resultados estáticos com um inventário das cargas de trabalho em execução, obtido das ferramentas de gerenciamento de configuração (Ansible, Puppet, Chef etc.), de nuvem ou de inventário de VMs. No Kubernetes, o <a href="https://docs.gitlab.com/user/clusters/agent/vulnerabilities/" rel="">Operational Container Scanning</a> faz a varredura das imagens em execução nos clusters, com a mesma detecção restrita a pacotes do Container Scanning. Trate toda instalação de PHP que aparecer em apenas uma das duas visões como uma lacuna a investigar.</p><h2 id="corrija-em-escala-com-a-gitlab-duo-agent-platform">Corrija em escala com a GitLab Duo Agent Platform</h2><p>Comece pedindo ao <a href="https://docs.gitlab.com/user/gitlab_duo_chat/agentic_chat/" rel="">GitLab Duo Agentic Chat</a> que:</p><ul><li>reúna todos os achados do Container Scanning para o CVE-2026-109618 e o CVE-2026-109619 em todo o grupo, a partir do relatório de vulnerabilidades (requer uma assinatura Ultimate)</li><li>execute as consultas de busca de código acima em todo o grupo, revise cada resultado e leia a versão do PHP no Dockerfile ou nos arquivos do Composer</li><li>abra uma merge request por projeto afetado, atualizando a tag da imagem base ou o pacote para a versão corrigida, e atribua-a ao mantenedor responsável</li><li>acompanhe todo o trabalho em um épico, com uma issue por projeto, encerrada depois do deploy e da confirmação da versão corrigida</li></ul><p>A partir de cada issue, o <a href="https://docs.gitlab.com/user/project/merge_requests/developer/" rel="">Developer Flow</a> pode abrir uma merge request que atualiza a tag da imagem base ou o pacote para uma versão corrigida. Ative as <a href="https://docs.gitlab.com/user/duo_agent_platform/flows/foundational_flows/code_review/#automatic-reviews" rel="">revisões automáticas com o Code Review Flow</a> para receber uma primeira revisão que segue as suas <a href="https://docs.gitlab.com/user/duo_agent_platform/customize/review_instructions/" rel="">instruções de revisão personalizadas</a>. Revise cada merge request, faça o merge e encerre a issue depois do deploy da versão corrigida.</p><p>As buscas encontram candidatos, mas alguém da equipe de segurança ou de plataforma ainda precisa revisar cada resultado, resolver os includes de CI e distinguir o que o código declara do que de fato está em execução. Uma <a href="https://gitlab.com/gitlab-da/demo-environments/tanuki-iot-platform/frontend/php-status-board/-/blob/main/skills/php2shell-inventory/SKILL.md" rel="">skill de agente de exemplo, criada pela equipe de Developer Advocacy do GitLab</a> (em inglês), cuida desse trabalho. Ela funciona na GitLab Duo Agent Platform e com agentes que usam o <a href="https://about.gitlab.com/blog/mcp-server-ga/" rel="">servidor MCP do GitLab</a> ou a CLI glab, como o <a href="https://about.gitlab.com/pt-br/blog/claude-code-and-gitlab/" rel="">Claude Code</a>, o <a href="https://about.gitlab.com/blog/fix-bugs-with-codex-and-gitlab/" rel="">Codex</a> e o <a href="https://about.gitlab.com/blog/modernize-java-with-cursor-and-gitlab/" rel="">Cursor</a>.</p><p>A skill verifica imagens de contêiner, jobs de CI, pacotes do sistema operacional, variáveis de gerenciamento de configuração, versões fixadas no Composer e ambientes. Ela retorna uma tabela de achados com citações e evidências de deploy, além das lacunas em aberto. A skill é somente leitura: não faz alterações, e as merge requests de correção continuam sendo uma etapa separada e revisada. Ela também não consegue confirmar o que está em execução em hosts aos quais não tem acesso; nesses casos, verifique diretamente. Adapte a skill ao seu ambiente antes de usá-la.</p><p><img alt="A GitLab Duo CLI usando a skill PHP2Shell. Este projeto de demonstração é intencionalmente vulnerável, para mostrar uma correção bem-sucedida com a GitLab Duo CLI." src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1792694702/ahsysxh1p9u2rymcxhco.png" title="A GitLab Duo CLI usando a skill PHP2Shell. Este projeto de demonstração é intencionalmente vulnerável, para mostrar uma correção bem-sucedida com a GitLab Duo CLI." /></p><h2 id="verifique-sinais-de-comprometimento">Verifique sinais de comprometimento</h2><p>Os relatos de exploração divergem. Pesquisadores de segurança relataram uma tentativa de exploit em 17 de outubro de 2026, antes da divulgação pública, e novos relatos de exploração surgiram depois do lançamento das correções. O projeto PHP não havia identificado exploits funcionais no momento do lançamento. Se um servidor exposto à internet executou uma versão vulnerável do PHP, revise os logs dele a partir de 17 de outubro de 2026 em busca de:</p><ul><li>requisições multipart seguidas de erros de limite de memória ou de respostas HTTP 500 repetidas</li><li>cookies de resposta <code>PHPSESSID</code> anormalmente grandes ou malformados</li><li>reinicializações inexplicadas de workers do PHP ou processos de shell iniciados por workers do PHP</li><li>arquivos inesperados no servidor web PHP, conexões de saída a partir de workers do PHP ou entradas inesperadas no cron</li></ul><p>Um exploit bem-sucedido pode retornar HTTP 200 e manter o worker em execução, então a ausência de erros não descarta um comprometimento. Se encontrar sinais de exploração, isole o servidor e inicie uma investigação de incidente. Sempre que possível, capture memória, disco e logs antes de aplicar o patch e reiniciar, já que reiniciar os workers do PHP pode apagar evidências. O CVE-2026-109619 também pode expor a memória do processo, mesmo quando o invasor não chega a executar código. Faça a rotação de todas as credenciais, tokens ou chaves que o processo do PHP podia ler.</p><p><strong>Observação:</strong> scanners podem sinalizar a imagem de Dependency Scanning do Gemnasium (gemnasium:6), obsoleta desde o GitLab 17.9, por causa do PHP incluído nela. Ela é usada apenas como ferramenta de linha de comando e nunca processa requisições HTTP, então não é explorável. Além disso, uma versão corrigida já foi publicada com a mesma tag.</p><h2 id="linha-do-tempo">Linha do tempo</h2><table><thead><tr><th align="left">Data</th><th align="left">O que aconteceu</th></tr></thead><tbody><tr><td align="left">1º de agosto</td><td align="left">A Calif descobre a primeira falha durante uma auditoria do PHP assistida por IA e a comunica ao PHP em 11 de agosto; a Wiz Research encontra e comunica as falhas de forma independente em 24 de agosto.</td></tr><tr><td align="left">17 de outubro</td><td align="left">Os honeypots da Amazon registram a primeira tentativa de exploit conhecida, enquanto as falhas ainda estão sob embargo.</td></tr><tr><td align="left">20 de outubro</td><td align="left">O PHP anuncia que uma release de segurança com a correção de duas vulnerabilidades críticas será lançada em 21 de outubro.</td></tr><tr><td align="left">20 de outubro</td><td align="left">Detalhes das vulnerabilidades vazam antes da divulgação coordenada. (<a href="https://www.huntress.com/blog/php2shell-leaked-critical-php-vulnerabilities" rel="">Huntress</a>)</td></tr><tr><td align="left">21 de outubro, 14h (UTC)</td><td align="left">O PHP lança as versões 8.5.12, 8.4.27, 8.3.36 e 8.2.35 e publica os boletins de segurança.</td></tr></tbody></table><style>html pre.shiki code .shJU0, html code.shiki .shJU0{--shiki-default:#22863A}html pre.shiki code .sgsFI, html code.shiki .sgsFI{--shiki-default:#24292E}html pre.shiki code .sYBdl, html code.shiki .sYBdl{--shiki-default:#032F62}html .default .shiki span {color: var(--shiki-default);background: var(--shiki-default-bg);font-style: var(--shiki-default-font-style);font-weight: var(--shiki-default-font-weight);text-decoration: var(--shiki-default-text-decoration);}html .shiki span {color: var(--shiki-default);background: var(--shiki-default-bg);font-style: var(--shiki-default-font-style);font-weight: var(--shiki-default-font-weight);text-decoration: var(--shiki-default-text-decoration);}</style>]]></content>
        <author>
            <name>Abisheik Magesh</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/abisheik-magesh/</uri>
        </author>
        <author>
            <name>Dinesh Bolkensteyn</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/dinesh-bolkensteyn/</uri>
        </author>
        <published>2026-10-23T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[O que é GitFlow?]]></title>
        <id>https://about.gitlab.com/pt-br/blog/what-is-gitflow/</id>
        <link href="https://about.gitlab.com/pt-br/blog/what-is-gitflow/"/>
        <updated>2026-10-22T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>No GitFlow, além da branch <code>main</code> (para operação), cria-se uma branch <code>develop</code> separada (para desenvolvimento), que passa a ser a branch padrão. Já no <a href="https://about.gitlab.com/pt-br/topics/version-control/what-is-gitlab-flow/" rel="">GitLab Flow</a>, o trabalho pode começar diretamente na branch <code>main</code>. O GitLab Flow incorpora branches de pré-produção, o que permite corrigir bugs antes de fazer o merge das alterações na <code>main</code> e o deploy em produção. As equipes podem adicionar quantas branches de pré-produção forem necessárias, criando fluxos como de <code>main</code> para teste, de teste para aceitação e de aceitação para produção.</p><p>Neste artigo, você vai conhecer as diferenças entre o GitFlow e o GitLab Flow, entender o que é o GitFlow, como ele funciona e quais são seus benefícios, além de encontrar respostas para as perguntas mais frequentes.</p><h2 id="índice">Índice</h2><ul><li><a href="#o-que-%C3%A9-o-gitflow">O que é o GitFlow?</a></li><li><a href="#como-o-gitflow-funciona">Como o GitFlow funciona</a></li><li><a href="#diferen%C3%A7as-entre-o-gitflow-e-o-gitlab-flow">Diferenças entre o GitFlow e o GitLab Flow</a></li><li><a href="#fluxo-de-trabalho-do-gitflow">Fluxo de trabalho do GitFlow</a></li><li><a href="#fluxo-de-trabalho-do-gitlab-flow">Fluxo de trabalho do GitLab Flow</a></li><li><a href="#benef%C3%ADcios-e-caracter%C3%ADsticas-do-gitflow">Benefícios e características do GitFlow</a></li><li><a href="#exemplo-de-gitflow">Exemplo de GitFlow</a></li><li><a href="#perguntas-frequentes-sobre-gitlab-flow-e-gitflow">Perguntas frequentes sobre GitLab Flow e GitFlow</a></li></ul><h2 id="o-que-é-o-gitflow">O que é o GitFlow?</h2><p>O GitFlow é um fluxo de trabalho do Git criado para gerenciar branches no Git (um sistema de controle de versão distribuído). Na prática, ele funciona como um modelo de branches para repositórios Git. Criado para simplificar o gerenciamento de releases em projetos de software complexos, foi apresentado por Vincent Driessen em 2010 e é especialmente popular entre equipes grandes.</p><h2 id="como-o-gitflow-funciona">Como o GitFlow funciona</h2><p>Em comparação com o desenvolvimento baseado em trunk (<em>trunk-based development</em>), o GitFlow trabalha com branches persistentes e tende a envolver commits maiores. Ele pode ser usado em projetos com ciclos de release programados e pode ser combinado com as boas práticas de <a href="https://about.gitlab.com/pt-br/platform/" rel="">DevOps</a>. O GitFlow oferece um fluxo de trabalho estruturado, em que cada branch tem uma finalidade definida: as branches de feature saem da <code>develop</code>, as branches de <code>release</code> preparam cada release e, por fim, o código chega à <code>main</code>. Já as correções urgentes saem da própria <code>main</code>, em branches de hotfix. Essa estrutura deixa mais claro para as equipes onde cada alteração deve ser integrada na pipeline de desenvolvimento.</p><h2 id="diferenças-entre-o-gitflow-e-o-gitlab-flow">Diferenças entre o GitFlow e o GitLab Flow</h2><p>O GitFlow é um modelo de branches do Git que usa várias branches principais, além das branches de feature. O <a href="https://about.gitlab.com/pt-br/topics/version-control/what-is-gitlab-flow/" rel="">GitLab Flow</a> busca reduzir parte da complexidade do GitFlow, permitindo que as equipes trabalhem com mais eficiência. A seguir, veja em detalhes as diferenças entre os dois fluxos de trabalho.</p><h3 id="fluxo-de-trabalho-do-gitflow">Fluxo de trabalho do GitFlow</h3><p>O fluxo de trabalho do GitFlow envolve cinco tipos de branches:</p><ol><li><code>main</code></li><li><code>develop</code></li><li><code>feature</code></li><li><code>release</code></li><li><code>hotfix</code></li></ol><p>No desenvolvimento com GitFlow, o trabalho acontece na branch <code>main</code> e em várias branches de apoio. Há duas branches principais de longa duração: a <code>main</code>, com o código pronto para produção, e a <code>develop</code>, onde é integrado o código em desenvolvimento. O código é estabilizado na <code>develop</code>, preparado para a release e, quando está pronto, é incorporado à <code>main</code> por meio de um merge. As branches de apoio, como as de feature, release e hotfix, são criadas para tarefas específicas de desenvolvimento.</p><h3 id="fluxo-de-trabalho-do-gitlab-flow">Fluxo de trabalho do GitLab Flow</h3><p>O GitLab Flow simplifica o desenvolvimento ao evitar o overhead associado a releases, criação de tags, merges e outras atividades.</p><p>O GitLab Flow é uma alternativa simplificada ao GitFlow, que combina o desenvolvimento orientado a features com recursos de rastreamento de issues. Com ele, os fluxos de trabalho ficam simples, diretos e eficientes. O GitLab Flow incorpora boas práticas que ajudam as equipes de desenvolvimento de software a lançar features sem complicações.</p><p>O GitLab Flow é o fluxo de trabalho usado no próprio desenvolvimento do GitLab. Ele envolve branches como a <code>main</code>; uma branch de testes antes da release, a <code>pre-production</code>; uma branch para gerenciar o código já lançado, a <code>production</code>; e branches para desenvolver features ou corrigir bugs, como <code>feature</code> e <code>hotfix</code>. As equipes podem adicionar quantas branches de pré-produção precisarem, criando fluxos como de <code>main</code> para teste, de teste para aceitação e de aceitação para produção.</p><p>Enquanto criam branches de feature, as equipes também gerenciam as branches de produção. Quando a <code>main</code> está pronta para o deploy, é feito o merge dela na branch <code>production</code> e a release é publicada. O GitLab Flow também pode ser usado com branches de release. Equipes que mantêm APIs públicas precisam gerenciar versões diferentes, e o GitLab Flow facilita isso ao permitir a criação de branches gerenciáveis de forma independente, como <code>v1</code> e <code>v2</code>. Assim, se a revisão de código encontrar bugs na <code>v2</code>, é simples voltar para a <code>v1</code>.</p><h2 id="benefícios-e-características-do-gitflow">Benefícios e características do GitFlow</h2><h3 id="_1-correção-rápida-de-bugs">1: Correção rápida de bugs</h3><p>Um dos benefícios do GitFlow é a possibilidade de corrigir bugs no ambiente de produção com rapidez. A correção é feita em uma branch de hotfix criada a partir da <code>main</code> e, depois de concluída, passa por merge tanto na <code>main</code> quanto na <code>develop</code>, sem esperar o próximo ciclo de release.</p><h3 id="_2-tempo-garantido-para-testes">2: Tempo garantido para testes</h3><p>Ao lançar software a partir de uma branch de release, é possível reservar um tempo para que os usuários testem em um ambiente de homologação. Isso pode acontecer de forma independente do desenvolvimento em andamento, que continua na <code>develop</code>. Além disso, como a branch de release recebe apenas correções, os testes acontecem sobre um código estável.</p><h3 id="_3-processo-de-desenvolvimento-de-software-mais-enxuto">3: Processo de desenvolvimento de software mais enxuto</h3><p>Com o GitFlow, é possível aproveitar todo o potencial do Git, o que ajuda a tornar o processo de desenvolvimento de software mais enxuto.</p><h3 id="_4-colaboração-mais-eficiente-e-resolução-de-conflitos">4: Colaboração mais eficiente e resolução de conflitos</h3><p>Adotar o GitFlow torna a colaboração mais eficiente: como cada branch tem um papel definido, as equipes sabem onde integrar cada alteração e conseguem resolver os conflitos de merge com mais clareza.</p><h2 id="exemplo-de-gitflow">Exemplo de GitFlow</h2><p>O diagrama abaixo mostra um exemplo de configuração do GitFlow, com as diferentes branches e sua estrutura, para deixar o fluxo geral mais claro.</p><p><img alt="Exemplo de GitFlow" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1749673714/Blog/Content%20Images/AdobeStock_569852816.jpg" /></p><h2 id="perguntas-frequentes-sobre-gitlab-flow-e-gitflow">Perguntas frequentes sobre GitLab Flow e GitFlow</h2><h3 id="p-o-que-é-o-git-feature-flow">P: O que é o Git Feature Flow?</h3><p>R: É um dos fluxos de trabalho propostos para o desenvolvimento com Git. O Git Feature Flow é indicado para necessidades de desenvolvimento mais simples.</p><h3 id="p-vale-a-pena-usar-o-gitlab-flow">P: Vale a pena usar o GitLab Flow?</h3><p>R: Sim. O GitLab Flow reduz o overhead de atividades como releases, criação de tags e merges, que costumam ser problemas comuns em outros fluxos de trabalho do Git. Para saber mais, confira <a href="https://about.gitlab.com/pt-br/topics/version-control/what-are-gitlab-flow-best-practices/" rel="">estas boas práticas do GitLab Flow</a>.</p><h3 id="p-como-escolher-entre-o-gitlab-flow-e-o-gitflow">P: Como escolher entre o GitLab Flow e o GitFlow?</h3><p>R: Por causa da sua estrutura, o GitFlow é indicado para projetos grandes, com etapas de desenvolvimento bem definidas. Já o GitLab Flow, por ser mais ágil, é mais indicado para projetos que priorizam a entrega contínua e releases rápidas.</p><h2 id="comece-a-usar-o-gitlab">Comece a usar o GitLab</h2><p>Comece hoje o seu <a href="https://about.gitlab.com/pt-br/free-trial/" rel="">teste gratuito do GitLab Ultimate e do GitLab Duo Enterprise</a>!</p>]]></content>
        <author>
            <name>GitLab Team</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/gitlab-team/</uri>
        </author>
        <published>2026-10-22T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Kubernetes: conheça a solução de orquestração de contêineres]]></title>
        <id>https://about.gitlab.com/pt-br/blog/kubernetes-the-container-orchestration-solution/</id>
        <link href="https://about.gitlab.com/pt-br/blog/kubernetes-the-container-orchestration-solution/"/>
        <updated>2026-10-22T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>O Kubernetes automatiza as tarefas de deploy e gerenciamento de aplicações conteinerizadas em larga escala. Com o tempo, tornou-se uma ferramenta essencial para o desenvolvimento de aplicações em diversas áreas, como <a href="https://about.gitlab.com/pt-br/topics/microservices/" rel="">microsserviços</a>, aplicações web e bancos de dados. Seu desempenho e sua escalabilidade fazem dele, hoje, um padrão reconhecido no gerenciamento de contêineres.</p><p>Neste artigo, veja tudo o que você precisa saber sobre o Kubernetes.</p><h2 id="o-que-é-o-kubernetes">O que é o Kubernetes?</h2><p>O Kubernetes é um sistema de código aberto para orquestrar com eficiência os contêineres de uma aplicação de software. A conteinerização é uma abordagem amplamente reconhecida no desenvolvimento de aplicações, principalmente em projetos de transformação digital e de nuvem.</p><p>Para quem ainda não conhece o conceito, os contêineres são um método de desenvolvimento que agrupa os componentes de uma aplicação em unidades padronizadas, independentes dos dispositivos e sistemas operacionais em que estão. Ao isolar as aplicações do ambiente, essa tecnologia facilita o deploy e a portabilidade, além de reduzir conflitos de interoperabilidade.</p><p>É aí que entra o Kubernetes. Os contêineres permitem dividir as aplicações em módulos menores e autônomos, o que facilita o deploy. Mas, para que esses módulos interajam dentro de uma aplicação, é preciso um sistema de gerenciamento que abranja todos eles. É justamente isso que o Kubernetes faz: ele oferece uma plataforma para controlar onde e como os contêineres são executados, o que permite orquestrar e programar a execução deles para gerenciar aplicações conteinerizadas em larga escala.</p><blockquote><p>Confira os <a href="https://about.gitlab.com/blog/tags/kubernetes/" rel="">artigos do GitLab sobre Kubernetes</a> (em inglês).</p></blockquote><h2 id="como-funciona-a-arquitetura-do-kubernetes">Como funciona a arquitetura do Kubernetes?</h2><p>Para entender como funciona a arquitetura do Kubernetes, é essencial conhecer alguns conceitos, a começar pelo de cluster, o mais abrangente da arquitetura. Um cluster Kubernetes é o conjunto de máquinas virtuais ou físicas em que uma aplicação conteinerizada é instalada.</p><p><img alt="Componentes do Kubernetes" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1749673941/Blog/Content%20Images/components-of-kubernetes.png" /></p><p>Fonte: <a href="https://kubernetes.io/docs/concepts/overview/components/" rel="">Kubernetes</a>.</p><p>O cluster é formado por diferentes elementos:</p><ul><li>Nó: é a unidade de trabalho de um cluster Kubernetes. Trata-se de uma máquina virtual ou física que executa tarefas para a aplicação.</li><li>Pod: o pod é a menor unidade de deploy do Kubernetes. É um grupo de contêineres que trabalham juntos no mesmo nó. Os contêineres de um pod compartilham a mesma rede e podem se comunicar entre si via localhost.</li><li>Service: um Service do Kubernetes expõe um pod à rede ou a outros pods. Ele oferece um ponto de acesso estável e bem definido às aplicações hospedadas nos pods.</li><li>Volume: é uma abstração de diretório que permite que os contêineres de um pod compartilhem arquivos e preservem dados quando um contêiner é reiniciado.</li><li>Namespace: o namespace permite agrupar e isolar recursos para formar um cluster virtual.</li></ul><p>A arquitetura do Kubernetes se divide em duas partes principais: a camada de gerenciamento (<em>control plane</em>, antes chamada de <em>master node</em>) e os nós de trabalho (<em>worker nodes</em>). A camada de gerenciamento é responsável pelo gerenciamento geral do cluster e pela comunicação com os nós de trabalho. Entre seus principais componentes, o servidor de API (kube-apiserver) é o ponto central de todas as comunicações entre usuários e cluster. O <a href="https://kubernetes.io/docs/concepts/overview/components/#etcd" rel="">etcd</a> é o banco de dados de chave-valor que armazena as configurações, o estado do sistema e os metadados dos objetos. O gerenciador de controladores (kube-controller-manager) coordena operações em segundo plano, como a replicação de pods, e o kube-scheduler distribui os pods entre os nós conforme os recursos disponíveis.</p><p>Os nós de trabalho, por sua vez, são as máquinas que executam e gerenciam as aplicações contidas nos pods. Neles, o <a href="https://kubernetes.io/docs/concepts/overview/components/#kubelet" rel="">kubelet</a> é o agente que roda em cada nó e se comunica com a camada de gerenciamento para receber comandos e informar o estado dos pods. O proxy de rede, ou <a href="https://kubernetes.io/docs/concepts/overview/components/" rel="">kube-proxy</a>, mantém regras de rede nos nós que permitem a comunicação com os Services, tanto de dentro quanto de fora do cluster. Por fim, o agente de execução de contêiner (<em>container runtime</em>) é o software responsável pela execução e pelo gerenciamento dos contêineres nos pods.</p><h3 id="o-papel-do-docker">O papel do Docker</h3><p>Entre todos os componentes de um cluster K8s, a escolha do agente de execução de contêiner nos nós de trabalho é importante. Os mais usados hoje são o containerd e o CRI-O, que seguem a Container Runtime Interface (CRI) do Kubernetes. Desde a versão 1.24, de 2022, o Kubernetes não usa mais o Docker Engine diretamente como agente de execução. Ainda assim, as imagens criadas com o Docker continuam funcionando normalmente, porque seguem o padrão OCI.</p><h3 id="qual-é-a-diferença-entre-o-docker-e-o-kubernetes">Qual é a diferença entre o Docker e o Kubernetes?</h3><p>O Docker é uma solução de código aberto usada especificamente no nível dos contêineres. Ele permite empacotar contêineres em um formato padronizado e leve, o que aumenta sua portabilidade entre diferentes ambientes. É, portanto, uma ferramenta complementar ao K8s: o Docker facilita o gerenciamento dos próprios contêineres, enquanto o Kubernetes simplifica a integração e a comunicação entre eles dentro da aplicação.</p><h2 id="quais-são-os-benefícios-do-kubernetes">Quais são os benefícios do Kubernetes?</h2><p>Lançado pelo Google em 2014, o Kubernetes teve sua primeira versão estável em julho de 2015. Desde então, sua popularidade não diminuiu, e o K8s se tornou referência em orquestração de contêineres, principalmente em arquiteturas orientadas a microsserviços. Mas, afinal, por que usar o Kubernetes? Esse sucesso se deve, antes de tudo, ao excelente desempenho do software na orquestração de contêineres.</p><p>Os benefícios do Kubernetes são muitos:</p><ul><li>Automação: o Kubernetes facilita a automação de tarefas de deploy, escalonamento e atualização de aplicações conteinerizadas.</li><li>Flexibilidade: o software se adapta a diferentes tecnologias de contêiner, além de várias arquiteturas de hardware e sistemas operacionais.</li><li>Escalabilidade: o K8s facilita o deploy e o gerenciamento de milhares de contêineres e acompanha o estado de cada um deles.</li><li>Migração: em muitos casos, é possível migrar aplicações conteinerizadas para o Kubernetes sem alterar o código-fonte.</li><li>Gerenciamento de vários clusters: com ferramentas complementares, é possível gerenciar de forma centralizada vários clusters distribuídos em diferentes infraestruturas.</li><li>Gerenciamento de atualizações: o software oferece suporte a rolling updates, que atualizam as aplicações sem interromper o serviço.</li></ul><h2 id="um-ecossistema-robusto-e-escalável">Um ecossistema robusto e escalável</h2><p>O Kubernetes se destaca pela capacidade de gerenciar contêineres de forma eficiente e segura, mantendo a independência em relação aos provedores de infraestrutura de nuvem. Sua arquitetura modular se adapta às necessidades específicas de cada empresa e comporta uma gama muito ampla de aplicações e serviços (serviços web, processamento de dados, aplicações móveis etc.).</p><p>Na corrida pela transformação digital, o Kubernetes também conquista adeptos graças ao seu ecossistema rico e escalável na comunidade de código aberto. Gerenciado pela Cloud Native Computing Foundation (<a href="https://www.cncf.io/" rel="">CNCF</a>), o K8s conta com o apoio de milhares de desenvolvedores no mundo todo, que contribuem para o desenvolvimento do projeto e para a melhoria contínua de suas funcionalidades.</p><h2 id="quais-são-as-limitações-do-kubernetes">Quais são as limitações do Kubernetes?</h2><p>Os benefícios do Kubernetes fazem dele uma escolha segura para muitas equipes de desenvolvimento no universo das aplicações nativas da nuvem (<em>cloud-native</em>). Ainda assim, vale apontar algumas limitações. O Kubernetes exige uma base técnica sólida e capacitação em novos conceitos e métodos de desenvolvimento. O software pode ser complexo de configurar no início de um projeto, e a configuração é decisiva, principalmente para proteger a plataforma. Por isso, contar com uma equipe de desenvolvimento experiente em K8s é uma vantagem significativa.</p><p>Outro desafio é a implementação e a manutenção de uma arquitetura K8s, que também exigem tempo e recursos, principalmente para atualizar seus vários componentes e softwares. Isso levanta a questão de um possível superdimensionamento: no caso de uma aplicação pequena, ou de um projeto sem grandes desafios de escalabilidade, uma arquitetura mais simples pode ser suficiente e mais econômica.</p><h2 id="o-kubernetes-nas-equipes">O Kubernetes nas equipes</h2><p>Dezenas de milhares de empresas adotaram uma arquitetura Kubernetes como parte da sua transformação digital. O K8s é usado por empresas de todos os portes, de startups a multinacionais.</p><p>Há muitos exemplos de integrações bem-sucedidas, como o da Haven Technologies. A empresa migrou seus serviços SaaS para o K8s e se apoia, em especial, em uma estratégia de Kubernetes com a plataforma DevSecOps do GitLab para ajudar suas equipes a ganhar eficiência, segurança e velocidade no desenvolvimento de software. Confira o nosso <a href="https://about.gitlab.com/customers/haven-technologies/" rel="">estudo de caso</a> (em inglês) para saber mais!</p><h2 id="kubernetes-git-e-gitlab">Kubernetes, Git e GitLab</h2><p>Kubernetes, Git e GitLab são elementos essenciais do cenário DevOps. O Kubernetes oferece grande flexibilidade para fazer o deploy e gerenciar os vários componentes de uma aplicação. Já o GitLab, construído em torno do Git e de seu sistema nativo de controle de versão, permite um acompanhamento rigoroso e preciso do código-fonte e das alterações, além de oferecer um conjunto completo de ferramentas para gerenciar todo o ciclo de vida do desenvolvimento de software.</p><p>Essa combinação, junto com uma <a href="https://about.gitlab.com/pt-br/topics/gitops/" rel="">abordagem GitOps</a>, que busca automatizar o provisionamento de infraestruturas de nuvem modernas, cria um ambiente ágil para o desenvolvimento e o deploy de aplicações, o que torna possível entregar software poderoso, flexível e escalável. Para mais detalhes, conheça <a href="https://docs.gitlab.com/user/clusters/agent/" rel="">as soluções do GitLab para conectar um cluster Kubernetes</a> (em inglês).</p><h2 id="perguntas-frequentes-sobre-kubernetes">Perguntas frequentes sobre Kubernetes</h2><h3 id="quais-são-as-soluções-concorrentes-do-k8s">Quais são as soluções concorrentes do K8s?</h3><p>Existem algumas alternativas ao Kubernetes, como o Docker Swarm e o Marathon. Ainda assim, o Kubernetes é considerado a solução mais madura e popular do mercado. Sua ampla base de usuários, a documentação abundante e o apoio de uma comunidade ativa fazem do Kubernetes uma excelente escolha para quem quer adotar um sistema de orquestração de contêineres.</p><h3 id="o-que-é-um-cluster-kubernetes">O que é um cluster Kubernetes?</h3><p>Um cluster Kubernetes é composto por uma camada de gerenciamento e vários nós de trabalho. A camada de gerenciamento coordena as tarefas do cluster, enquanto os nós de trabalho executam essas tarefas de orquestração e hospedam os contêineres. Os clusters K8s são altamente escaláveis: é possível adicionar ou remover nós para adequar os recursos do cluster às necessidades da aplicação.</p><h3 id="como-começar-a-usar-o-kubernetes">Como começar a usar o Kubernetes?</h3><p>Para começar, é preciso escolher onde executar o Kubernetes. Para testes locais em Linux, macOS ou Windows, ferramentas como o minikube ou o kind criam um cluster na própria máquina. Em produção, o cluster pode ser instalado em uma infraestrutura própria, com ferramentas como o kubeadm, ou contratado como serviço gerenciado na nuvem (Google Kubernetes Engine ou Amazon EKS, por exemplo). Depois de criar o cluster e conectar a camada de gerenciamento aos nós de trabalho, já é possível fazer o deploy de uma primeira aplicação com o Kubernetes.</p><h3 id="por-que-escolher-o-kubernetes">Por que escolher o Kubernetes?</h3><p>O Kubernetes oferece grande flexibilidade e portabilidade total entre diferentes plataformas de nuvem ou infraestruturas locais. Ao automatizar as tarefas de orquestração, o K8s ajuda a otimizar recursos, reduzir custos operacionais e liberar tempo de desenvolvedores e administradores de sistemas. Por fim, o ecossistema do Kubernetes é vasto e está em constante evolução graças a uma grande comunidade de código aberto, o que possibilita uma inovação rápida.</p><h2 id="leia-mais">Leia mais</h2><ul><li><a href="https://about.gitlab.com/blog/how-to-stream-logs-through-the-gitlab-dashboard-for-kubernetes/" rel="">Como transmitir logs pelo GitLab Dashboard for Kubernetes (em inglês)</a></li><li><a href="https://about.gitlab.com/blog/kubernetes-overview-operate-cluster-data-on-the-frontend/" rel="">Kubernetes overview: como operar dados do cluster no frontend (em inglês)</a></li><li><a href="https://about.gitlab.com/blog/simplify-your-cloud-account-management-for-kubernetes-access/" rel="">Simplifique o gerenciamento de contas de nuvem para acesso ao Kubernetes (em inglês)</a></li></ul>]]></content>
        <author>
            <name>GitLab Team</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/gitlab-team/</uri>
        </author>
        <published>2026-10-22T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Linha de comando do Git no Windows com o Git Bash]]></title>
        <id>https://about.gitlab.com/pt-br/blog/git-command-line-on-windows-with-git-bash/</id>
        <link href="https://about.gitlab.com/pt-br/blog/git-command-line-on-windows-with-git-bash/"/>
        <updated>2026-10-22T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>Os comandos do Git permitem gerenciar diferentes versões do código e colaborar em equipe. Quem trabalha no Windows provavelmente já ouviu falar do Git Bash, um emulador de terminal Bash que inclui uma versão do Git adaptada ao Windows. Neste guia, veja tudo o que você precisa saber para instalar o Git Bash.</p><h2 id="como-o-git-bash-funciona">Como o Git Bash funciona?</h2><p>O Git Bash é uma aplicação instalada no Windows por meio do Git for Windows. Ela funciona como um emulador do terminal Bash e traz junto a <a href="https://about.gitlab.com/pt-br/topics/version-control/what-is-git-version-control/#what-is-git" rel="">ferramenta de controle de versão Git</a>, para que os comandos do Git rodem nesse terminal.</p><p>Bash é a sigla de Bourne Again Shell. O termo <em>shell</em> designa a aplicação de terminal de comandos de um sistema operacional. O Bourne Again Shell é, na verdade, uma versão aprimorada do Bourne Shell (também chamado de sh), a interface de linha de comando do UNIX criada por Stephen Bourne em 1977.</p><p>O Bash é o shell padrão na maioria das distribuições Linux e foi também o padrão do macOS até 2019, quando a Apple passou a adotar o zsh. Com o Git Bash, quem usa Windows pode instalar o Bash, executar comandos do Bash e usar os comandos do Git.</p><h2 id="como-instalar-o-git-bash">Como instalar o Git Bash</h2><p>Para ter o Git Bash, é preciso instalar o Git for Windows. Acesse o site oficial do <a href="https://gitforwindows.org/" rel="">Git for Windows</a> e clique em <strong>Download</strong> para baixar o pacote completo do Git. Quando o download terminar, abra o arquivo .exe para iniciar a instalação.</p><p>Siga este passo a passo para instalar o Git Bash no Windows:</p><ol><li>Na primeira tela do instalador, clique em <strong>Next</strong> e selecione a pasta de instalação.</li><li>Aceite os termos de uso e clique em <strong>Next</strong> para começar a instalação.</li><li>Nesta etapa, selecione os componentes que serão instalados. As configurações pré-selecionadas são adequadas, mas é possível alterá-las conforme suas preferências. Clique em <strong>Next</strong> novamente.</li><li>Em seguida, escolha o editor que prefere usar com o Git. A ferramenta reconhece os editores já instalados no computador.</li><li>Uma janela exibe três opções de configuração da variável de ambiente PATH. De acordo com a sua necessidade, escolha se o Git deve ser usado apenas pelo Git Bash ou também por softwares de terceiros.</li><li>Por fim, mantenha as configurações padrão clicando em <strong>Next</strong> e instale o Git Bash clicando em <strong>Install</strong>.</li></ol><h2 id="comandos-básicos-do-bash">Comandos básicos do Bash</h2><p>Alguns comandos ajudam a se orientar no terminal. O primeiro é o <code>pwd</code> (Print Working Directory), que mostra o caminho absoluto, ou seja, o caminho da pasta atual no momento em que o comando é digitado.</p><p><strong>Lembre-se:</strong> ao abrir o terminal do Git Bash, você já está em uma pasta do computador. Normalmente, é a pasta com o seu nome de usuário.</p><p>O comando <code>ls</code> lista os arquivos da pasta atual. Também é possível adicionar opções ao <code>ls</code> com um hífen (<code>-</code>). Por exemplo, a opção <code>-l</code> depois de <code>ls</code> lista o conteúdo da pasta com mais informações sobre cada arquivo.</p><p>O Bash também tem o comando <code>cd</code> (Change Directory), usado para navegar pelo computador. Para indicar o diretório de destino, informe o caminho relativo ou absoluto depois de <code>cd</code>. O caminho relativo é a localização em relação ao diretório atual; o caminho absoluto é a localização em relação à pasta raiz.</p><h2 id="como-usar-o-git-bash-com-o-gitlab">Como usar o Git Bash com o GitLab</h2><p>Usar o Git Bash com o <a href="https://about.gitlab.com/pt-br/" rel="">GitLab</a> funciona como usar o emulador de terminal com qualquer outra plataforma de gerenciamento de código-fonte. Para fazer push das suas alterações para o GitLab e recuperá-las de lá, adicione a URL do seu repositório remoto no GitLab com o comando <code>git remote add origin &lt;repository_url&gt;</code>.</p><p>Se o projeto for privado, o Git Bash pede autenticação. Informe suas credenciais quando o terminal solicitar o nome de usuário e a senha. Em caso de problemas para fazer login, verifique as configurações de autorização diretamente no GitLab.</p><p>Em seguida, use os comandos básicos do Git, como <code>git clone</code>, <code>git commit</code>, <code>git push</code>, <code>git branch</code> e <code>git checkout</code>, entre outros. Para saber mais, consulte o nosso <a href="https://res.cloudinary.com/about-gitlab-com/image/upload/v1782404891/site/Content%20Images/press/git-cheat-sheet.pdf" rel="">guia rápido de comandos do Git</a> (em inglês).</p><h2 id="perguntas-frequentes-sobre-o-git-bash">Perguntas frequentes sobre o Git Bash</h2><p><strong>O Git Bash é compatível com o GitLab?</strong></p><p>Sim. Usar o Git Bash com o GitLab é semelhante a trabalhar com qualquer outra plataforma de gerenciamento de código-fonte. Não se esqueça de configurar o GitLab como repositório remoto e de se autenticar durante a configuração inicial.</p><p><strong>Por que usar o Git Bash?</strong></p><p>O Git Bash funciona como um emulador de terminal para usar os comandos do Git e do Bash no ambiente Windows.</p><p><strong>Para que serve um shell?</strong></p><p>Com um shell, é possível automatizar tarefas por meio de scripts, controlar o computador de forma eficaz e contar com acesso direto às funções do sistema.</p><h2 id="leia-mais">Leia mais</h2><ul><li><a href="https://about.gitlab.com/pt-br/topics/version-control/what-is-git-version-control/" rel="">O que é o controle de versão do Git?</a></li><li><a href="https://about.gitlab.com/blog/whats-new-in-git-2-47-0/" rel="">O que há de novo no Git 2.47.0? (em inglês)</a></li><li><a href="https://about.gitlab.com/pt-br/blog/git-pull-vs-git-fetch-whats-the-difference/" rel="">Git pull vs. git fetch: qual é a diferença?</a></li></ul>]]></content>
        <author>
            <name>GitLab</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/gitlab/</uri>
        </author>
        <published>2026-10-22T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Transforme a forma como sua equipe entrega software com agentes de IA]]></title>
        <id>https://about.gitlab.com/pt-br/blog/redesign-how-your-team-ships-software-with-ai-agents/</id>
        <link href="https://about.gitlab.com/pt-br/blog/redesign-how-your-team-ships-software-with-ai-agents/"/>
        <updated>2026-10-20T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>Os agentes de IA estão enviando cada vez mais código para filas de revisão que foram pensadas para o ritmo de trabalho humano. Um assistente de código até pode acelerar a escrita de código, mas não mostra se a revisão, as verificações de segurança e as aprovações de release conseguem acompanhar todo esse código a mais. A <em>engenharia nativa em IA</em> — a prática de desenhar o processo de engenharia de forma deliberada, para que pessoas e agentes façam, cada um, aquilo em que são melhores — começa pela identificação dos gargalos da entrega. Depois, é preciso decidir quanta autonomia os agentes devem ter e como manter o controle à medida que a operação cresce.</p><p>O <a href="https://about.gitlab.com/pt-br/ai-native-playbook/" rel="">AI-Native Engineering Playbook</a>, lançado nesta semana, ajuda as equipes a transformar programação mais rápida em entrega mais rápida, redesenhando a forma como entregam software com agentes. Cada prática do playbook se baseia em insights de líderes de engenharia do GitLab, de nossos clientes e de membros da nossa <a href="https://selfcommunity.co/" rel="">comunidade Software Engineering Leadership Forum (SELF)</a>. Também fizemos uma parceria com a <a href="https://itrevolution.com/" rel="">IT Revolution</a> para incorporar as conclusões de um grupo diversificado de profissionais que analisam o desenvolvimento de software nativo em IA por diferentes ângulos, da revisão de código à autonomia dos agentes.</p><p>A seguir, algumas das perguntas que buscamos responder ao criar o playbook.</p><h2 id="para-onde-vai-o-gargalo-quando-a-programação-fica-mais-rápida">Para onde vai o gargalo quando a programação fica mais rápida?</h2><p>A programação costumava ser a parte mais lenta e mais cara do desenvolvimento de software. Os agentes eliminaram esse gargalo, e a restrição migrou para tudo o que está ao redor do código: a espera por esclarecimentos, por ambientes, por aprovações e por outras equipes. O <a href="https://about.gitlab.com/pt-br/resources/ai-accountability-survey-2026/" rel="">Relatório de Responsabilidade em IA de 2026</a> do GitLab, baseado em uma pesquisa feita em abril de 2026 com 1.528 profissionais de DevSecOps, mostrou que 79% dos participantes concordam que a produtividade individual dos desenvolvedores melhorou com a IA, mas que o processo de entrega de software como um todo não acelerou no mesmo ritmo.</p><p>Em grandes empresas, o lead time de entrega de software costuma ultrapassar bastante os 200 dias, e o desenvolvimento propriamente dito ocupa só de 10% a 20% desse tempo. Os números explicam por que acelerar a etapa de programação costuma decepcionar no longo prazo. Imagine, por exemplo, um ciclo de entrega de 281 dias, dos quais cerca de 32 são dedicados à programação. Com a programação 50% mais rápida, a economia é de cerca de 16 dias, uma melhoria de 6%. E, mesmo que o tempo de programação chegasse a zero, cerca de 88% do lead time continuaria intocado. <a href="#artigos-citados-neste-texto">[1]</a></p><p>A pesquisa do GitLab chegou a um resultado parecido: os profissionais de DevSecOps disseram dedicar só 16% do tempo à escrita de código novo, e 85% concordam que a IA deslocou o gargalo da escrita de código para a revisão e a validação.</p><p>Por isso, a primeira tarefa é o diagnóstico. Escolha uma mudança pequena e real e <a href="https://about.gitlab.com/pt-br/ai-native-playbook/topics/redesigning-the-work/find-the-real-bottleneck/" rel="">acompanhe o caminho dela do pedido até a produção</a>, marcando cada espera e cada passagem de bastão. As esperas mais longas mostram onde está a próxima melhoria, e raramente ela está no código. Observe também onde um agente trava em uma tarefa pequena. Esse travamento costuma apontar para um padrão que não foi documentado, um ambiente difícil de subir ou um contexto que só existia na cabeça de uma pessoa.</p><p><img alt="O que parece lento no ciclo de entrega e o que de fato atrasa a equipe." src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1790265004/jadfgmjgjrdomp0liolj.png" /></p><h2 id="quanta-autonomia-os-agentes-devem-ter">Quanta autonomia os agentes devem ter?</h2><p>A autonomia de um agente deve depender da capacidade de verificar o que ele produz. Imagine uma escada de quatro degraus: de um extremo, em que uma pessoa aprova cada etapa, ao outro, em que o fluxo de trabalho é totalmente autônomo, sem nenhuma intervenção humana (zero-touch). Nesse modelo, as regras para subir a escada são claras: nenhum degrau pode ser pulado, e cada subida precisa ser sustentada por evidências do degrau anterior. <a href="#artigos-citados-neste-texto">[2]</a></p><ol><li><strong>Estágio 1</strong>: as pessoas estão no loop (<em>human-in-the-loop</em>) em todas as etapas</li><li><strong>Estágio 2</strong>: as pessoas continuam no loop, mas o agente executa dentro de parâmetros definidos</li><li><strong>Estágio 3</strong>: as pessoas saem do loop na operação normal e cuidam só das exceções</li><li><strong>Estágio 4</strong>: um fluxo de trabalho sem intervenção humana, em que o agente se gerencia de ponta a ponta e só chama uma pessoa quando limites predefinidos são atingidos <a href="#artigos-citados-neste-texto">[2]</a></li></ol><p>Também é importante que cada fluxo de trabalho com IA tenha uma pessoa responsável, com nome e sobrenome, e que a diferença entre uma pessoa que revisa e uma pessoa que monitora seja definida de forma explícita, já que definições vagas ou arbitrárias tendem a se perder quando estão sob pressão de um prazo. <a href="#artigos-citados-neste-texto">[3]</a></p><p>E esse desgaste é a armadilha. Uma pessoa que está no loop só no papel, mas aprova tudo, dá a aparência de controle sem os benefícios, e o hábito e o volume podem facilmente transformar a revisão em aprovação no automático. Por outro lado, um ponto de controle que ninguém de fato usa é pior do que nenhum, porque gera confiança justamente onde o sistema precisa de análise rigorosa.</p><p>O caminho para subir é <a href="https://about.gitlab.com/pt-br/ai-native-playbook/topics/working-with-agents/earn-autonomy-with-evidence/" rel="">conquistar cada degrau com evidências</a>. Defina um limite explícito de precisão ou de sucesso antes de subir um degrau e, depois, passe as pessoas da revisão de cada etapa para o monitoramento do todo. Um agente que interrompe o trabalho com mais frequência para pedir ajuda é um bom sinal: mostra que o sistema se recusa a ir além do que as próprias evidências sustentam. <a href="#artigos-citados-neste-texto">[2]</a></p><p><img alt="Processo em várias etapas em que os agentes ganham autonomia aos poucos, com critérios específicos a cumprir entre um degrau e outro." src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1790263448/bqsoqbyhendbrtuuv2yo.png" /></p><h2 id="como-revisar-código-no-volume-gerado-por-agentes">Como revisar código no volume gerado por agentes?</h2><p>Dar mais autonomia aos agentes depende de detectar erros, e isso coloca pressão sobre a revisão de código. A revisão no momento do merge foi criada para o ritmo de produção humano. Os agentes aumentam a frequência das mudanças, e a revisão manual de cada conjunto de mudanças se tornou insustentável. A pesquisa do GitLab também evidenciou essa pressão: 78% dos participantes concordam que os processos atuais de revisão de código não foram pensados para a escala de código que as ferramentas de IA possibilitam, e 80% concordam que a organização adotou ferramentas de programação com IA mais rápido do que desenvolveu políticas de governança para elas.</p><p>A resposta é um <a href="https://about.gitlab.com/pt-br/ai-native-playbook/topics/governing-and-scaling/verify-what-agents-produce/" rel="">sistema de verificação em camadas</a>, em que cada camada faz a parte que faz melhor. As pessoas só saem do loop quando o nível de risco e as evidências justificam essa escolha de design — isso nunca é o padrão. <a href="#artigos-citados-neste-texto">[4]</a></p><ol><li>Leve as verificações objetivas, como formatação, tipos e política de dependências, para o mais perto possível da autoria do código.</li><li>Mantenha as mudanças pequenas, para que cada camada seguinte trabalhe mais rápido.</li><li>Defina o comportamento esperado logo no início, para que haja algo concreto a verificar.</li><li>Use um revisor independente.</li><li>Ajuste a profundidade da revisão ao risco da mudança.</li><li>Registre cada decisão de revisão agêntica em um formato que alguém possa inspecionar depois.</li></ol><p>As organizações mais bem-sucedidas nesse ponto já tinham investido pesado em testes automatizados, análise estática e conjuntos de mudanças pequenos. Ou seja, as camadas funcionam melhor sobre uma base que a equipe já tem. <a href="#artigos-citados-neste-texto">[4]</a></p><p><img alt="Sistema de revisão em níveis que diferencia mudanças de baixo risco, que exigem só uma revisão leve, de mudanças de alto risco, que exigem análise completa." src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1790211692/ykdvpza0q3jqb9joctqg.png" /></p><h2 id="conheça-o-playbook-ou-contribua-com-seus-próprios-insights">Conheça o playbook ou contribua com seus próprios insights</h2><p>Tornar-se nativo em IA é uma prática que líderes vão continuar refinando com suas equipes à medida que as ferramentas e o entendimento evoluem. Para dar o primeiro passo, <a href="https://about.gitlab.com/pt-br/ai-native-playbook/" rel="">leia o playbook completo</a> ou comece pela parte que corresponde ao ponto em que sua equipe encontra mais atrito:</p><ul><li><a href="https://about.gitlab.com/pt-br/ai-native-playbook/topics/redesigning-the-work/" rel="">Redesenhar o trabalho</a>, para que os agentes façam parte do fluxo de entrega, em vez de serem acoplados a etapas pensadas só para pessoas</li><li><a href="https://about.gitlab.com/pt-br/ai-native-playbook/topics/working-with-agents/" rel="">Trabalhar com agentes</a>, decidindo onde o julgamento e a responsabilidade humanos permanecem e como os profissionais de engenharia continuam a crescer à medida que a programação muda</li><li><a href="https://about.gitlab.com/pt-br/ai-native-playbook/topics/governing-and-scaling/" rel="">Governar e escalar</a> de um fluxo de trabalho para muitos, com o contexto, a verificação e a medição que permitem avançar mais rápido sem perder o controle da qualidade ou do risco</li></ul><blockquote><p>Se você lidera uma equipe de engenharia e quer contribuir com seus insights para o playbook, <a href="https://selfcommunity.co/" rel="">participe do SELF, a comunidade de líderes de engenharia que estão navegando pela era da IA</a>.</p></blockquote><h2 id="artigos-citados-neste-texto">Artigos citados neste texto</h2><ol><li>Cochran, Timothy, and Bryan Finster, Tim Ottersburg, Scott Prugh, and Amy Willard. &quot;When Coding Is Free, Where Is the Bottleneck? A Guide for Leaders Building Agent-Ready Delivery Systems.&quot; <em>Enterprise Technology Leadership Journal</em> 3, no. 2 (Fall 2026). <a href="https://itrevolution.com/product/when-coding-is-free/" rel="">https://itrevolution.com/product/when-coding-is-free/</a>.</li><li>Cockcroft, Adrian, and Jeremy Eder, Joseph Enochs, Jenn Spykerman, and Brian Wald. &quot;When Agents Decide: Continuous Decision Intelligence and the Substrate Beneath It.&quot; <em>Enterprise Technology Leadership Journal</em> 3, no. 2 (Fall 2026). <a href="https://itrevolution.com/product/when-agents-decide/" rel="">https://itrevolution.com/product/when-agents-decide/</a>.</li><li>Eslick, Ian, and Collin Fox, Amanda Graham, Suzette Johnson, Chuck Lafferty, Tom Kilcommons, Rosalind Radcliffe, Cat Swetel, Annie Vella, Sam Yeats, and Robin Yeman. &quot;The Sociotechnical Architecture of AI-Enabled Enterprises: Principles, Patterns, and Practices for Human-Governed AI.&quot; <em>Enterprise Technology Leadership Journal</em> 3, no. 2 (Fall 2026). <a href="https://itrevolution.com/product/sociotechnical-architecture-of-ai-enabled-enterprises/" rel="">https://itrevolution.com/product/sociotechnical-architecture-of-ai-enabled-enterprises/</a>.</li><li>Davis, Zach, and Michelle Gill, Elisabeth Hendrickson, Angie Jones, Sha Ma, Randy Shoup, and James Wickett. &quot;Agentic AI and Code Reviews: Toward a Pattern Language for Code Reviews in the Age of Agentic AI.&quot; <em>Enterprise Technology Leadership Journal</em> 3, no. 2 (Fall 2026). <a href="https://itrevolution.com/product/agentic-ai-and-code-reviews/" rel="">https://itrevolution.com/product/agentic-ai-and-code-reviews/</a>.</li></ol>]]></content>
        <author>
            <name>Chandler Gibbons</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/chandler-gibbons/</uri>
        </author>
        <published>2026-10-20T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Primeiros passos com o GitLab: domine a gestão de projetos]]></title>
        <id>https://about.gitlab.com/pt-br/blog/getting-started-with-gitlab-mastering-project-management/</id>
        <link href="https://about.gitlab.com/pt-br/blog/getting-started-with-gitlab-mastering-project-management/"/>
        <updated>2026-10-19T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p><em>Bem-vindo(a) à nossa série &quot;Primeiros passos com o GitLab&quot;, em que ajudamos quem está iniciando agora a se familiarizar com a plataforma DevSecOps do GitLab.</em></p><p>O GitLab é muito mais do que um lugar para guardar código. É uma plataforma DevSecOps com inteligência artificial, que reúne ferramentas para planejar, organizar, acompanhar e entregar projetos com sucesso. Neste artigo, apresentamos os principais recursos de gestão de projetos do GitLab e mostramos como aproveitá-los da melhor forma.</p><h2 id="por-que-usar-o-gitlab-na-gestão-de-projetos">Por que usar o GitLab na gestão de projetos?</h2><p>Imagine ter o repositório de código, o gerenciador de issues e a plataforma de comunicação totalmente integrados, em um só lugar. Neste caso, o GitLab faz a diferença. Com tudo centralizado, fica mais simples otimizar o fluxo de trabalho, melhorar a colaboração e fazer os projetos avançarem. Chega de pular de uma ferramenta para outra e perder informações pelo caminho: o GitLab reúne tudo e facilita a gestão dos projetos do início ao fim.</p><h2 id="os-componentes-principais-da-gestão-de-projetos-no-gitlab">Os componentes principais da gestão de projetos no GitLab</h2><p>Vamos por partes:</p><ul><li><a href="https://docs.gitlab.com/user/group/epics/" rel="">Épicos</a>: pense nos épicos como um panorama geral de um projeto. Eles representam grandes funcionalidades, objetivos amplos ou iniciativas de longo prazo dentro do projeto. Precisa reformular o site? Isso é um épico! Os épicos ajudam a organizar o trabalho em partes maiores e gerenciáveis.</li><li><a href="https://docs.gitlab.com/user/project/issues/" rel="">Issues</a>: as issues são as tarefas individuais, ou itens de trabalho, que contribuem para os objetivos do projeto. Cada issue representa uma ação específica, como &quot;criar o design da página inicial&quot; ou &quot;escrever a página &#39;Quem somos&#39;&quot;. As issues são os alicerces do projeto e oferecem uma forma clara de acompanhar cada tarefa.</li><li><a href="https://docs.gitlab.com/user/project/labels/" rel="">Labels</a>: as labels funcionam como tags que ajudam a categorizar e filtrar o trabalho. Com elas, dá para indicar prioridade (por exemplo, alta, média, baixa), status (por exemplo, a fazer, em andamento, concluído) ou atribuir issues a equipes ou pessoas específicas. As labels são uma forma flexível de organizar e priorizar o trabalho.</li><li>Quadros: os quadros de issues do GitLab são o espaço de trabalho visual da equipe. Eles oferecem uma visão do projeto no estilo Kanban e permitem ver de relance o status de todas as issues. Basta arrastar e soltar as issues entre listas (por exemplo, &quot;A fazer&quot;, &quot;Em andamento&quot;, &quot;Concluído&quot;) para visualizar o fluxo de trabalho e acompanhar o andamento. No GitLab, é possível criar quadros para <a href="https://docs.gitlab.com/user/project/issue_board/" rel="">issues</a> e para <a href="https://docs.gitlab.com/user/group/epics/epic_boards/" rel="">épicos</a> (estes, nos planos Premium e Ultimate).</li><li><a href="https://docs.gitlab.com/user/project/milestones/" rel="">Marcos</a>: os marcos indicam pontos de controle importantes ou datas-alvo dentro do projeto. Eles ajudam a acompanhar o andamento em direção a objetivos e prazos específicos. Por exemplo, pode haver marcos para a conclusão de uma funcionalidade importante, a liberação de uma versão beta ou o lançamento do produto final.</li><li><a href="https://docs.gitlab.com/user/tasks/" rel="">Tasks</a>: para as etapas mais granulares, as issues podem ser divididas em tasks, que são tarefas menores. Isso ajuda na delegação, deixa claras as responsabilidades individuais e garante que nada passe despercebido. As tasks ficam vinculadas às issues como subitens; para listas mais simples, também é possível usar um checklist na própria descrição da issue. As duas opções facilitam o acompanhamento de tarefas complexas.</li></ul><h2 id="os-recursos-em-detalhes">Os recursos em detalhes</h2><h3 id="_1-épicos-enxergar-o-panorama-geral">1. Épicos: enxergar o panorama geral</h3><p><em>Épicos e roadmaps estão disponíveis nos planos Premium e Ultimate.</em></p><ul><li>Criação de épicos: no grupo, acesse o menu &quot;Epics&quot; em &quot;Plan&quot;. Clique em <strong>New epic</strong> e dê ao épico um título descritivo e uma descrição clara do objetivo. Também dá para definir as datas de início e de término do épico, o que é útil para quem usa <a href="https://docs.gitlab.com/user/group/roadmap/" rel="">roadmaps</a>.</li></ul><p><img alt="Página de criação de épico" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097301/Blog/Content%20Images/Blog/Content%20Images/image1_aHR0cHM6_1750097300817.png" /></p><ul><li><a href="https://docs.gitlab.com/user/group/roadmap/" rel="">Roadmaps</a>: adicione os épicos a um roadmap para visualizar a linha do tempo do projeto e os objetivos de longo prazo. O roadmap oferece uma visão de cima do plano do projeto, o que ajuda a olhar o todo e a acompanhar o andamento em direção aos grandes marcos.</li></ul><p><img alt="Visualização do roadmap" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097301/Blog/Content%20Images/Blog/Content%20Images/image8_aHR0cHM6_1750097300818.png" /></p><h3 id="_2-issues-fazer-acontecer">2. Issues: fazer acontecer</h3><ul><li>Criação de issues: no projeto, acesse o menu &quot;Issues&quot; em &quot;Plan&quot; e clique em <strong>New issue</strong>. Dê à issue um título conciso e descritivo, como &quot;Criar os wireframes da página inicial&quot;, atribua a issue a uma pessoa da equipe, defina um prazo e adicione uma descrição detalhada com os requisitos da tarefa.</li><li>GitLab Duo: com o <a href="https://docs.gitlab.com/user/project/issues/managing_issues/#populate-an-issue-with-issue-description-generation" rel="">GitLab Duo, é possível gerar descrições detalhadas de issues</a> a partir de uma breve indicação do que se quer alcançar.</li><li>Pesos: estime o esforço de cada issue atribuindo diferentes pesos, recurso disponível nos planos Premium e Ultimate. Isso ajuda no planejamento e na priorização. Uma tarefa simples, por exemplo, pode ter peso <strong>1</strong>, enquanto uma tarefa mais complexa pode ter peso <strong>5</strong>.</li></ul><p><img alt="Issue com peso 4 atribuído" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097301/Blog/Content%20Images/Blog/Content%20Images/image4_aHR0cHM6_1750097300819.png" /></p><h3 id="_3-labels-organizar-o-trabalho">3. Labels: organizar o trabalho</h3><ul><li>Criação de labels: na aba &quot;Issues&quot; do projeto, clique em Labels. Crie labels personalizadas, com nomes claros, para categorizar as issues. Por exemplo: <strong>Prioridade: Alta</strong>, <strong>Status: Em andamento</strong> ou <strong>Equipe: Design</strong>. Depois, aplique essas labels às issues para mantê-las organizadas e fáceis de filtrar.</li></ul><p><img alt="Tela de labels" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097301/Blog/Content%20Images/Blog/Content%20Images/image6_aHR0cHM6_1750097300820.png" /></p><h3 id="_4-quadros-visualizar-o-fluxo-de-trabalho">4. Quadros: visualizar o fluxo de trabalho</h3><ul><li>Quadros Kanban: os quadros do GitLab oferecem uma visão do projeto no estilo Kanban. Crie listas como &quot;A fazer&quot;, &quot;Em andamento&quot; e &quot;Concluído&quot; para representar as etapas do fluxo de trabalho e arraste as issues entre elas para visualizar o andamento.</li><li>Personalização: adapte os quadros ao fluxo de trabalho da equipe. Adicione mais colunas, filtre as issues por labels ou responsáveis e configure raias (<em>swimlanes</em>) para agrupar as issues por épicos ou outros critérios.</li></ul><p><img alt="Fluxo de trabalho visualizado em quadros de issues" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097301/Blog/Content%20Images/Blog/Content%20Images/image2_aHR0cHM6_1750097300820.png" /></p><h3 id="_5-tasks-dividir-o-trabalho">5. Tasks: dividir o trabalho</h3><ul><li>Criação de tasks: as tasks dividem uma issue em etapas menores. Na issue &quot;Criar os wireframes da página inicial&quot;, por exemplo, as tasks poderiam ser &quot;Esboçar os conceitos iniciais&quot;, &quot;Criar os wireframes digitais&quot; e &quot;Coletar feedback dos stakeholders&quot;. Para criar uma task, clique no botão <strong>Add</strong> na seção &quot;Child Items&quot; da página da issue. Em seguida, digite o título da task e clique em <strong>Create Task</strong>.</li><li>Checklists: para listas mais simples, use a sintaxe de checklist em markdown na descrição da issue. Cada item da lista representa uma etapa menor dentro da issue.</li></ul><p><img alt="Issue com o botão de criação de task" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097301/Blog/Content%20Images/Blog/Content%20Images/image7_aHR0cHM6_1750097300822.png" /></p><h3 id="_6-marcos-acompanhar-o-andamento">6. Marcos: acompanhar o andamento</h3><ul><li>Definição de marcos: defina marcos para sinalizar pontos importantes do projeto, como a conclusão de uma funcionalidade específica ou um prazo-chave. Dê aos marcos títulos claros e prazos.</li><li>Associação com issues: vincule issues e épicos aos marcos para acompanhar o andamento em direção a esses objetivos. Assim, fica fácil ver como cada tarefa contribui para o plano geral do projeto.</li><li>Criação de um marco: no menu suspenso &quot;Plan&quot;, clique em <strong>Milestones &gt; New milestone</strong>. Informe o título, a descrição e as datas de início e de término do marco.</li></ul><p><img alt="Tela de novo marco" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097301/Blog/Content%20Images/Blog/Content%20Images/image5_aHR0cHM6_1750097300823.png" /></p><p><br /><br /></p><p><img alt="Nova página com o marco criado" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097301/Blog/Content%20Images/Blog/Content%20Images/image3_aHR0cHM6_1750097300823.png" /></p><h3 id="_7-iterações-trabalhar-em-sprints">7. <a href="https://docs.gitlab.com/user/group/iterations/" rel="">Iterações</a>: trabalhar em sprints</h3><p><em>As iterações estão disponíveis nos planos Premium e Ultimate.</em></p><ul><li>Definição de iterações: em um fluxo de trabalho ágil, defina iterações (sprints) com datas de início e de término específicas. Isso ajuda a dividir o trabalho em janelas de tempo menores e mais gerenciáveis.</li><li>Atribuição de issues: atribua issues às iterações para planejar o trabalho em ciclos mais curtos e se concentrar na entrega de valor incremental.</li></ul><h3 id="_8-controle-de-tempo-medir-o-esforço">8. <a href="https://docs.gitlab.com/user/project/time_tracking/" rel="">Controle de tempo</a>: medir o esforço</h3><ul><li>Registro de tempo: dentro de uma issue, use a quick action <code>/spend</code> seguida do tempo gasto (por exemplo, <code>/spend 2h 30m</code>) para registrar o trabalho. Assim, você acompanha o tempo real dedicado a cada tarefa.</li><li>Análise dos dados: gere relatórios de controle de tempo para entender o andamento do projeto e a eficiência da equipe, além de identificar possíveis gargalos.</li></ul><p><img alt="Relatório de controle de tempo" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1750097301/Blog/Content%20Images/Blog/Content%20Images/image9_aHR0cHM6_1750097300824.png" /></p><h3 id="_9-dependências-gerenciar-o-fluxo-de-trabalho">9. Dependências: gerenciar o fluxo de trabalho</h3><p><em>As relações de bloqueio entre issues estão disponíveis nos planos Premium e Ultimate.</em></p><ul><li><a href="https://docs.gitlab.com/user/project/issues/related_issues/" rel="">Vinculação de issues</a>: crie dependências entre issues para garantir que as tarefas sejam concluídas na ordem certa. Se a issue A precisa ser concluída antes de a issue B começar, por exemplo, basta criar uma dependência entre elas. Isso ajuda a visualizar o fluxo de trabalho e a evitar possíveis obstáculos.</li></ul><h3 id="_10-templates-simplificar-a-criação-de-issues">10. Templates: simplificar a criação de issues</h3><ul><li><a href="https://docs.gitlab.com/user/project/description_templates/" rel="">Criação de templates</a>: crie templates de issues para padronizar as informações registradas em tarefas recorrentes, o que economiza tempo e garante consistência. Um template para relatar bugs, por exemplo, pode incluir campos para os passos de reprodução, o comportamento esperado e o comportamento real.</li></ul><h2 id="colaboração-é-essencial">Colaboração é essencial</h2><p>O GitLab favorece a colaboração com os seguintes recursos:</p><ul><li><a href="https://docs.gitlab.com/user/discussions/" rel="">Comentários</a>: discuta issues e épicos diretamente no GitLab. Use os comentários para compartilhar atualizações, tirar dúvidas e dar feedback.</li><li><a href="https://docs.gitlab.com/user/discussions/#mentions" rel="">Menções</a>: use <strong>@</strong> para mencionar pessoas da equipe e avisá-las sobre atualizações ou pedir a opinião delas.</li><li>Discussões: participe de discussões em threads dentro de issues e épicos para trocar ideias, resolver problemas em conjunto e manter todos informados.</li></ul><h2 id="vamos-começar">Vamos começar?</h2><p>Agora que você já conhece o potencial dos recursos de gestão de projetos do GitLab, é hora de colocá-los em prática! Crie um projeto de teste, experimente os diferentes recursos e descubra como o GitLab pode transformar o fluxo de trabalho da equipe. Na documentação do GitLab, também há mais informações sobre como o GitLab ajuda a adotar <a href="https://docs.gitlab.com/tutorials/kanban/" rel="">Kanban</a> e <a href="https://docs.gitlab.com/tutorials/scrum_events/" rel="">Scrum</a>.</p><blockquote><h4 id="quer-levar-seu-aprendizado-para-o-próximo-nível-inscreva-se-nos-cursos-da-gitlab-university-ou-comece-agora-mesmo-com-um-teste-gratuito-do-gitlab-ultimate">Quer levar seu aprendizado para o próximo nível? <a href="https://university.gitlab.com/" rel="">Inscreva-se nos cursos da GitLab University</a>. Ou comece agora mesmo com um <a href="https://about.gitlab.com/pt-br/free-trial/" rel="">teste gratuito do GitLab Ultimate</a>.</h4></blockquote><h2 id="série-primeiros-passos-com-o-gitlab">Série &quot;Primeiros passos com o GitLab&quot;</h2><p>Confira mais artigos da nossa série &quot;Primeiros passos com o GitLab&quot;:</p><ul><li><a href="https://about.gitlab.com/blog/getting-started-with-gitlab-how-to-manage-users/" rel="">Como gerenciar usuários</a></li><li><a href="https://about.gitlab.com/blog/getting-started-with-gitlab-how-to-import-your-projects-to-gitlab/" rel="">Como importar seus projetos para o GitLab</a></li><li><a href="https://about.gitlab.com/blog/automating-agile-workflows-with-the-gitlab-triage-gem/" rel="">Automatizando fluxos de trabalho ágeis com a gem gitlab-triage</a></li><li><a href="https://about.gitlab.com/pt-br/blog/getting-started-with-gitlab-understanding-ci-cd/" rel="">Entenda o CI/CD</a></li><li><a href="https://about.gitlab.com/blog/getting-started-with-gitlab-working-with-ci-cd-variables/" rel="">Trabalhando com variáveis de CI/CD</a></li></ul>]]></content>
        <author>
            <name>GitLab</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/gitlab/</uri>
        </author>
        <published>2026-10-19T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Guia completo de Container Scanning do GitLab]]></title>
        <id>https://about.gitlab.com/pt-br/blog/complete-guide-to-gitlab-container-scanning/</id>
        <link href="https://about.gitlab.com/pt-br/blog/complete-guide-to-gitlab-container-scanning/"/>
        <updated>2026-10-19T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>As vulnerabilidades em contêineres não esperam o próximo deploy. Elas podem surgir a qualquer momento: na criação de uma imagem ou com os contêineres já em execução em produção. Para lidar com essa realidade, o GitLab oferece diferentes abordagens de varredura de contêineres, cada uma pensada para uma etapa do ciclo de vida do contêiner.</p><p>Neste guia, você vai conhecer os tipos de varredura de contêineres disponíveis no GitLab, como ativar cada um e as configurações mais comuns para começar.</p><h2 id="por-que-a-varredura-de-contêineres-é-importante">Por que a varredura de contêineres é importante</h2><p>Vulnerabilidades em imagens de contêiner geram riscos ao longo de todo o ciclo de vida da aplicação. Imagens base, pacotes do sistema operacional e dependências da aplicação podem conter vulnerabilidades que atacantes exploram ativamente. A varredura de contêineres detecta esses riscos cedo, antes que cheguem à produção, e indica caminhos de correção quando eles existem.</p><p>Explicando melhor: a varredura de contêineres é um componente essencial da Análise de Composição de Software (SCA, na sigla em inglês) e ajuda a entender e proteger as dependências externas que sustentam as aplicações em contêineres.</p><h2 id="os-cinco-tipos-de-gitlab-container-scanning">Os cinco tipos de GitLab Container Scanning</h2><p>O GitLab oferece cinco abordagens distintas de varredura de contêineres, cada uma com um papel específico na estratégia de segurança.</p><h3 id="_1-pipeline-based-container-scanning">1. Pipeline-based Container Scanning</h3><ul><li>O que faz: faz a varredura de imagens de contêiner durante a execução da <a href="https://about.gitlab.com/pt-br/blog/getting-started-with-gitlab-understanding-ci-cd/" rel="">pipeline de CI/CD</a> e detecta vulnerabilidades antes do deploy</li><li>Indicado para: <a href="https://about.gitlab.com/pt-br/topics/ci-cd/shift-left-devops/" rel="">segurança <em>shift-left</em></a> (levar a segurança para as etapas iniciais do desenvolvimento) e bloqueio de imagens vulneráveis antes que cheguem à produção</li><li>Disponibilidade por plano: Free, Premium e Ultimate (com recursos adicionais no Ultimate)</li><li><a href="https://docs.gitlab.com/user/application_security/container_scanning/" rel="">Documentação</a></li></ul><p>O GitLab usa o scanner de segurança Trivy para analisar imagens de contêiner em busca de vulnerabilidades conhecidas. A cada execução da pipeline, o scanner examina as imagens e gera um relatório detalhado.</p><h4 id="como-ativar-o-pipeline-based-container-scanning">Como ativar o Pipeline-based Container Scanning</h4><p><strong>Opção A: merge request pré-configurada</strong></p><ul><li>Acesse <strong>Secure &gt; Security configuration</strong> no projeto.</li><li>Localize a linha &quot;Container Scanning&quot;.</li><li>Selecione <strong>Configure with a merge request</strong>.</li><li>Isso cria automaticamente uma merge request com a configuração necessária.</li></ul><p><strong>Opção B: configuração manual</strong></p><ul><li>Adicione o seguinte ao arquivo <code>.gitlab-ci.yml</code>:</li></ul><pre className="language-yaml shiki shiki-themes github-light" code="include:
  - template: Jobs/Container-Scanning.gitlab-ci.yml
" language="yaml" meta="" style=""><code><span class="line" line="1"><span class="shJU0">include</span><span class="sgsFI">:
</span></span><span class="line" line="2"><span class="sgsFI">  - </span><span class="shJU0">template</span><span class="sgsFI">: </span><span class="sYBdl">Jobs/Container-Scanning.gitlab-ci.yml
</span></span></code></pre><h4 id="configurações-comuns">Configurações comuns</h4><p><strong>Varredura de uma imagem específica:</strong></p><p>Para fazer a varredura de uma imagem específica, sobrescreva a variável <code>CS_IMAGE</code> no job <code>container_scanning</code>.</p><pre className="language-yaml shiki shiki-themes github-light" code="include:
  - template: Jobs/Container-Scanning.gitlab-ci.yml

container_scanning:
  variables:
    CS_IMAGE: myregistry.com/myapp:latest
" language="yaml" meta="" style=""><code><span class="line" line="1"><span class="shJU0">include</span><span class="sgsFI">:
</span></span><span class="line" line="2"><span class="sgsFI">  - </span><span class="shJU0">template</span><span class="sgsFI">: </span><span class="sYBdl">Jobs/Container-Scanning.gitlab-ci.yml
</span></span><span class="line" line="3"><span emptyLinePlaceholder>
</span></span><span class="line" line="4"><span class="shJU0">container_scanning</span><span class="sgsFI">:
</span></span><span class="line" line="5"><span class="shJU0">  variables</span><span class="sgsFI">:
</span></span><span class="line" line="6"><span class="shJU0">    CS_IMAGE</span><span class="sgsFI">: </span><span class="sYBdl">myregistry.com/myapp:latest
</span></span></code></pre><p><strong>Filtrar por nível de severidade:</strong></p><p>Para encontrar apenas vulnerabilidades a partir de um determinado nível de severidade, sobrescreva a variável <code>CS_SEVERITY_THRESHOLD</code> no job <code>container_scanning</code>. No exemplo abaixo, só aparecem vulnerabilidades de severidade <strong>High</strong> ou superior.</p><pre className="language-yaml shiki shiki-themes github-light" code="include:
  - template: Jobs/Container-Scanning.gitlab-ci.yml

container_scanning:
  variables:
    CS_SEVERITY_THRESHOLD: &quot;HIGH&quot;
" language="yaml" meta="" style=""><code><span class="line" line="1"><span class="shJU0">include</span><span class="sgsFI">:
</span></span><span class="line" line="2"><span class="sgsFI">  - </span><span class="shJU0">template</span><span class="sgsFI">: </span><span class="sYBdl">Jobs/Container-Scanning.gitlab-ci.yml
</span></span><span class="line" line="3"><span emptyLinePlaceholder>
</span></span><span class="line" line="4"><span class="shJU0">container_scanning</span><span class="sgsFI">:
</span></span><span class="line" line="5"><span class="shJU0">  variables</span><span class="sgsFI">:
</span></span><span class="line" line="6"><span class="shJU0">    CS_SEVERITY_THRESHOLD</span><span class="sgsFI">: </span><span class="sYBdl">&quot;HIGH&quot;
</span></span></code></pre><h4 id="vulnerabilidades-na-merge-request">Vulnerabilidades na merge request</h4><p>Ver as vulnerabilidades do Container Scanning diretamente nas merge requests torna a revisão de segurança fluida e eficiente. Depois que o Container Scanning é configurado na pipeline de CI/CD, o GitLab exibe automaticamente as vulnerabilidades detectadas no <a href="https://docs.gitlab.com/user/project/merge_requests/widgets/#application-security-scanning" rel="">Security widget</a> da merge request.</p><p><img alt="Vulnerabilidades do Container Scanning exibidas na MR" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1772547514/lt6elcq6jexdhqatdy8l.png" title="Vulnerabilidades do Container Scanning exibidas na MR" /></p><ul><li>Abra qualquer merge request e role até a seção &quot;Security Scanning&quot; para ver um resumo das vulnerabilidades novas e já existentes encontradas nas imagens de contêiner.</li><li>Clique em uma <strong>vulnerabilidade</strong> para ver os detalhes do achado, incluindo o nível de severidade, os pacotes afetados e as orientações de correção disponíveis.</li></ul><p><img alt="Visão de segurança do GitLab na MR" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1772547514/hplihdlekc11uvpfih1p.png" /></p><p><img alt="Detalhes de uma vulnerabilidade do Container Scanning na MR" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1772547513/jnxbe7uld8wfeezboifs.png" title="Detalhes de uma vulnerabilidade do Container Scanning na MR" /></p><p>Com essa visibilidade, desenvolvedores e equipes de segurança conseguem detectar e corrigir vulnerabilidades em contêineres antes que elas cheguem à produção. A segurança passa a fazer parte da revisão de código, em vez de funcionar como uma etapa separada.</p><h4 id="vulnerabilidades-no-vulnerability-report">Vulnerabilidades no Vulnerability Report</h4><p>Além da revisão nas merge requests, o GitLab oferece um <a href="https://docs.gitlab.com/user/application_security/vulnerability_report/" rel="">Vulnerability Report</a> centralizado, que dá às equipes de segurança uma visão abrangente de todos os achados do Container Scanning no projeto.</p><p><img alt="Vulnerability Report filtrado por Container Scanning" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1772547524/gagau279fzfgjpnvipm5.png" title="Vulnerability Report filtrado por Container Scanning" /></p><ul><li>Para acessar o relatório, selecione <strong>Secure &gt; Vulnerability report</strong> na barra lateral do projeto.</li><li>Ali fica reunida uma visão consolidada de todas as vulnerabilidades de contêiner detectadas nas branches, com opções avançadas de filtro por severidade, status, tipo de scanner ou imagem de contêiner específica.</li><li>Clique em uma vulnerabilidade para abrir a página dela.</li></ul><p><img alt="Página da vulnerabilidade – parte 1" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1772547520/e1woxupyoajhrpzrlylj.png" /></p><p><img alt="Página da vulnerabilidade – parte 2" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1772547521/idzcftcgjc8eryixnbjn.png" /></p><p><img alt="Página da vulnerabilidade – parte 3" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1772547522/mbbwbbprtf9anqqola10.png" title="Detalhes de uma vulnerabilidade do Container Scanning" /></p><p>A página <a href="https://docs.gitlab.com/user/application_security/vulnerabilities/" rel="">Vulnerability Details</a> mostra exatamente quais imagens e camadas de contêiner foram afetadas, o que facilita rastrear a vulnerabilidade até a origem. Nela, é possível atribuir vulnerabilidades a pessoas da equipe, alterar o status (detected, confirmed, resolved, dismissed), adicionar comentários para colaborar e vincular issues relacionadas para acompanhar o trabalho de correção.</p><p>Com esse fluxo de trabalho, a gestão de vulnerabilidades deixa de depender de planilhas e passa a fazer parte do processo de desenvolvimento: os achados de segurança em contêineres são acompanhados, priorizados e resolvidos de forma sistemática.</p><h4 id="dependency-list">Dependency List</h4><p>A <a href="https://docs.gitlab.com/user/application_security/dependency_list/" rel="">Dependency List</a> do GitLab oferece uma lista completa de materiais de software (SBOM), que cataloga cada componente das imagens de contêiner e dá total transparência sobre a cadeia de suprimentos de software.</p><ul><li>Acesse <strong>Secure &gt; Dependency list</strong> para ver o inventário de todos os pacotes, bibliotecas e dependências que o Container Scanning detectou no projeto.</li><li>Essa visão é fundamental para entender o que de fato está em execução dentro dos contêineres, dos pacotes do sistema operacional base às dependências da aplicação.</li></ul><p><img alt="Dependency List do GitLab" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1772547513/vjg6dk3nhajqamplroji.png" title="Dependency List do GitLab (SBOM)" /></p><p>Você pode filtrar a lista por gerenciador de pacotes, tipo de licença ou status de vulnerabilidade para identificar rapidamente quais componentes representam riscos de segurança ou problemas de conformidade. Cada dependência mostra as vulnerabilidades associadas, o que permite entender os problemas de segurança no contexto dos componentes reais do software, em vez de tratá-los como achados isolados.</p><h3 id="_2-container-scanning-for-registry">2. Container Scanning for Registry</h3><ul><li>O que faz: faz automaticamente a varredura das imagens com a tag <code>latest</code> enviadas por push ao GitLab Container Registry</li><li>Indicado para: monitoramento contínuo das imagens do registry, sem precisar disparar pipelines manualmente</li><li>Disponibilidade por plano: somente Ultimate</li><li><a href="https://docs.gitlab.com/user/application_security/container_scanning/#container-scanning-for-registry" rel="">Documentação</a></li></ul><p>Quando você faz push de uma imagem de contêiner com a tag <code>latest</code>, o bot de políticas de segurança do GitLab dispara automaticamente uma varredura na branch padrão. Diferentemente da varredura baseada em pipeline, essa abordagem trabalha em conjunto com o Continuous Vulnerability Scanning para monitorar novos boletins de segurança publicados.</p><h4 id="como-ativar-o-container-scanning-for-registry">Como ativar o Container Scanning for Registry</h4><ol><li>Acesse <strong>Secure &gt; Security configuration</strong>.</li><li>Role até a seção <strong>Container Scanning For Registry</strong>.</li><li>Ative o recurso.</li></ol><p><img alt="Container Scanning for Registry" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1772547512/vntrlhtmsh1ecnwni5ji.png" title="Opção para ativar o Container Scanning for Registry" /></p><h4 id="pré-requisitos">Pré-requisitos</h4><ul><li>Papel de Maintainer ou superior no projeto</li><li>O projeto não pode estar vazio (é preciso ao menos um commit na branch padrão)</li><li>As notificações do Container Registry precisam estar configuradas</li><li>O Package Metadata Database precisa estar configurado (ativado por padrão no GitLab.com)</li></ul><p>As vulnerabilidades aparecem na aba <strong>Container Registry vulnerabilities</strong> do Vulnerability Report.</p><h3 id="_3-multi-container-scanning">3. Multi-Container Scanning</h3><ul><li>O que faz: faz a varredura de várias imagens de contêiner em paralelo, em uma única pipeline</li><li>Indicado para: arquiteturas de microsserviços e projetos com várias imagens de contêiner</li><li>Disponibilidade por plano: Free, Premium e Ultimate (atualmente em Beta)</li><li><a href="https://docs.gitlab.com/user/application_security/container_scanning/multi_container_scanning/" rel="">Documentação</a></li></ul><p>O Multi-Container Scanning usa pipelines filhas dinâmicas para executar as varreduras simultaneamente, o que reduz de forma significativa o tempo total de execução da pipeline quando é preciso fazer a varredura de várias imagens.</p><h4 id="como-ativar-o-multi-container-scanning">Como ativar o Multi-Container Scanning</h4><ol><li>Crie um arquivo <code>.gitlab-multi-image.yml</code> na raiz do repositório:</li></ol><pre className="language-yaml shiki shiki-themes github-light" code="scanTargets:
  - name: alpine
    tag: &quot;3.19&quot;
  - name: python
    tag: &quot;3.9-slim&quot;
  - name: nginx
    tag: &quot;1.25&quot;
" language="yaml" meta="" style=""><code><span class="line" line="1"><span class="shJU0">scanTargets</span><span class="sgsFI">:
</span></span><span class="line" line="2"><span class="sgsFI">  - </span><span class="shJU0">name</span><span class="sgsFI">: </span><span class="sYBdl">alpine
</span></span><span class="line" line="3"><span class="shJU0">    tag</span><span class="sgsFI">: </span><span class="sYBdl">&quot;3.19&quot;
</span></span><span class="line" line="4"><span class="sgsFI">  - </span><span class="shJU0">name</span><span class="sgsFI">: </span><span class="sYBdl">python
</span></span><span class="line" line="5"><span class="shJU0">    tag</span><span class="sgsFI">: </span><span class="sYBdl">&quot;3.9-slim&quot;
</span></span><span class="line" line="6"><span class="sgsFI">  - </span><span class="shJU0">name</span><span class="sgsFI">: </span><span class="sYBdl">nginx
</span></span><span class="line" line="7"><span class="shJU0">    tag</span><span class="sgsFI">: </span><span class="sYBdl">&quot;1.25&quot;
</span></span></code></pre><ol start="2"><li>Inclua o template no <code>.gitlab-ci.yml</code>:</li></ol><pre className="language-yaml shiki shiki-themes github-light" code="include:
  - template: Jobs/Multi-Container-Scanning.latest.gitlab-ci.yml
" language="yaml" meta="" style=""><code><span class="line" line="1"><span class="shJU0">include</span><span class="sgsFI">:
</span></span><span class="line" line="2"><span class="sgsFI">  - </span><span class="shJU0">template</span><span class="sgsFI">: </span><span class="sYBdl">Jobs/Multi-Container-Scanning.latest.gitlab-ci.yml
</span></span></code></pre><h4 id="configuração-avançada">Configuração avançada</h4><p><strong>Varredura de imagens de registries privados:</strong></p><pre className="language-yaml shiki shiki-themes github-light" code="auths:
  registry.gitlab.com:
    username: ${CI_REGISTRY_USER}
    password: ${CI_REGISTRY_PASSWORD}

scanTargets:
  - name: registry.gitlab.com/private/image
    tag: latest
" language="yaml" meta="" style=""><code><span class="line" line="1"><span class="shJU0">auths</span><span class="sgsFI">:
</span></span><span class="line" line="2"><span class="shJU0">  registry.gitlab.com</span><span class="sgsFI">:
</span></span><span class="line" line="3"><span class="shJU0">    username</span><span class="sgsFI">: </span><span class="sYBdl">${CI_REGISTRY_USER}
</span></span><span class="line" line="4"><span class="shJU0">    password</span><span class="sgsFI">: </span><span class="sYBdl">${CI_REGISTRY_PASSWORD}
</span></span><span class="line" line="5"><span emptyLinePlaceholder>
</span></span><span class="line" line="6"><span class="shJU0">scanTargets</span><span class="sgsFI">:
</span></span><span class="line" line="7"><span class="sgsFI">  - </span><span class="shJU0">name</span><span class="sgsFI">: </span><span class="sYBdl">registry.gitlab.com/private/image
</span></span><span class="line" line="8"><span class="shJU0">    tag</span><span class="sgsFI">: </span><span class="sYBdl">latest
</span></span></code></pre><p><strong>Incluir informações de licença:</strong></p><pre className="language-yaml shiki shiki-themes github-light" code="includeLicenses: true

scanTargets:
  - name: postgres
    tag: &quot;15-alpine&quot;
" language="yaml" meta="" style=""><code><span class="line" line="1"><span class="shJU0">includeLicenses</span><span class="sgsFI">: </span><span class="sYu0t">true
</span></span><span class="line" line="2"><span emptyLinePlaceholder>
</span></span><span class="line" line="3"><span class="shJU0">scanTargets</span><span class="sgsFI">:
</span></span><span class="line" line="4"><span class="sgsFI">  - </span><span class="shJU0">name</span><span class="sgsFI">: </span><span class="sYBdl">postgres
</span></span><span class="line" line="5"><span class="shJU0">    tag</span><span class="sgsFI">: </span><span class="sYBdl">&quot;15-alpine&quot;
</span></span></code></pre><h3 id="_4-continuous-vulnerability-scanning">4. Continuous Vulnerability Scanning</h3><ul><li>O que faz: cria vulnerabilidades automaticamente quando novos boletins de segurança são publicados, sem precisar de pipeline</li><li>Indicado para: monitoramento proativo de segurança entre um deploy e outro</li><li>Disponibilidade por plano: somente Ultimate</li><li><a href="https://docs.gitlab.com/user/application_security/continuous_vulnerability_scanning/" rel="">Documentação</a></li></ul><p>A varredura tradicional só detecta vulnerabilidades no momento em que é executada. E é justamente aí que surge a dúvida: o que acontece quando um novo CVE é publicado amanhã para um pacote que passou pela varredura ontem? O Continuous Vulnerability Scanning resolve essa questão monitorando o GitLab Advisory Database e criando automaticamente registros de vulnerabilidade quando novos boletins afetam os componentes do projeto.</p><h4 id="como-funciona">Como funciona</h4><ol><li>O job de Container Scanning ou de Dependency Scanning gera um SBOM no formato CycloneDX.</li><li>O GitLab registra os componentes do projeto a partir desse SBOM.</li><li>Quando novos boletins de segurança são publicados, o GitLab confere se algum desses componentes foi afetado.</li><li>As vulnerabilidades são criadas automaticamente no relatório de vulnerabilidades.</li></ol><h4 id="considerações-importantes">Considerações importantes</h4><ul><li>As varreduras rodam em jobs em segundo plano (Sidekiq), não em pipelines de CI.</li><li>Somente boletins publicados nos últimos 14 dias são considerados na detecção de novos componentes.</li><li>O nome de scanner exibido nessas vulnerabilidades é &quot;GitLab SBoM Vulnerability Scanner&quot;.</li><li>Para marcar vulnerabilidades como resolvidas, ainda é preciso executar uma varredura baseada em pipeline.</li></ul><h3 id="_5-operational-container-scanning">5. Operational Container Scanning</h3><ul><li>O que faz: faz, em uma cadência programada, a varredura dos contêineres em execução no cluster Kubernetes</li><li>Indicado para: monitoramento de segurança após o deploy e detecção de vulnerabilidades em tempo de execução</li><li>Disponibilidade por plano: somente Ultimate</li><li><a href="https://docs.gitlab.com/user/clusters/agent/vulnerabilities/" rel="">Documentação</a></li></ul><p>O Operational Container Scanning preenche a lacuna entre a segurança no momento do build e a segurança em tempo de execução. Com o GitLab agent for Kubernetes, ele faz a varredura dos contêineres que de fato estão em execução nos clusters e detecta vulnerabilidades que surgem depois do deploy.</p><h4 id="como-ativar-o-operational-container-scanning">Como ativar o Operational Container Scanning</h4><p>Se você usa o <a href="https://docs.gitlab.com/user/clusters/agent/install/" rel="">agente do GitLab para Kubernetes</a>, basta adicionar o seguinte ao arquivo de configuração do agente:</p><pre className="language-yaml shiki shiki-themes github-light" code="container_scanning:
  cadence: &#39;0 0 * * *&#39;  # Daily at midnight
  vulnerability_report:
    namespaces:
      include:
        - production
        - staging
" language="yaml" meta="" style=""><code><span class="line" line="1"><span class="shJU0">container_scanning</span><span class="sgsFI">:
</span></span><span class="line" line="2"><span class="shJU0">  cadence</span><span class="sgsFI">: </span><span class="sYBdl">&#39;0 0 * * *&#39;</span><span class="sAwPA">  # Daily at midnight
</span></span><span class="line" line="3"><span class="shJU0">  vulnerability_report</span><span class="sgsFI">:
</span></span><span class="line" line="4"><span class="shJU0">    namespaces</span><span class="sgsFI">:
</span></span><span class="line" line="5"><span class="shJU0">      include</span><span class="sgsFI">:
</span></span><span class="line" line="6"><span class="sgsFI">        - </span><span class="sYBdl">production
</span></span><span class="line" line="7"><span class="sgsFI">        - </span><span class="sYBdl">staging
</span></span></code></pre><p>Também é possível criar uma <a href="https://docs.gitlab.com/user/clusters/agent/vulnerabilities/#enable-via-scan-execution-policies" rel="">política de execução de varredura</a> que faz o agente do GitLab para Kubernetes executar a varredura em uma programação definida.</p><p><img alt="Política de execução de varredura – Operational Container Scanning" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1772547515/gsgvjcq4sas4dfc8ciqk.png" title="Condições da política de execução de varredura para o Operational Container Scanning" /></p><h4 id="resultados">Resultados</h4><ul><li>Acesse <strong>Operate &gt; Kubernetes clusters</strong>.</li><li>Selecione a aba <strong>Agent</strong> e escolha o agente.</li><li>Em seguida, selecione a aba <strong>Security</strong> para ver as vulnerabilidades do cluster.</li><li>Os resultados também aparecem na aba <strong>Operational Vulnerabilities</strong> do <strong>Vulnerability Report</strong>.</li></ul><h2 id="como-reforçar-a-postura-de-segurança-com-as-gitlab-security-policies">Como reforçar a postura de segurança com as GitLab Security Policies</h2><p>As GitLab Security Policies permitem aplicar padrões de segurança consistentes em todos os fluxos de trabalho com contêineres, por meio de controles automatizados baseados em políticas. Essas políticas levam a segurança para as etapas iniciais (<em>shift-left</em>) ao incorporar requisitos diretamente na pipeline de desenvolvimento, para que as vulnerabilidades sejam detectadas e corrigidas antes que o código chegue à produção.</p><h3 id="políticas-de-execução-de-varredura-e-políticas-de-execução-de-pipelines">Políticas de execução de varredura e políticas de execução de pipelines</h3><p>As <a href="https://docs.gitlab.com/user/application_security/policies/scan_execution_policies/" rel="">políticas de execução de varredura</a> automatizam quando e como o Container Scanning é executado nos projetos. É possível definir políticas que disparam a varredura de contêineres em cada merge request, programar varreduras recorrentes da branch principal e muito mais. Assim, a cobertura fica ampla sem depender de cada desenvolvedor configurar a varredura manualmente na pipeline de CI/CD de cada projeto.</p><p>Também dá para especificar as versões do scanner e configurar os parâmetros de varredura de forma centralizada, mantendo a consistência em toda a organização e acompanhando as novas ameaças à segurança de contêineres.</p><p><img alt="Configuração de políticas de execução de varredura" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1772547517/z36dntxslqem9udrynvx.png" title="Configuração de scan execution policy" /></p><p>As <a href="https://docs.gitlab.com/user/application_security/policies/pipeline_execution_policies/" rel="">políticas de execução de pipelines</a> oferecem controles flexíveis para inserir (ou sobrescrever) jobs personalizados em uma pipeline, de acordo com as necessidades de compliance.</p><p>Com elas, você pode inserir automaticamente jobs de varredura de contêineres na pipeline, fazer o build falhar quando as vulnerabilidades de contêiner ultrapassam o nível de risco aceitável, disparar validações de segurança adicionais em branches ou tags específicas e aplicar requisitos de compliance às imagens de contêiner destinadas a ambientes de produção. As políticas de execução de pipelines funcionam como proteções automáticas: garantem que os padrões de segurança sejam aplicados de forma consistente em todos os deploys de contêineres, sem intervenção manual.</p><p><img alt="Políticas de execução de pipelines" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1772547517/ddhhugzcr2swptgodof2.png" title="Ações da política de execução de pipelines" /></p><h3 id="políticas-para-aprovação-de-merge-requests">Políticas para aprovação de Merge Requests</h3><p>As <a href="https://docs.gitlab.com/user/application_security/policies/merge_request_approval_policies/" rel="">políticas para aprovação de Merge Requests</a> funcionam como barreiras de segurança: exigem que aprovadores designados revisem e aprovem as merge requests que contenham vulnerabilidades em contêineres.</p><p>É possível configurar políticas que bloqueiam o merge quando vulnerabilidades de severidade crítica ou alta são detectadas, ou que exigem a aprovação da equipe de segurança para qualquer merge request que introduza novos achados em contêineres. Dessa forma, imagens de contêiner vulneráveis não avançam na pipeline, e o desenvolvimento segue no mesmo ritmo nas mudanças de baixo risco.</p><p><img alt="Política para aprovação de Merge Requests bloqueando a MR" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1772547513/hgnbc1vl4ssqafqcyuzg.png" title="Política para aprovação de Merge Requests bloqueando a MR" /></p><h2 id="como-escolher-a-abordagem-certa">Como escolher a abordagem certa</h2><table><thead><tr><th>Tipo de varredura</th><th>Quando usar</th><th>Principal benefício</th></tr></thead><tbody><tr><td>Pipeline-based</td><td>A cada build</td><td>Segurança <em>shift-left</em>; bloqueia builds vulneráveis</td></tr><tr><td>Registry scanning</td><td>Monitoramento contínuo</td><td>Detecta novos CVEs em imagens armazenadas</td></tr><tr><td>Multi-container</td><td>Microsserviços</td><td>Varredura em paralelo, pipelines mais rápidas</td></tr><tr><td>Continuous vulnerability</td><td>Entre deploys</td><td>Monitoramento proativo de boletins de segurança</td></tr><tr><td>Operational</td><td>Monitoramento em produção</td><td>Detecção de vulnerabilidades em tempo de execução</td></tr></tbody></table><p>Para uma segurança abrangente, vale combinar várias abordagens: a varredura de contêineres baseada em pipelines para detectar problemas durante o desenvolvimento, o Container Scanning for Registry para o monitoramento contínuo e o Operational Container Scanning para ter visibilidade em produção.</p><h2 id="por-onde-começar">Por onde começar</h2><p>O caminho mais rápido para a segurança de contêineres é ativar a varredura baseada em pipeline:</p><ol><li>Acesse <strong>Secure &gt; Security configuration</strong> no projeto.</li><li>Clique em <strong>Configure with a merge request</strong> na linha do Container Scanning.</li><li>Faça o merge da MR gerada.</li><li>A próxima pipeline já vai incluir a varredura de vulnerabilidades.</li></ol><p>A partir daí, você pode adicionar outros tipos de varredura conforme os requisitos de segurança e o plano do GitLab.</p><p>Segurança de contêineres não é uma tarefa pontual, e sim um processo contínuo. Com o conjunto completo de recursos de varredura de contêineres do GitLab, é possível detectar vulnerabilidades em todas as etapas do ciclo de vida do contêiner, do build à execução.</p><blockquote><p>Para saber mais sobre como o GitLab pode ajudar a fortalecer a postura de segurança da sua empresa, acesse a <a href="https://about.gitlab.com/pt-br/solutions/application-security-testing/" rel="">página de soluções de segurança e governança do GitLab</a>.</p></blockquote><style>html pre.shiki code .shJU0, html code.shiki .shJU0{--shiki-default:#22863A}html pre.shiki code .sgsFI, html code.shiki .sgsFI{--shiki-default:#24292E}html pre.shiki code .sYBdl, html code.shiki .sYBdl{--shiki-default:#032F62}html .default .shiki span {color: var(--shiki-default);background: var(--shiki-default-bg);font-style: var(--shiki-default-font-style);font-weight: var(--shiki-default-font-weight);text-decoration: var(--shiki-default-text-decoration);}html .shiki span {color: var(--shiki-default);background: var(--shiki-default-bg);font-style: var(--shiki-default-font-style);font-weight: var(--shiki-default-font-weight);text-decoration: var(--shiki-default-text-decoration);}html pre.shiki code .sYu0t, html code.shiki .sYu0t{--shiki-default:#005CC5}html pre.shiki code .sAwPA, html code.shiki .sAwPA{--shiki-default:#6A737D}</style>]]></content>
        <author>
            <name>Fernando Diaz</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/fernando-diaz/</uri>
        </author>
        <published>2026-10-19T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Faça cada token de IA valer a pena com agentes]]></title>
        <id>https://about.gitlab.com/pt-br/blog/make-every-ai-credit-count/</id>
        <link href="https://about.gitlab.com/pt-br/blog/make-every-ai-credit-count/"/>
        <updated>2026-10-13T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>Os custos se multiplicam a cada tarefa que você passa para um agente de IA. Cada tarefa consome tokens e créditos, e, à medida que os agentes se espalham pelos seus times e automações, o consumo pode crescer mais rápido do que o uso real. Se é você quem roda a plataforma, esse crescimento é de responsabilidade sua — incluindo quais times e fluxos de trabalho causam esse aumento, e se esse uso está realmente virando projetos entregues ou não.</p><p>No <a href="https://about.gitlab.com/pt-br/blog/transcend-india-announcements/" rel="">GitLab Transcend</a>, apresentamos a <a href="https://about.gitlab.com/press/releases/2026-10-06-gitlab-announces-the-foundation-for-the-governed-software-factory/" rel="">fábrica de software governada</a>, a nossa arquitetura para engenharia de software agêntica, e novas funções no GitLab Duo Agent Platform que trazem esse crescimento sob controle. Os <a href="https://about.gitlab.com/pt-br/blog/optimize-with-open-weight-models/" rel="">modelos open-weight gerenciados pelo GitLab</a> alcançaram a mesma taxa de conclusão de tarefas dos modelos de ponta, por uma fração do custo, no benchmark do GitLab — então você pode alinhar o seu modelo à tarefa para melhorar a eficiência de custo do seu time. O <a href="https://docs.gitlab.com/orbit/" rel="">GitLab Orbit</a> dá aos agentes o contexto do ciclo de vida do software, para que tentem menos vezes. O <a href="https://docs.gitlab.com/user/analytics/dap_impact_dashboard/" rel="">Duo Agent Platform Impact Analytics</a> e os <a href="https://about.gitlab.com/pt-br/blog/new-usage-caps-2026/" rel="">limites de créditos</a> mostram para onde os créditos estão indo e colocam um teto nesse gasto.</p><h2 id="controle-os-custos-na-fábrica-de-software-governada">Controle os custos na fábrica de software governada</h2><p>Um total de uso te diz o que você consumiu, mas deixa algumas perguntas difíceis em aberto: quanto do trabalho de rotina caiu em um modelo caro, quantas execuções de agente foram tentativas desperdiçadas, e quais usuários e times consumiram os créditos. Quando o dashboard só mostra tokens, os líderes de plataforma e engenharia acabam discutindo um número que nenhum dos dois lados consegue defender de verdade. Se você não consegue atribuir o uso, definir um limite e cortar o desperdício, não dá para otimizar nem justificar o seu gasto.</p><p>Quebrar esse padrão começa pela arquitetura. A fábrica de software governada é construída em camadas, e o custo cresce exatamente onde essas camadas não se conectam. Duas dessas camadas importam mais para o custo. A primeira é a orquestração de agentes, onde os modelos open weight colocam o trabalho de rotina em modelos de custo mais baixo. A outra é dados e contexto, onde o Orbit, o Duo Agent Platform Impact Analytics e os controles de crédito e uso dão a humanos e agentes o contexto necessário para produzir resultados de alta qualidade pelo menor custo possível.</p><p><img alt="A fábrica de software governada" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791898112/orfryk8astyh236ubwoi.png" title="A fábrica de software governada" /></p><p>Você consegue ver o problema em uma fábrica de software oculta, onde cada etapa tem a sua própria ferramenta, sem política ou contexto compartilhado entre elas. Os agentes gastam tokens procurando contexto em sistemas que nunca foram feitos para se integrar. Uma fábrica de software governada dá aos agentes contexto compartilhado, política compartilhada e um único lugar para medir quanto eles custam. Quando cada crédito de IA conta, você consegue:</p><ul><li><strong>Gastar menos créditos pelo mesmo trabalho:</strong> combine os modelos com a tarefa certa usando modelos open weight, e fundamente os agentes no contexto do ciclo de vida com o GitLab Orbit, para que tentem menos vezes.</li><li><strong>Rastrear o gasto até a origem:</strong> veja os créditos por usuário, time, tarefa e modelo no Duo Agent Platform Impact Analytics e no dashboard de GitLab Credits, para apontar o que gerou o crescimento.</li><li><strong>Definir um teto antes do próximo pico:</strong> limite o uso por usuário com os limites de crédito, com exceções quando necessário, para que os loops de agentes fiquem dentro dos limites que você define.</li></ul><h2 id="adeque-o-modelo-à-tarefa">Adeque o modelo à tarefa</h2><p>O custo dos agentes começa no preço de cada chamada de modelo. O <a href="https://docs.gitlab.com/user/duo_agent_platform/" rel="">GitLab Duo Agent Platform</a> permite fixar um modelo padrão por recurso e controlar o que os seus times podem usar: o seu próprio modelo, self-hosted ou do seu provedor, modelos de ponta gerenciados pelo GitLab, ou <a href="https://about.gitlab.com/pt-br/blog/optimize-with-open-weight-models/" rel="">modelos open-weight gerenciados pelo GitLab</a>, novidade no GitLab 19.4.</p><p><a href="https://about.gitlab.com/blog/optimize-with-open-weight-models" rel="">Três modelos open-weight</a> agora estão hospedados no GitLab Duo Agent Platform: o GLM 5.3, o Kimi K3 e o MiniMax M3. No benchmark interno do GitLab com agentes Duo, o GLM 5.3 igualou a taxa de conclusão de tarefas do Claude Opus 5 a aproximadamente um quinto do custo, o Kimi K3 igualou o Claude Fable 5.1 a um terço do custo, e o MiniMax M3 igualou o GPT-5.5 a um oitavo do custo. A escolha do modelo é uma configuração de administrador. Nas configurações do GitLab Duo do seu grupo de nível superior, abra <strong>Model Selection</strong>, selecione <strong>Manage Models</strong> e fixe um modelo para cada recurso. Por exemplo, fixe o Kimi K3 no Agentic Chat e o MiniMax M3 nos agentes e flows, para que o trabalho de rotina não caia por padrão em um modelo de ponta. Os Group Owners também escolhem quais modelos os seus times podem usar.</p><h2 id="reduza-as-novas-tentativas-com-o-contexto-certo">Reduza as novas tentativas com o contexto certo</h2><p>A escolha do modelo define o preço de cada chamada, e as novas tentativas multiplicam o número de chamadas. O <a href="https://www.gartner.com/en/documents/8052533" rel="">Gartner</a> constatou que um time de 40 desenvolvedores gastou 23 vezes mais com IA porque os agentes ficavam tentando novamente sem as regras e o contexto certos. Os agentes tentam de novo quando não têm contexto. Em um monorepo ou em vários repositórios, um agente passa o primeiro trecho do trabalho vasculhando arquivos para entender o que se conecta com o quê, e cada nova tentativa reenvia toda a janela de contexto.</p><p>O <a href="https://docs.gitlab.com/orbit/remote/getting-started/" rel="">GitLab Orbit</a> mapeia o seu código, itens de trabalho, merge requests, pipelines, implantações e achados de segurança em um único grafo, que se mantém atualizado à medida que os seus times entregam software. Os agentes no GitLab Duo Agent Platform consultam esse grafo nativamente. Agentes externos, como o Claude Code e o Codex, se conectam por meio do Model Context Protocol (MCP), e ferramentas personalizadas se conectam pela API REST. Cada agente vê exatamente o que o seu usuário consegue ver no GitLab.</p><p>Com esse contexto, um agente consulta o grafo e recebe uma resposta precisa, mais rápido e com mais eficiência. Nos <a href="https://about.gitlab.com/blog/introducing-gitlab-orbit/" rel="">testes do GitLab</a>, a mesma tarefa no Claude Code precisou de até 45 vezes menos tentativas repetidas com o Orbit e, em um teste separado, usou 4,5x menos tokens para obter o contexto certo logo na primeira vez. O Orbit está em beta gratuito no GitLab.com hoje e chega à disponibilidade geral no próximo mês, em todas as opções de implantação.</p><h2 id="gerencie-o-que-você-consegue-medir">Gerencie o que você consegue medir</h2><p>Modelos e contexto reduzem o custo de cada tarefa. Os dados de impacto mostram se isso funcionou de verdade. O <a href="https://docs.gitlab.com/user/analytics/dap_impact_dashboard/" rel="">Duo Agent Platform Impact Analytics</a> responde às duas perguntas que os líderes de plataforma fazem: quanto estamos gastando, e onde esse gasto está concentrado? Ele detalha o gasto por <a href="https://gitlab.navattic.com/ai-impact?g=clylc6m40000009jp6k8ldgfd&amp;s=0" rel="">time, tarefa e modelo</a>, para os times e o período que você escolher, e mostra como um modelo open weight se compara com a sua combinação atual de modelos, para que você compare com dados em vez de chutar. O <a href="https://docs.gitlab.com/subscriptions/gitlab_credits_dashboard/" rel="">dashboard de GitLab Credits</a> adiciona mais detalhes abaixo do nível de time, rastreando o uso até o usuário e a sessão por trás dele.</p><p><img alt="Dashboard de GitLab Credits" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791897183/rqejadt1yd2jj3sx4jzz.png" title="Dashboard de GitLab Credits" /></p><p>Visibilidade anda lado a lado com limites. Sem um limite, a única alavanca que sobra é pedir para todo mundo usar menos. Os controles de crédito e uso definem limites no nível da assinatura, do grupo ou do usuário, com alertas em 50%, 80% e 100% do gasto, e uma pausa automática assim que o uso atinge o limite. Um limite fixo por usuário, como 1.000 créditos por usuário/mês, se aplica a todo integrante do time, e uma exceção individual, como 500 créditos adicionais, dá espaço para um engenheiro que está experimentando algo, sem precisar pedir mais créditos. Os limites por usuário entram em vigor assim que um usuário consome os créditos já incluídos no plano, e só o usuário que bateu no limite perde acesso aos recursos que consomem crédito, até o próximo ciclo de cobrança ou até que um administrador aumente o limite.</p><p>O Duo Agent Platform Impact Analytics mostra o consumo de crédito lado a lado com o trabalho que chega à produção, para que você veja se o uso está realmente virando trabalho entregue.</p><p>Veja o Duo Agent Platform Impact Analytics em ação nesta demonstração do nosso evento global Transcend:</p><iframe src="https://player.vimeo.com/video/1233524310?title=0&amp;byline=0&amp;portrait=0&amp;badge=0&amp;autopause=0&amp;player_id=0&amp;app_id=58479" frameBorder="0" allow="autoplay; fullscreen; picture-in-picture; clipboard-write; encrypted-media; web-share" referrerPolicy="strict-origin-when-cross-origin" style="position:absolute;top:0;left:0;width:100%;height:100%;" title="Transcend 3 Dasha Andushkina AI Impact and Cost_100626"></iframe><script src="https://player.vimeo.com/api/player.js"></script><h2 id="coloque-o-controle-de-custo-de-agentes-para-funcionar">Coloque o controle de custo de agentes para funcionar</h2><p>Comece a sua jornada de controle de custo de agentes pelo modelo. Os modelos open-weight gerenciados pelo GitLab já estão disponíveis para todos. No <a href="https://docs.gitlab.com/user/duo_agent_platform/model_selection/" rel="">Model Selection</a>, fixe o GLM 5.3, o Kimi K3 ou o MiniMax M3 para uma carga de trabalho de rotina, como um flow que roda em todo merge request.</p><p>Depois, reduza as tentativas repetidas. O <a href="https://docs.gitlab.com/orbit/" rel="">GitLab Orbit</a> está em beta gratuito no GitLab.com hoje. Ative para o grupo que roda mais sessões de agente. O Orbit chega para todos no próximo mês, em todas as opções de implantação.</p><p>Em seguida, meça e defina limites. O <a href="https://docs.gitlab.com/user/analytics/dap_impact_dashboard/" rel="">Duo Agent Platform Impact Analytics</a> está em <a href="https://gitlab.com/gitlab-org/gitlab/-/work_items/632123" rel="">acesso antecipado</a>, para que você veja o gasto por time, tarefa e modelo. Os controles de crédito e uso já estão disponíveis de forma geral. Defina um <a href="https://docs.gitlab.com/subscriptions/gitlab_credits_dashboard/#set-flat-user-cap-and-per-user-overrides" rel="">limite por usuário para os GitLab Credits</a>, com exceções para os seus usuários mais intensivos. Depois de algumas semanas, compare o uso por time e por modelo com o período anterior.</p><p>Crie a base da sua fábrica de software com o <a href="https://about.gitlab.com/pt-br/gitlab-duo-agent-platform/" rel="">GitLab Duo Agent Platform</a>. Se você é novo no GitLab, comece um <a href="https://about.gitlab.com/pt-br/gitlab-duo-agent-platform/" rel="">teste gratuito</a> do GitLab Duo Agent Platform. Se você já está no Premium ou no Ultimate, <a href="https://docs.gitlab.com/user/duo_agent_platform/turn_on_off/" rel="">ative o GitLab Duo Agent Platform</a> e use os GitLab Credits já incluídos na sua assinatura.</p>]]></content>
        <author>
            <name>Allie Holland</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/allie-holland/</uri>
        </author>
        <published>2026-10-13T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Saiba como a orquestração de agentes do GitLab elimina a espera entre etapas de desenvolvimento]]></title>
        <id>https://about.gitlab.com/pt-br/blog/gitlab-agent-orchestration/</id>
        <link href="https://about.gitlab.com/pt-br/blog/gitlab-agent-orchestration/"/>
        <updated>2026-10-13T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>As ferramentas de programação com IA mudaram a velocidade com que o software é escrito, mas não a velocidade com que ele é entregue. À medida que a geração de código acelera, o gargalo se move para as etapas seguintes: verificação, revisão e entrega. Essas etapas ainda rodam no tempo humano. Enquanto os agentes escrevem correções em minutos, a entrega desacelera por causa de esperas constantes e passagens manuais. Aprovações de revisores, alertas de pipeline, triagem de verificações e prompts passo a passo são exemplos de obstáculos que os times de DevOps enfrentam para manter a entrega no prazo.</p><p>No <a href="https://about.gitlab.com/pt-br/events/transcend/virtual/" rel="">GitLab Transcend</a>, anunciamos novos recursos de orquestração de agentes no <a href="https://about.gitlab.com/pt-br/gitlab-duo-agent-platform/" rel="">GitLab Duo Agent Platform</a> para eliminar essa demora. Os <strong>fluxos orientados por objetivo</strong> pegam o resultado que você define e o levam de ponta a ponta, passando por revisão, testes, verificações de segurança e aprovações, a partir da Duo CLI, do modo headless ou do Agentic Chat. O <strong>GitLab for Slack</strong> inicia o trabalho a partir da conversa onde ele foi solicitado, como transformar uma thread em um issue ou disparar um flow para corrigir um pipeline com falha. O <strong>Custom Flows</strong> permite definir suas próprias sequências de várias etapas e iniciá-las a partir de eventos do GitLab, como uma menção, uma atribuição ou um pipeline. Os três rodam sob a sua identidade, a sua política e a sua cadeia de evidências.</p><h2 id="como-a-orquestração-agêntica-acelera-a-entrega">Como a orquestração agêntica acelera a entrega</h2><p>Um desenvolvimento mais rápido, checklists de processo e agentes de IA para programação em chat único contribuem juntos para atrasos na entrega de software. Com os recursos de orquestração agêntica, você consegue acelerar cada etapa e recuperar tempo para o seu time de desenvolvimento.</p><p><strong>Menos passagens.</strong> Você define o objetivo, e o fluxo continua trabalhando entre revisão, testes, verificações e aprovações, em vez de parar entre cada etapa.</p><p><strong>Comece o trabalho onde se encontra a solicitação.</strong> Uma thread no Slack vira um issue ou um flow imediatamente, a partir de onde você já está discutindo o trabalho.</p><p><strong>Automatize o processo seguido pelo seu time.</strong> O Custom Flows permite definir suas próprias sequências de várias etapas e iniciá-las a partir de uma menção, uma atribuição ou um pipeline.</p><p><strong>Mantenha o controle.</strong> Os flows rodam sob a mesma identidade, política e cadeia de evidências que o restante do GitLab, então a governança continua junto com o trabalho. Os <a href="https://docs.gitlab.com/user/duo_agent_platform/agents/" rel="">agentes e flows fundamentais</a> já cobrem as etapas de planejamento até análise na interface do GitLab, na sua IDE e na Duo CLI, e você pode ativar mais opções a partir do <a href="https://docs.gitlab.com/user/duo_agent_platform/ai_catalog/" rel="">AI Catalog</a>, trazer agentes externos e conectar ferramentas por meio do cliente MCP e do <a href="https://about.gitlab.com/blog/new-mcp-tools-for-automation/" rel="">servidor MCP</a>.</p><h2 id="fluxos-orientados-por-objetivo-defina-o-seu-objetivo">Fluxos orientados por objetivo: defina o seu objetivo</h2><p>Os <a href="https://about.gitlab.com/blog/gitlab-duo-cli-drives-automation/" rel="">fluxos orientados por objetivo</a> dão aos agentes a linha de chegada, em vez da próxima etapa. Você descreve o objetivo e como é o &quot;pronto&quot;, e o flow continua trabalhando até chegar lá. Os fluxos orientados por objetivo automatizam as passagens, então revisão, testes, verificações de segurança e aprovações rodam como uma única sequência conectada.</p><p><img alt="Saída do /goal na Duo CLI" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791553685/v27u5ffzcw3l5qzx8bxs.png" title="Saída do /goal na Duo CLI" /></p><p>Você inicia um flow com o comando <code>/goal</code>, por exemplo:</p><pre className="language-text" code="/goal Fix the checkout timeout. Continue until tests pass and CI is green.
" language="text"><code>/goal Fix the checkout timeout. Continue until tests pass and CI is green.
</code></pre><p>Um modelo separado verifica o trabalho em relação ao seu objetivo a cada etapa, e você pode parar ou redirecionar a execução a qualquer momento. Você pode iniciar um fluxo orientado por objetivo na Duo CLI, no modo headless com <code>duo run --goal</code>, e no Agentic Chat.</p><h2 id="gitlab-for-slack-comece-onde-o-trabalho-já-está-sendo-discutido">GitLab for Slack: comece onde o trabalho já está sendo discutido</h2><p>O <a href="https://docs.gitlab.com/user/project/integrations/gitlab_slack_application/#gitlab-duo" rel="">GitLab for Slack</a> permite iniciar um trabalho no GitLab sem sair do Slack. Mencione @GitLab em qualquer canal ou thread e descreva o que você precisa, como &quot;corrija o pipeline que está falhando&quot;, e um flow começa. O Duo transmite o progresso de volta para a thread, então o seu time acompanha o trabalho onde a conversa já está acontecendo. O flow roda sob a mesma identidade e política de qualquer outro flow do GitLab, então a governança permanece no GitLab. Você também pode usar @GitLab para fazer perguntas sobre a sua base de código ou criar um issue a partir da conversa.</p><p><img alt="Issue do GitLab criado no Slack" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791553685/f1avhyxxexloxt8mafcw.png" title="Issue do GitLab criado no Slack" /></p><h2 id="custom-flows-transforme-o-seu-processo-em-um-flow">Custom Flows: transforme o seu processo em um flow</h2><p>O <a href="https://about.gitlab.com/blog/multi-step-software-delivery-with-agentic-flows/" rel="">Custom Flows</a> encadeia agentes para seguir o processo que o seu time já usa. Você define um flow uma única vez, inicia a partir de eventos do GitLab, como uma menção, uma atribuição ou um pipeline, e o executa dentro dos pipelines de CI/CD. Um pipeline autocorretivo, por exemplo, pode analisar um teste que falhou, gerar uma correção, fazer o commit e avisar o seu time, com supervisão humana nas etapas mais sensíveis. Cada flow roda sob a mesma identidade, política e cadeia de evidências que qualquer outro flow, então a governança permanece no GitLab.</p><h2 id="coloque-a-orquestração-de-agentes-para-funcionar">Coloque a orquestração de agentes para funcionar</h2><p>Aproveite os benefícios da orquestração de agentes começando pelos fluxos orientados por objetivo. A <a href="https://docs.gitlab.com/user/gitlab_duo_cli/use/#slash-commands" rel="">documentação dos comandos de barra da Duo CLI</a> explica o <code>/goal</code> passo a passo. Os fluxos orientados por objetivo estão disponíveis no GitLab.com, no GitLab Self-Managed e no GitLab Dedicated, nos planos Premium e Ultimate, e exigem o GitLab 19.3 ou posterior e a Duo CLI 9.17.0 ou posterior.</p><p>Depois, estenda essa orquestração para os processos e canais do seu time com o <a href="https://docs.gitlab.com/user/duo_agent_platform/flows/custom/" rel="">Custom Flows</a>, que já está disponível de forma geral, e o servidor MCP e o GitLab for Slack, que ficam disponíveis de forma geral ainda este mês.</p><p>Para criar a base da sua fábrica de software, conheça o <a href="https://about.gitlab.com/pt-br/gitlab-duo-agent-platform/" rel="">GitLab Duo Agent Platform</a>. Ainda não usa o GitLab? Comece um <a href="https://about.gitlab.com/pt-br/gitlab-duo-agent-platform/" rel="">teste gratuito do GitLab Duo Agent Platform</a>. Já está no Premium ou no Ultimate? <a href="https://docs.gitlab.com/user/duo_agent_platform/turn_on_off/" rel="">Ative o GitLab Duo Agent Platform</a> e use os GitLab Credits já incluídos na sua assinatura.</p>]]></content>
        <author>
            <name>Elisabeth Burrows</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/elisabeth-burrows/</uri>
        </author>
        <published>2026-10-13T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[GitLab Transcend: Velocidade em que você pode confiar, até a produção]]></title>
        <id>https://about.gitlab.com/pt-br/blog/transcend-india-announcements/</id>
        <link href="https://about.gitlab.com/pt-br/blog/transcend-india-announcements/"/>
        <updated>2026-10-06T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>No GitLab Transcend, fizemos mais de uma dezena de anúncios cobrindo as quatro camadas da nossa arquitetura para engenharia de software agêntica: orquestração de agentes, dados e contexto, fluxos de trabalho de DevOps, e governança e segurança. <a href="https://about.gitlab.com/pt-br/events/transcend/virtual/" rel=""><strong>Assista à gravação</strong></a><strong>, ou continue lendo para saber o que foi lançado e como ativar os novos recursos.</strong></p><h2 id="resumo-geral">Resumo geral</h2><table><thead><tr><th align="left">O que lançamos</th><th align="left">Status do lançamento</th><th align="left">O que faz</th></tr></thead><tbody><tr><td align="left"><a href="https://about.gitlab.com/pt-br/blog/gitlab-duo-cli-drives-automation/" rel="">Fluxos orientados por objetivo</a> (<code>/goal</code>)</td><td align="left">GA neste mês</td><td align="left">Leve uma alteração para revisão, testes, verificações e aprovações, sem esperar entre as etapas do ciclo de vida do software.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/blog/multi-step-software-delivery-with-agentic-flows/" rel="">Custom Flows</a></td><td align="left">GA</td><td align="left">Encadeie agentes para seguir o mesmo processo que os seus times já usam na entrega de software.</td></tr><tr><td align="left"><a href="https://docs.gitlab.com/user/project/integrations/gitlab_slack_application/#gitlab-duo" rel="">GitLab for Slack</a></td><td align="left">GA neste mês</td><td align="left">Inicie um fluxo agêntico a partir dos canais onde os seus times já trabalham.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/blog/new-mcp-tools-for-automation/" rel="">Servidor MCP</a></td><td align="left">GA neste mês</td><td align="left">Conecte ferramentas e aplicações de IA com segurança aos fluxos de trabalho do GitLab, sob a mesma política.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/blog/optimize-with-open-weight-models/" rel="">Modelos open-weight</a></td><td align="left">GA</td><td align="left">Tenha desempenho comparável em cargas de trabalho mais econômicas com os modelos GLM 5.3, Kimi K3 e MiniMax 3, hospedados pelo GitLab.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/gitlab-orbit/" rel="">GitLab Orbit</a></td><td align="left">GA no próximo mês</td><td align="left">Dê aos seus agentes o conhecimento certo, o que exige cerca de 45x menos tentativas, com um grafo de contexto de todo o seu ciclo de vida de software.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/gitlab-duo-agent-platform/" rel="">Duo Agent Platform Impact Analytics</a></td><td align="left">Acesso antecipado</td><td align="left">Meça o custo e o impacto do seu investimento em IA, por time, tarefa e modelo.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/blog/new-usage-caps-2026/" rel="">Controles de crédito e uso</a></td><td align="left">GA</td><td align="left">Defina limites no nível da assinatura, do grupo e do usuário, e envie alertas sobre o gasto com IA.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/blog/transcend-artifact-central/" rel="">GitLab Artifact Central</a></td><td align="left">Beta</td><td align="left">Dê a cada pacote e container um único lugar governado, ao lado do código-fonte e do CI.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/dependency-firewall/beta/" rel="">GitLab Dependency Firewall</a></td><td align="left">Acesso antecipado</td><td align="left">Defina regras que bloqueiam, colocam em quarentena ou avisam sobre pacotes arriscados antes que cheguem ao seu build.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/gitlab-secrets-manager/" rel="">GitLab Secrets Manager</a></td><td align="left">GA neste mês</td><td align="left">Restrinja segredos de build ao escopo do job e permite revogá-los com um clique.</td></tr><tr><td align="left"><a href="https://about.gitlab.com/pt-br/gitlab-security-standard/" rel="">GitLab Security Standard</a></td><td align="left">Disponível hoje</td><td align="left">Fortaleça sua fábrica de software em cinco etapas e deixe seus agentes conquistarem autonomia.</td></tr><tr><td align="left">Novos flows com Claude Mythos 5 e 5.1</td><td align="left">GA no próximo mês</td><td align="left">Encontre e corrija vulnerabilidades no GitLab Duo Agent Platform com novos flows de segurança.</td></tr></tbody></table><h2 id="orquestração-de-agentes-em-todo-o-ciclo-de-vida-do-software">Orquestração de agentes em todo o ciclo de vida do software</h2><p>Hoje, cada etapa do seu fluxo de trabalho agêntico ainda espera a aprovação de uma pessoa antes que a próxima comece.</p><p>Os <a href="https://about.gitlab.com/blog/gitlab-duo-cli-drives-automation/" rel="">fluxos orientados por objetivo</a> pegam um objetivo declarado e o executam de ponta a ponta — passando por revisão, testes, verificações de segurança e aprovações — a partir da Duo CLI, do modo headless ou do Agentic Chat. Os <a href="https://about.gitlab.com/blog/flow-creator-agent/" rel="">Custom Flows</a> permitem encadear agentes para seguir o processo que o seu time já usa. O <a href="https://docs.gitlab.com/user/project/integrations/gitlab_slack_application/#gitlab-duo" rel="">GitLab for Slack</a> inicia um flow a partir do canal onde a conversa já está acontecendo. O <a href="https://about.gitlab.com/pt-br/blog/new-mcp-tools-for-automation/" rel="">Servidor MCP</a> permite que aplicações de IA externas e agentes de programação acessem a sua instância do GitLab com segurança, sob a mesma política que os seus próprios agentes seguem.</p><p>Os <a href="https://about.gitlab.com/blog/optimize-with-open-weight-models/" rel="">modelos open-weight hospedados pelo GitLab</a>, incluindo o GLM 5.3, o Kimi K3 e o MiniMax 3, oferecem uma opção de menor custo quando uma carga de trabalho não exige um modelo de ponta. Com taxas de conclusão de tarefa parecidas, algumas combinações de modelos open-weight entregam até 8x mais chamadas de modelo por GitLab Credit, na comparação com seus equivalentes de ponta.</p><h2 id="dados-e-contexto-para-potencializar-o-raciocínio-humano-e-dos-agentes">Dados e contexto para potencializar o raciocínio humano e dos agentes</h2><p>Toda tarefa de agente começa recriando o mesmo contexto do zero, o que aumenta as tentativas repetidas e o uso de tokens. E sem uma visibilidade coerente sobre os custos e o ROI de IA, não dá para saber se o seu investimento está valendo a pena.</p><p>O <a href="https://about.gitlab.com/pt-br/gitlab-orbit/" rel="">GitLab Orbit</a>, o grafo de contexto de todo o seu ciclo de vida de software, aumenta a precisão dos agentes com até 45 vezes menos tentativas repetidas, reduzindo na prática o custo dos fluxos de trabalho agênticos com até 4,5x menos uso de tokens. Durante o seu período de beta, o Orbit já foi usado por mais de 3.500 organizações, rodando mais de 280.000 consultas.</p><p>O <a href="https://about.gitlab.com/pt-br/gitlab-duo-agent-platform/" rel="">Duo Agent Platform Impact Analytics</a> mostra o custo e o impacto do seu investimento em IA por time, tarefa e modelo. Os controles de crédito e uso permitem definir limites no nível da assinatura, do grupo ou do usuário, com alertas em 50%, 80% e 100% do gasto, e uma pausa automática assim que o limite definido é atingido.</p><h2 id="infraestrutura-de-devops-na-escala-dos-agentes">Infraestrutura de DevOps na escala dos agentes</h2><p>A maior parte do que é entregue não é código escrito pelo seu time — é montada a partir de pacotes open source, imagens base e bibliotecas puxadas de todo lugar. Quando cada time mantém o próprio registry, não existe um lugar único para confirmar o que de fato foi publicado ou entregue.</p><p>No último mês de junho, durante o Transcend em Londres, apresentamos a nossa solução de <a href="https://about.gitlab.com/pt-br/early-access-preview/next-gen-source-control/" rel="">gerenciamento de código-fonte de próxima geração</a>, que ajuda você a alcançar uma escala automatizada com os seus agentes de programação. O próximo problema das escalas automatizadas, porém, está na etapa seguinte ao código: o momento de criar um build.</p><p>O <a href="https://about.gitlab.com/pt-br/blog/transcend-artifact-central/" rel="">GitLab Artifact Central</a> substitui um registry separado por time por um único lugar para publicar e puxar pacotes, construído ao lado do seu código-fonte e dos seus pipelines de CI. Ele publica e puxa pacotes Maven, npm, Docker e OCI diretamente dos pipelines de CI, com PyPI e NuGet chegando na GA. O Artifact Central usa a mesma identidade e as mesmas permissões do seu código-fonte, com repositórios virtuais, autenticação nativa de CI/CD e procedência completa de build. Os primeiros resultados mostram um custo total de propriedade cerca de 50% menor, em comparação com ferramentas alternativas.</p><h2 id="governança-e-segurança-com-aplicação-centralizada">Governança e segurança com aplicação centralizada</h2><p>Os agentes puxam componentes de pacotes para o seu build na velocidade de máquina, o que torna impossível proteger manualmente tudo o que você entrega. Quando essa lacuna existe, você corre o risco de levar vulnerabilidades de segurança para a produção, em vez de pegá-las antes que afetem os clientes — e tem que responder por isso depois.</p><p>O <a href="https://about.gitlab.com/pt-br/dependency-firewall/beta/" rel="">GitLab Dependency Firewall</a>, agora em acesso antecipado, define regras sobre idade do pacote, gravidade da vulnerabilidade, detecção de pacotes maliciosos e conformidade de licença, com ações para bloquear, colocar em quarentena ou avisar, aplicadas diretamente nos registries que você já usa. Ele funciona nativamente com o GitLab Artifact Central, e é compatível com o JFrog Artifactory e o Sonatype Nexus Repository.</p><p>Com um número maior de builds, surge outro risco: agentes herdando segredos de build a partir de ambientes de desenvolvimento locais que ninguém protegeu, e usando esses segredos em pipelines de CI. O <a href="https://about.gitlab.com/pt-br/gitlab-secrets-manager/" rel="">GitLab Secrets Manager</a> mantém cada segredo em um único lugar, restrito ao job que precisa dele, com revogação em um clique para uma credencial vazada e uma economia de até 50% em comparação com manter um repositório seguro separado.</p><p>Os mesmos modelos de IA que permitem aos agentes escrever e entregar código na sua própria velocidade também tornam mais rápido e mais barato descobrir, conectar e explorar falhas já existentes. O <a href="https://about.gitlab.com/pt-br/gitlab-security-standard/" rel="">GitLab Security Standard</a> define cinco etapas para avaliar e reforçar a segurança do seu desenvolvimento de software agêntico: autorizar o acesso de cada agente, isolar workspaces e suas entradas, verificar os controles que avaliam o trabalho, liberar exatamente o que foi verificado e responder rapidamente quando existirem problemas — tudo isso construído sobre uma base de política, auditoria e responsabilidade. <a href="https://about.gitlab.com/pt-br/gitlab-security-standard/" rel="">Leia o padrão completo</a> para maior detalhamento.</p><p>Em breve, o Claude Mythos 5 e 5.1, da Anthropic, vão impulsionar os novos flows de segurança do GitLab Duo Agent Platform, ajudando organizações com ambientes aprovados a encontrar e corrigir vulnerabilidades mais rápido do que os atacantes conseguem descobri-las e explorá-las.</p><h2 id="como-comprar-com-o-gitlab-flex">Como comprar com o GitLab Flex</h2><p>A engenharia de software agêntica torna difícil prever, com seis meses de antecedência, o headcount, o consumo de créditos e as novas capacidades que você vai precisar. O <a href="https://about.gitlab.com/pt-br/gitlab-flex/" rel="">GitLab Flex</a> é um compromisso anual único que cobre as novas capacidades do GitLab assim que elas são lançadas, sem precisar de novos contratos de compra. Ele permite que os times reorganizem o gasto com licenças e IA por meio de GitLab Credits, mês a mês, à medida que as necessidades mudam.</p><h2 id="por-onde-começar">Por onde começar</h2><ul><li>Ative o <a href="https://about.gitlab.com/pt-br/gitlab-duo-agent-platform/" rel="">GitLab Duo Agent Platform</a>: clientes já existentes começam hoje mesmo, com créditos já incluídos na assinatura, e todo novo teste do GitLab inclui 30 dias de acesso. Para aumentar a eficiência dos seus agentes, ative o beta do <a href="https://about.gitlab.com/pt-br/gitlab-orbit/" rel="">GitLab Orbit</a> para o GitLab.com.</li><li><a href="https://about.gitlab.com/pt-br/gitlab-security-standard/" rel="">Adote o GitLab Security Standard</a>: o GitLab Ultimate está disponível em teste gratuito. Um <a href="https://docs.gitlab.com/ci/secrets/secrets_manager/credit_usage/#start-a-trial" rel="">teste do Secrets Manager</a> está disponível para clientes Ultimate e Premium. O <a href="https://about.gitlab.com/pt-br/blog/transcend-artifact-central/" rel="">GitLab Artifact Central</a> está aberto em beta, e você pode solicitar acesso antecipado ao <a href="https://about.gitlab.com/pt-br/dependency-firewall/beta/" rel="">Dependency Firewall</a>.</li><li>Aproveite melhor cada real investido com o <a href="https://about.gitlab.com/pt-br/gitlab-flex" rel="">GitLab Flex</a>: um compromisso anual único para as novas inovações do GitLab, sem precisar de uma nova contratação — com a possibilidade de reorganizar o gasto com licenças e GitLab Credits mês a mês.</li><li><a href="https://about.gitlab.com/pt-br/compare/gitlab-vs-github/" rel="">Se você está migrando do GitHub</a>, faça isso do seu jeito por meio de ferramentas de migração dedicadas, serviços de migração personalizados e uma oferta exclusiva: um ano de GitLab gratuito ao fechar um contrato de três anos.</li></ul><p>E se você já está pronto para começar a construir, participe do &quot;<a href="https://gitlab-transcend.devpost.com/" rel="">Life after code: the path to production at the speed of imagination</a>&quot;, o nosso hackathon de três semanas em parceria com a Anthropic e o Google Cloud.</p><p>Onde quer que você comece, o destino é o mesmo: a base de uma fábrica de software com governança, em que os agentes aceleram o trabalho e cada mudança permanece confiável.</p><p>Estamos ansiosos para ver o que você vai construir a seguir.</p>]]></content>
        <author>
            <name>Manav Khurana</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/manav-khurana/</uri>
        </author>
        <published>2026-10-06T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[Dependency Firewall: bloqueie pacotes arriscados antes do build]]></title>
        <id>https://about.gitlab.com/pt-br/blog/transcend-dependency-firewall/</id>
        <link href="https://about.gitlab.com/pt-br/blog/transcend-dependency-firewall/"/>
        <updated>2026-10-06T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>Pacotes maliciosos podem aparecer disfarçados como pacotes confiáveis. Por exemplo, em junho de 2026, <a href="https://about.gitlab.com/pt-br/blog/gitlab-discovers-widespread-npm-supply-chain-attack/" rel="">pesquisadores do GitLab encontraram cinco pacotes maliciosos no PyPI</a>, quatro deles typosquats do Flask, Requests e NumPy, que são executados no momento da instalação e roubam credenciais de CI/CD. E isso importa, já que agentes de IA agora adicionam dependências de código aberto por conta própria, muitas vezes sem revisão, e os desenvolvedores perdem a visibilidade sobre quais pacotes podem contaminar o build.</p><p>Essa combinação abre uma brecha real: um pacote malicioso ou vulnerável pode entrar no seu build sem autorização. Uma vez lá dentro, o código desse pacote roda com o mesmo acesso que o seu pipeline tem, e a partir daí consegue alcançar qualquer sistema que os seus pipelines de desenvolvimento tocam.</p><p>O <a href="https://about.gitlab.com/pt-br/dependency-firewall/beta/" rel="">GitLab Dependency Firewall</a>, apresentado hoje no Transcend em acesso antecipado, bloqueia pacotes que conflitam com a sua política — maliciosos, vulneráveis ou fora de conformidade — antes que eles cheguem ao seu build. Com a governança embutida, a ferramenta impede o risco antes mesmo da instalação, o que libera o seu time do processo de rastrear, remover ou refazer o que uma política bloqueia. Desenvolvedores e seus agentes continuam puxando as dependências de que precisam sem esperar por uma revisão manual de segurança, e os pacotes que atendem à sua política passam a fazer parte do seu build oficial.</p><h2 id="bloqueie-pacotes-maliciosos-sem-quebrar-o-seu-build">Bloqueie pacotes maliciosos sem quebrar o seu build</h2><p>Sem uma política no momento da instalação, um pacote problemático entra no build primeiro e só é pego depois. A análise de composição de software (Software composition analysis - SCA) verifica o que você já trouxe para o projeto — então, quando ela sinaliza um pacote malicioso, uma vulnerabilidade de alta gravidade ou uma licença que o seu time jurídico não aceita, a dependência já está instalada e pode até já ter sido entregue dentro de um artefato. Rastrear até onde ela foi, removê-la e reconstruir o build transforma uma execução de rotina do pipeline em um trabalho extra e não planejado para o seu time de engenharia.</p><p>Com o Dependency Firewall, você decide o que pode entrar nos seus builds antes mesmo da instalação, definindo políticas para:</p><ol><li><strong>Status malicioso</strong> — pacotes sinalizados no <a href="https://docs.gitlab.com/user/application_security/gitlab_advisory_database/#gitlab-malware-advisories" rel="">banco de dados de avisos de malware do GitLab</a></li><li><strong>Gravidade da vulnerabilidade</strong> — a gravidade que você define (crítica, alta, média ou baixa) e quantas ocorrências você permite nesse nível, incluindo zero</li><li><strong>Tipo de licença</strong> — quais licenças você permite ou recusa, listadas pelo nome completo, e como tratar pacotes cuja licença não pode ser identificada</li><li><strong>Idade do pacote</strong> — a idade mínima que um pacote precisa ter antes de entrar em um build, para que uma versão publicada minutos atrás não entre direto sem que ninguém a tenha analisado</li></ol><p>Colocar essa política em prática não precisa colocar a sua entrega em risco. Comece no modo de aviso: o firewall registra o que uma política capturaria, mas deixa o build seguir normalmente. Ele grava um evento de auditoria, uma entrada no dashboard e uma linha no resumo do CI, para que você possa avaliar se vale a pena bloquear o build ou não.</p><p>Depois que você confiar nas políticas, mude para o modo de bloqueio: o pipeline para assim que encontra uma correspondência e mostra o motivo. Quando alguém realmente precisa liberar um pacote já aprovado, um bypass registrado permite que um usuário ou token autorizado prossiga — tudo fica no histórico.</p><p><img alt="Aplicação de políticas de segurança" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791198870/smilnde9xskkyon7rzyn.jpg" title="Aplicação de políticas de segurança" /></p><h2 id="defina-a-política-uma-vez-ou-personalize-por-time">Defina a política uma vez ou personalize por time</h2><p>Um firewall que só atua no nível do registro dá a mesma política para todo mundo, mas isso raramente combina com a forma como os times realmente trabalham. Um serviço de pagamentos e um protótipo interno carregam perfis de risco bem diferentes, e um único conjunto de regras para todo o registro não consegue exigir mais de um do que do outro.</p><p>Com o Dependency Firewall, você define uma política no grupo de nível superior, e todo projeto abaixo dele herda as mesmas regras. Quando um time precisa de algo diferente, você pode definir uma política específica para aquele grupo ou projeto.</p><p>É possível aplicar a regra no nível do registro e governar toda a organização a partir de uma única plataforma, sem abrir mão da possibilidade de apertar as regras onde o risco é maior. As regras vivem como código em um projeto de política de segurança, então são revisadas e alteradas por meio de uma merge request, como o resto da sua configuração. Elas são herdadas do grupo de nível superior até serem passadas para cada projeto, e, quando as regras se sobrepõem, vale a mais restritiva. Um serviço crítico pode ficar acima da régua-base da organização, e nenhum projeto fica abaixo dela.</p><p><img alt="Nova política do dependency firewall" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791198870/aykp66qb64pskauvzbmm.jpg" title="Nova política do dependency firewall" /></p><h2 id="verifique-um-pacote-antes-de-trazê-lo-para-o-projeto">Verifique um pacote antes de trazê-lo para o projeto</h2><p>Um desenvolvedor — ou um agente realizando o trabalho — geralmente só descobre que um pacote não é permitido quando o pipeline falha. Isso custa um ciclo inteiro de build e quebra a concentração bem na hora em que o trabalho está fluindo.</p><p>Com o GitLab Dependency Firewall, você já sabe a resposta antes de adicionar uma dependência, direto no lugar onde já está trabalhando — e consegue escolher um pacote que passa de primeira.</p><p>Usando a GitLab CLI no terminal ou em um script, uma verificação por linha de comando já diz se um pacote vai passar ou ser bloqueado pela sua política, sem que o desenvolvedor precise abrir um console separado. Ela cobre gerenciadores de pacotes comuns, como npm, pip, Poetry, Maven, Gradle e Bundler, com mais integrações a caminho.</p><p><img alt="Use a linha de comando para identificar se um pacote vai passar ou ser bloqueado pela sua política" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791198870/itqcvrmp8gvw1phihd2l.jpg" title="Use a linha de comando para identificar se um pacote vai passar ou ser bloqueado pela sua política" /></p><h2 id="veja-e-comprove-cada-decisão">Veja e comprove cada decisão</h2><p>Um líder de segurança precisa conseguir provar o que um controle está fazendo durante uma auditoria. Um controle que bloqueia silenciosamente, sem deixar registro, não responde à pergunta do auditor e não constrói confiança com os times que ele governa.</p><p>Você tem uma visão única de tudo o que o firewall já permitiu, avisou e bloqueou, com um registro imutável de cada decisão que pode ser entregue a um auditor.</p><p>O dashboard do Dependency Firewall mostra a atividade e os resultados de todos os projetos dentro do escopo definido. Cada aviso, bloqueio ou bypass gera um evento de auditoria que registra a regra correspondente, a política por trás dela e o pacote envolvido.</p><p><img alt="Dashboard do Dependency Firewall" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791198871/oiieystaargq3ctrqfs1.jpg" title="Dashboard do Dependency Firewall" /></p><h2 id="tenha-acesso-antecipado-ao-gitlab-dependency-firewall">Tenha acesso antecipado ao GitLab Dependency Firewall</h2><p>Agora você pode travar pacotes maliciosos, vulneráveis ou fora de conformidade antes que cheguem a um build. A solução é compatível com o <a href="https://about.gitlab.com/pt-br/blog/transcend-artifact-central/" rel="">GitLab Artifact Central</a> e com registros externos do Sonatype Nexus Repository e do JFrog Artifactory, e não exige manter uma ferramenta separada ao lado da sua implantação do GitLab. O Dependency Firewall já está em acesso antecipado para clientes GitLab.com e GitLab Self-Managed nos planos Premium ou Ultimate. <a href="https://about.gitlab.com/pt-br/dependency-firewall/beta/" rel="">Solicite seu acesso antecipado agora mesmo!</a></p>]]></content>
        <author>
            <name>Alisa Ho</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/alisa-ho/</uri>
        </author>
        <author>
            <name>Amit Shalem</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/amit-shalem/</uri>
        </author>
        <published>2026-10-06T00:00:00.000Z</published>
    </entry>
    <entry>
        <title type="html"><![CDATA[GitLab Artifact Central: entregue certo na primeira vez]]></title>
        <id>https://about.gitlab.com/pt-br/blog/transcend-artifact-central/</id>
        <link href="https://about.gitlab.com/pt-br/blog/transcend-artifact-central/"/>
        <updated>2026-10-06T00:00:00.000Z</updated>
        <content type="html"><![CDATA[<p>Todo build de software é montado a partir de pacotes open source, imagens base e bibliotecas, com o seu código por cima. Quando um desses componentes falta ou tem um comportamento diferente do esperado, o build falha. Quando o desenvolvimento acontece na velocidade dos agentes, essas falhas se multiplicam, e nenhum time consegue mais resolvê-las como exceções manuais.</p><p>A proliferação dos registries de cada projeto só piora o quadro, porque as regras de retenção, os limites de armazenamento e o acesso de publicação vivem separados dentro de cada um deles. Esse design por projeto funciona quando uma pessoa configura cada registry manualmente, mas quebra quando agentes rodam continuamente em centenas de projetos.</p><p>Hoje, no GitLab Transcend, anunciamos o GitLab Artifact Central: um único registry no nível da organização que substitui centenas de registries no nível de projeto, de forma que todo pull ou publish feito por uma pessoa ou por um agente passe pela mesma porta de entrada controlada, permitindo que os times de plataforma desenvolvam o software certo desde a primeira vez.</p><p>Veja a seguir por que desenvolvemos o Artifact Central e como ele pode ajudar o seu time.</p><iframe src="https://player.vimeo.com/video/1230298162?title=0&amp;byline=0&amp;portrait=0&amp;badge=0&amp;autopause=0&amp;player_id=0&amp;app_id=58479" frameBorder="0" allow="autoplay; fullscreen; picture-in-picture; clipboard-write; encrypted-media; web-share" referrerPolicy="strict-origin-when-cross-origin" style="position:absolute;top:0;left:0;width:100%;height:100%;" title="GL_Artifact Central 1_092226_v4"></iframe><script src="https://player.vimeo.com/api/player.js"></script><h2 id="defina-a-política-uma-vez-aplique-em-todo-lugar">Defina a política uma vez, aplique em todo lugar</h2><p>No GitLab, as regras de retenção, os limites de armazenamento e quem pode publicar vivem dentro do registry de pacotes e contêineres gratuito de cada projeto, configurados de forma isolada. O GitLab Artifact Central leva essa tarefa um nível acima. Os times atribuem regras de retenção, configurações de cota e políticas de acesso uma única vez, no nível da organização, em vez de recriá-las em cada projeto abaixo dela.</p><p>Todo repositório vem fechado por padrão: ser membro da organização é o portão, não a chave. Isto é, fazer parte da organização sozinho não libera nenhum repositório até que uma permissão para esse acesso seja concedida. Criamos quatro papéis específicos para artefatos: Admin, Manager, Contributor e Viewer. Esses papéis ficam separados dos papéis de projeto que já existem no GitLab, então dar acesso a alguém em um repositório nunca afeta ou altera os privilégios dessa pessoa em nenhum outro lugar.</p><h2 id="uma-única-url-para-publicar-fazer-proxy-ou-os-dois">Uma única URL para publicar, fazer proxy ou os dois</h2><p>Em vez de navegar por uma página de wiki interna explicando onde está cada componente, os desenvolvedores apontam uma única URL para tudo. O GitLab Artifact Central faz isso por meio de três tipos de repositório:</p><ul><li><strong>Hosted —</strong> os pacotes e imagens privados que os seus times constroem e publicam.</li><li><strong>Remote —</strong> um proxy na frente de uma fonte externa, como o Docker Hub ou o Maven Central, com a conexão testada antes que qualquer coisa dependa dela.</li><li><strong>Virtual —</strong> um único endpoint que reúne repositórios hosted e remote. O GitLab verifica primeiro o repositório hosted, e só depois recorre à fonte remote. O primeiro pull externo fica em cache, então os pulls seguintes vêm direto do GitLab, sem precisar se conectar à internet.</li></ul><p>Os repositórios virtuais importam especialmente para os times que comparam o GitLab com outras soluções de gestão de artefatos. Eles dão aos desenvolvedores a experiência familiar de um único endpoint, sem que precisem pensar onde o artefato realmente está. Ou seja, tenha sido construído internamente ou puxado de um registry externo, o desenvolvedor solicita da mesma forma. Durante o período de beta, o Artifact Central é compatível com Maven, npm, Docker e OCI, com mais formatos a caminho.</p><p><img alt="Artifact Central" src="https://res.cloudinary.com/about-gitlab-com/image/upload/v1791239267/zfd9zisjm0gqkj5relb9.png" title="Artifact Central" /></p><h2 id="rastreie-qualquer-coisa-de-volta-à-origem-automaticamente">Rastreie qualquer coisa de volta à origem, automaticamente</h2><p>Aqui está a parte difícil de replicar fora do GitLab: todo artefato publicado pelo GitLab Artifact Central carrega a sua procedência de build automaticamente, ou seja, qual pipeline o construiu, de qual branch e commit ele veio e quem disparou o job. Como é a mesma plataforma que rodou o build, o registry já sabe disso.</p><p>A autenticação funciona da mesma forma. Publicar e puxar pacotes usa o <code>CI_JOB_TOKEN</code>, a identidade que os seus pipelines já têm, tanto para pessoas quanto para agentes. Um agente que publica ou puxa pacotes por meio de pipelines de CI usa exatamente esse mesmo job token, e não uma conta de serviço integrada por fora, com permissões separadas. Com um registry independente, rastrear um artefato até a sua origem significa correlacionar IDs manualmente entre o seu sistema de CI e o seu registry, usando um script que alguém precisa manter. Com o Artifact Central, o pipeline, a branch, o commit e o job já vêm anexados ao próprio artefato.</p><h2 id="responda-o-que-publicamos-em-segundos">Responda &quot;o que publicamos?&quot; em segundos</h2><p>O Artifact Central vive na mesma plataforma que o seu código, suas merge requests e seus pipelines, então os artefatos publicados a partir do CI carregam sua procedência de build: o pipeline que os construiu, o commit e quem os publicou.</p><p>Em breve, planejamos conectar isso em toda a sua organização por meio do <a href="https://about.gitlab.com/pt-br/gitlab-orbit/" rel="">GitLab Orbit</a>, de forma que &quot;quais dos meus serviços em produção são afetados por essa vulnerabilidade?&quot; vire uma pergunta com uma resposta só ao invés de uma busca manual em quatro ou cinco ferramentas diferentes.</p><h2 id="combine-o-artifact-central-com-o-dependency-firewall">Combine o Artifact Central com o Dependency Firewall</h2><p>O <a href="https://about.gitlab.com/pt-br/blog/transcend-dependency-firewall/" rel="">GitLab Dependency Firewall</a>, um produto separado do GitLab, disponível em acesso antecipado para clientes Premium e Ultimate, já funciona de forma nativa com o Artifact Central. Com o Dependency Firewall, você consegue barrar pacotes arriscados antes mesmo de eles chegarem a um build. Você adiciona essa verificação a cada pipeline usando a CLI <code>glab</code>, então a cobertura acontece pipeline a pipeline, não importa qual gerenciador de pacotes os seus times usem. Em seguida, planejamos permitir uma integração ainda mais estreita entre as duas ferramentas, de forma que uma única política para toda a sua organização bloqueie pacotes arriscados por vulnerabilidade, licença ou idade do pacote, no exato momento em que são puxados.</p><h3 id="dois-benefícios-do-mesmo-registry">Dois benefícios do mesmo registry</h3><p>Veja como isso funciona na prática para dois perfis: o desenvolvedor que entrega o código e o time de plataforma que garante que tudo se sustente.</p><p><strong>Um desenvolvedor publicando a partir do CI.</strong> O seu pipeline publica um artefato Maven usando o job token que ele já tem, sem nenhum segredo novo para gerenciar. Se esse mesmo desenvolvedor precisar de um pacote interno ao lado de algo vindo do Maven Central, basta apontar para uma única URL de repositório virtual e deixar que o GitLab Artifact Central descubra onde cada um realmente reside.</p><p><strong>Um time de plataforma definindo a política uma única vez.</strong> Em vez de configurar regras em centenas de projetos separados, um admin define cotas de armazenamento e regras de acesso a repositórios no nível da organização, uma única vez — e todo repositório abaixo dela herda essa configuração. Quando alguém pergunta quanto e onde a empresa está armazenando, existe um único dashboard com a resposta.</p><h3 id="migrando-os-seus-artefatos">Migrando os seus artefatos</h3><p>A maioria das empresas não está começando do zero, e trocar de registry de uma hora para outra não é factível. Com o GitLab Artifact Central, você pode adicionar os seus repositórios existentes como remote por trás de um repositório virtual, de forma que os desenvolvedores apontem para uma única URL e os artefatos só migrem quando um build realmente pedir por eles. Não é preciso fazer cópias em massa, reservar uma janela de migração no fim de semana, nem mover petabytes de dados pela sua rede.</p><p>O seu registry antigo continua sendo o sistema de registro oficial. E quando tudo estiver pronto, é possível converter esse remote em um repositório hosted no Artifact Central. A sua migração fica mais segura e gradual.</p><h2 id="experimente-o-artifact-central-de-graça-em-beta">Experimente o Artifact Central, de graça em beta</h2><p>O GitLab Artifact Central já está disponível hoje em beta para o GitLab.com, com disponibilidade no GitLab Self-Managed prevista para ainda este mês. Não há cobrança durante o período de beta ou funções a serem adquiridas. Estamos acompanhando o uso para moldar os preços antes da disponibilidade geral, e vamos compartilhar os detalhes nessa hora.</p><h3 id="ajude-a-gente-a-continuar-construindo-o-gitlab-artifact-central">Ajude a gente a continuar construindo o GitLab Artifact Central</h3><p>Nada disso estaria onde está sem os nossos parceiros de design, que já estão rodando o Artifact Central com fluxos de trabalho reais há semanas. O feedback deles já moldou o que está sendo lançado hoje, e o seu feedback vai moldar o que vem a seguir.</p><p>Não é preciso convite para participar do beta do Artifact Central — <a href="https://about.gitlab.com/pt-br/artifact-central/" rel="">basta se inscrever no nosso site</a>, e alguém do nosso time entrará em contato para ativar o recurso na sua conta. Se você ainda não tem uma conta no GitLab, também pode <a href="https://about.gitlab.com/pt-br/artifact-central/" rel="">se inscrever</a> para o beta. Após isso, alguém do nosso time falará com você.</p><p>Mal podemos esperar para ver o que você vai construir.</p><blockquote><p>Assista à <a href="https://about.gitlab.com/pt-br/events/transcend/virtual/" rel="">gravação do nosso evento Transcend</a> para ver demonstrações dos novos recursos da plataforma e entender o que é preciso para levar a velocidade da IA agêntica a todo o ciclo de vida do software.</p></blockquote>]]></content>
        <author>
            <name>Corinne Dent</name>
            <uri>https://about.gitlab.com/pt-br/blog/authors/corinne-dent/</uri>
        </author>
        <published>2026-10-06T00:00:00.000Z</published>
    </entry>
</feed>